GPT-6.2 Astra und Sol machen Modell-Routing zur Kostenfrage
OpenAIs neue Modelle Astra und Sol teilen anspruchsvolle professionelle Arbeit und alltägliche Agentenaufgaben auf. Entscheidend ist nicht das stärkste Modell, sondern wo Qualität, Latenz, Caching und Prüfaufwand den Einsatz jeweils rechtfertigen.

Was GPT-6.2 für Käufer tatsächlich verändert
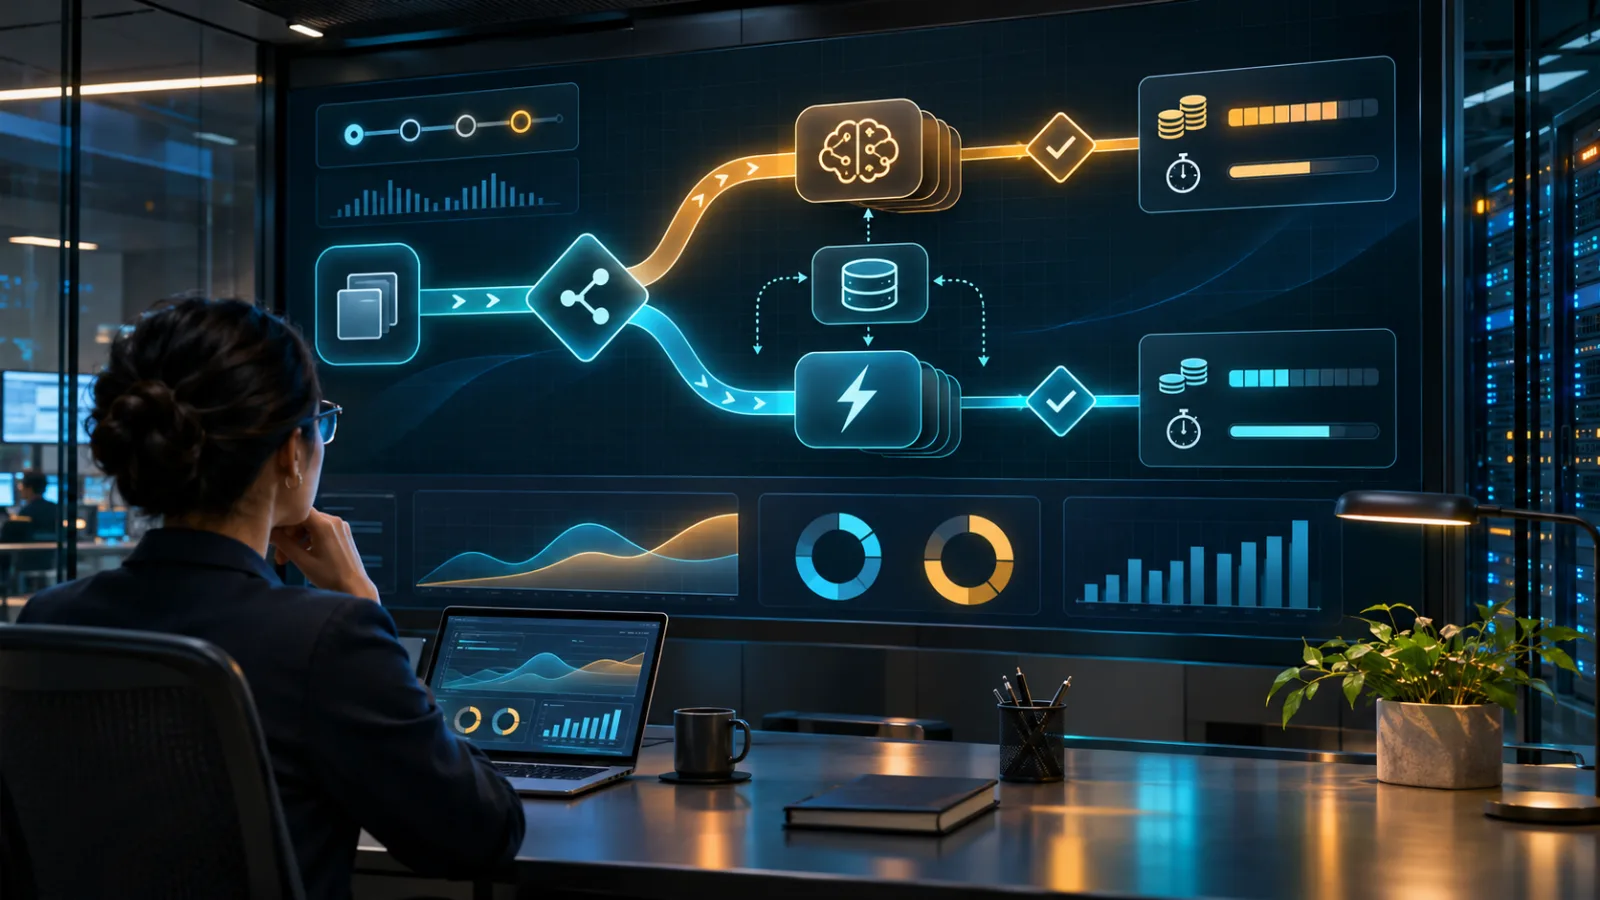
Der Start von GPT-6.2 durch OpenAI lässt sich besser als operative Aufteilung denn als Wettbewerb um das stärkste Modell verstehen. GPT-6.2 Astra ist für die anspruchsvollsten professionellen Aufgaben vorgesehen, während GPT-6.2 Sol als schnellerer und kostengünstigerer Standard für alltägliche Agentenaufgaben dient. Diese Unterscheidung ist wichtig, weil die Modellwahl nicht mehr nur eine Frage der Antwortqualität ist. Sie wird zu einer Einkaufs- und Workflow-Entscheidung: Welche Anfragen benötigen das stärkere Modell, welche kann das günstigere übernehmen, und wie viel Prüfung ist erforderlich, wenn das Modell über Tools handelt oder Ergebnisse erzeugt, die nachgelagert verwendet werden?
Die Preise machen diese Aufteilung konkret. Astra kostet 8 $ pro eine Million Eingabetokens, 0,40 $ pro eine Million gecachter Eingabetokens und 40 $ pro eine Million Ausgabetokens. Sol kostet 2 $ pro eine Million Eingabetokens, 0,10 $ pro eine Million gecachter Eingabetokens und 10 $ pro eine Million Ausgabetokens. Bei nicht gecachtem Input und Output ist Astra viermal so teuer wie Sol. Dasselbe Verhältnis von vier zu eins gilt für die angegebenen Tarife für gecachte Eingaben und Ausgaben. Ein Team, das jede Anfrage an Astra schickt, trifft also bewusst einen Kompromiss zwischen Qualität und Kosten – selbst dann, wenn die Aufgabe die höhere Leistungsgrenze von Astra gar nicht erfordert.
Das bedeutet nicht, dass Sol einfach ein günstiger Ersatz für Astra ist. Der praktische Unterschied liegt darin, ob eine Aufgabe ein eher routinemäßiges Betriebsprofil verträgt. Sol ist der sinnvolle Ausgangspunkt für Arbeit mit klaren Abnahmekriterien, wiederholbaren Eingaben und begrenzter Mehrdeutigkeit: Entwürfe, Extraktion, routinemäßige Programmierung und andere mehrstufige Workflows, bei denen sich die Aktionen des Agenten ohne spezialisiertes Urteil überprüfen lassen. In solchen Fällen kann ein niedrigerer Preis pro Token wichtiger sein als geringfügige Verbesserungen, die sich nur schwer messen lassen oder am Endergebnis nichts ändern.
Astra wird wirtschaftlich vertretbar, wenn die Fehlerkosten den Preisunterschied zwischen den Modellen übersteigen. Das kann der Fall sein, wenn das Ausgangsmaterial mehrdeutig ist, die Aufgabe komplexes Design oder professionelles Urteilsvermögen erfordert oder das Ergebnis eine wichtige nächste Handlung bestimmt. Es kann auch passieren, wenn ein Fehler den Agenten in eine teure oder zeitaufwendige Wiederherstellungsschleife schickt. Der relevante Vergleich lautet daher nicht abstrakt „Astra gegen Sol“. Entscheidend sind die zusätzlichen Modellkosten im Verhältnis zu den erwarteten Kosten für Korrektur, Verzögerung, Nacharbeit oder menschliches Eingreifen.
Diese Perspektive verändert auch, wie Käufer Leistungsangaben lesen sollten. Eine Benchmark-Rangliste kann zeigen, dass ein Modell bei einer Klasse von Evaluierungen leistungsfähiger ist, aber sie entscheidet nicht, wo diese Fähigkeit in einem Produktionssystem eingesetzt werden sollte. Ein Workflow kann mehrere klar getrennte Aufgaben mit unterschiedlichen Risikoprofilen enthalten. Die ursprüngliche Anfrage kann routinemäßig sein, während eine mehrdeutige Ausnahme eine Eskalation erfordert. Ein Team, das die Modell-ID als dauerhaft globale Einstellung behandelt, vergibt die Chance, Ausgaben und Folgen aufeinander abzustimmen. Wer dagegen jede schwierig wirkende Anfrage an Astra weiterleitet, gewinnt möglicherweise eine Sicherheitsmarge, kann ein Premium-Modell aber auch ohne Beleg dafür, dass die zusätzliche Fähigkeit die Ergebnisse verbessert, zum teuren Standard machen.
Die erste operative Frage lautet daher nicht, welches Modell das aktuelle ersetzen soll. Es geht darum, welche Arbeit welchem Pfad zugewiesen wird. Sol kann die vorhersehbare Basis übernehmen: strukturierte Umwandlungen, erste Entwürfe, standardisierte Extraktion und Agentenroutinen mit klaren Tests. Astra kann für qualitätssensible Aufgaben reserviert bleiben, bei denen Unsicherheit, professionelle Komplexität oder die Schwere eines Fehlers die zusätzlichen Kosten rechtfertigen. Diese Aufteilung ist besonders für Teams nützlich, die Agenten entwickeln, denn die Kosten eines Agenten beschränken sich nicht auf eine einzelne Antwort. Ein Workflow kann wiederholten Kontext, Tool-Aufrufe, Wiederholungsversuche und prüfbedürftige Ausgaben umfassen. Das am Einstiegspunkt ausgewählte Modell kann die Kosten des gesamten Durchlaufs beeinflussen.
Der Preisabstand liefert Teams außerdem einen praktischen Grund, das Routing zu messen, statt sich auf Intuition zu verlassen. Für jeden Workflow können Käufer fragen, wie oft Sol die Aufgabe ohne Korrektur abschließt, wie oft eine Anfrage eskaliert werden muss und ob Astra die Prüfzeit oder die Schwere von Fehlern tatsächlich reduziert. Diese Beobachtungen machen die Modellwahl zu einer Betriebsrichtlinie statt zu einer Präferenz. Wenn ein routinemäßiger Workflow mit Sol dasselbe akzeptierte Ergebnis liefert, ist der günstigere Pfad die bessere Geschäftsentscheidung. Wenn wenige schwierige Fälle unverhältnismäßig viel Nacharbeit verursachen, lassen sich diese Fälle isolieren und an Astra senden, ohne die gesamte Arbeitslast zu verlagern.
GPT-6.2 verändert das Beschaffungsproblem daher auf eine sehr konkrete Weise: Leistungsfähigkeit wird nun mit Aufgabenteilung verbunden. Astra bietet einen Premium-Pfad für anspruchsvolle professionelle Arbeit, Sol einen schnelleren und günstigeren Weg für gewöhnliche Agentenaufgaben. Der Wert entsteht, wenn Arbeit bewusst zugewiesen wird, die Gründe für Eskalationen festgehalten werden und die Modellkosten den Folgen möglicher Fehler gegenübergestellt werden. Der nächste Schritt besteht darin, diese Routing-Regeln festzulegen, bevor eine Modell-ID geändert wird. So kann das System zwischen routinemäßigem Volumen und Fällen unterscheiden, in denen sich stärkeres Schlussfolgern bezahlt macht.
Erstellen Sie eine Routing-Policy, bevor Sie die Modell-ID ändern
Die Entscheidung zwischen GPT-6.2 Sol und GPT-6.2 Astra sollte bei der Aufgabe beginnen, nicht bei einer allgemeinen Rangliste der Modellqualität. Entscheidend ist, was schiefgehen kann, wie unsicher die Aufgabe ist und wie viele Tool-Aufrufe der Ablauf voraussichtlich erfordert. Sol ist eine sinnvolle Wahl für Entwürfe, Extraktion, routinemäßige Programmierung und wiederholbare mehrstufige Arbeit, wenn sich das erwartete Ergebnis anhand klarer Abnahmetests prüfen lässt. In solchen Fällen kauft das Team Geschwindigkeit und geringere Kosten für einen klar begrenzten Vorgang – es verlangt vom Modell nicht, eine offene Ermessensentscheidung zu lösen.
Diese Unterscheidung ist wichtig, weil ein Workflow anspruchsvoll wirken kann und dennoch stark standardisiert ist. Ein Agent, der Felder aus bekannten Dokumenttypen sammelt, anhand einer stabilen Vorlage einen ersten Entwurf erstellt oder eine definierte Code-Transformation anwendet, kann mehrere Tools aufrufen, ohne den leistungsfähigeren Pfad zu benötigen. Seine Zuverlässigkeit beruht auf begrenzten Eingaben, vorhersehbaren Schritten und einem Test, der ein schlechtes Ergebnis zurückweisen kann. Jede solche Anfrage an Astra zu senden, kann zwar die Wahrscheinlichkeit eines einzelnen Fehlers senken. Ohne Belege dafür, dass die zusätzliche Leistungsfähigkeit nötig ist, kann daraus aber auch ein dauerhaft höherer Betriebsaufwand werden.
Astra gehört auf den Eskalationspfad, wenn die Fehlerkosten höher sind als die Kosten einer zusätzlichen Modellnutzung. Dazu zählen mehrdeutiges Ausgangsmaterial, finanzielle oder rechtliche Beurteilungen sowie komplexe Designarbeit, bei denen eine oberflächlich plausible Antwort gefährlicher sein kann als ein offensichtlicher Fehlschlag. Ebenfalls darunter fallen Aufgaben mit schwer vorhersehbarer Tool-Abfolge oder Anforderungen, die sich nicht durch einen einfachen Abnahmetest abbilden lassen. Der entscheidende Auslöser ist nicht, dass eine Anfrage wichtig klingt. Maßgeblich ist, dass Unsicherheit, Tragweite oder die nötige Fehlerbehebung den günstigeren Weg als erste Wahl unvertretbar machen.
Teams sollten diese Auslöser festlegen, bevor sie in der Produktion eine Modell-ID ändern. Eine einfache Routing-Policy kann jede Aufgabe anhand von drei Dimensionen einordnen: Tragweite, Unsicherheit und erwartete Tool-Tiefe. Die Tragweite fragt, was passiert, wenn das Ergebnis falsch ist. Die Unsicherheit betrifft die Frage, ob Eingaben, Anweisungen oder gewünschtes Ergebnis mehrdeutig sind. Die Tool-Tiefe beschreibt, wie viele voneinander abhängige Schritte der Agent möglicherweise benötigt und wie stark sich ein früher Fehler auf spätere Aktionen auswirken kann. Eine Aufgabe mit niedrigen Werten in allen drei Dimensionen kann bei Sol bleiben. Eine Aufgabe mit einem hohen Wert in nur einer Dimension kann Astra, einen manuellen Prüfschritt oder beides erfordern.
Die Policy sollte außerdem festlegen, was nach einer Eskalation geschieht. Astra ersetzt keinen Abnahmetest, und ein leistungsfähigeres Modell macht einen unklaren Prozess nicht messbar. Für jeden Pfad sollten das erforderliche Ausgabeformat, die zu erfüllenden Prüfungen, die vom Agenten verwendbaren Tools und der Punkt festgelegt werden, an dem eine Person das Ergebnis freigeben muss. Wenn ein Vorgang eine folgenschwere Entscheidung oder eine externe Aktion beeinflussen kann, sollte der Workflow diese Freigabegrenze auch dann beibehalten, wenn die Anfrage an Astra gesendet wird. Das Routing bestimmt, welches Modell die Arbeit übernimmt; es entbindet die Organisation nicht von ihrer Verantwortung, das Ergebnis zu prüfen.
Halten Sie schließlich fest, warum Anfragen eskaliert werden. Nützliche Gründe sind mehrdeutige Belege, größere Tragweite, fehlgeschlagene Sol-Prüfungen, unerwartet hohe Tool-Tiefe oder die Einschätzung eines Prüfers, dass die Aufgabe eine gründlichere Analyse erfordert. Diese Aufzeichnungen machen aus Routing mehr als eine Sammlung von Bauchentscheidungen: Sie bilden einen operativen Datensatz. Nach einem Pilotprojekt kann das Team erkennen, welche Eskalationen gerechtfertigt waren, welche Sol-Fehler sich beheben ließen und welche Kategorien routinemäßig als zu schwierig eingestuft wurden. Ziel ist weder, das günstigere Modell um jeden Preis auszulasten, noch Astra nur für die dramatischsten Fälle aufzuheben. Die Wahl soll nachvollziehbar, wiederholbar und an das tatsächliche Fehlermuster jedes Workflows anpassbar sein.
Caching und Hintergrundläufe verändern die Kostenrechnung
Beim Modell-Routing ist die Arbeit nicht beendet, sobald ein Team Astra für anspruchsvolle Aufgaben und Sol für Routineaufgaben auswählt. Schon die Form des Prompts kann darüber entscheiden, ob diese Wahl wirtschaftlich bleibt. GPT-6.2 verbessert die Wiederverwendung von Prompt-Caches und macht sie damit zu einer operativen Größe statt zu einem reinen Implementierungsdetail. OpenAI empfiehlt, stabiles Material an den Anfang des Prompts zu setzen und veränderliche Anweisungen danach anzuhängen. Bei einem Agenten, der wiederholt dieselben Systemvorgaben, Tool-Definitionen, Richtlinientexte oder Workflow-Kontexte erhält, erhöht diese Struktur die Chance, dass der Cache den wiederverwendbaren Präfix erkennt.
Die praktische Konsequenz ist klar: Ein langer Prompt sollte nicht so neu aufgebaut werden, als wäre jedes Token unverbraucht. Ein Workflow muss möglicherweise eine Nutzeranfrage, eine Dokumentkennung oder den aktuellen Aufgabenstatus ergänzen. Seine dauerhaften Anweisungen sollten jedoch geordnet und stabil bleiben. Teams sollten Cache-Treffer direkt messen, statt von einer Wiederverwendung auszugehen, nur weil ein Prompt von Anfrage zu Anfrage ähnlich aussieht. Eine Routing-Regel, die Aufgaben an das günstigere Modell sendet, kann einen großen Teil ihres beabsichtigten Vorteils verlieren, wenn jeder Aufruf denselben umfangreichen Kontext in einer Form neu erstellt, die der Cache nicht wiederverwenden kann. Umgekehrt kann ein gut strukturierter Prompt wiederholte Agenten-Schritte günstiger machen, ohne die für sie geltenden Vorgaben zu schwächen.
Das verändert auch die Art, wie Kostenprüfungen durchgeführt werden sollten. Der Tokenpreis beschreibt nur den Satz pro Anfrage; für ein operatives Team ist die relevante Einheit die Kosten für den Abschluss eines Workflows. Dazu gehören wiederholter Kontext, die Zahl der Schritte, der durch Tools entstehende zusätzliche Umfang, Wiederholungen und der anschließend erforderliche Korrekturaufwand durch Menschen. Die Cache-Rate sollte deshalb zusammen mit der Modellwahl, den aufgabenbezogenen Ausgaben und der Ergebnisqualität in einem gemeinsamen Dashboard stehen. Wenn ein Workflow wenig Kontext wiederverwendet, sollte die erste Reaktion nicht automatisch darin bestehen, jede Aufgabe auf Sol umzustellen. Die bessere Diagnosefrage lautet, ob der Prompt stabil genug für Caching ist, ob veränderliche Inhalte hinter dem stabilen Präfix stehen und ob der Workflow mehr Kontext erzeugt, als seine Abnahmekriterien verlangen.
Hintergrundfenster für Abschlüsse bieten einen zweiten Hebel für Arbeit, die keine sofortige Antwort benötigt. Die API stellt Hintergrundfenster von zwei und acht Stunden bereit, mit Tokenrabatten von 30 beziehungsweise 40 Prozent. Teams können damit Wartezeit gegen geringere Tokenkosten tauschen, wenn ein Auftrag ohne Belegung einer interaktiven Sitzung ausgeführt werden kann. Lang laufende Analysen, stapelartige Verarbeitung oder geduldige Agentenarbeit können in dieses Muster passen, sofern der Workflow das gewählte Zeitfenster toleriert und eine eindeutige Definition des Abschlusses besitzt.
Der Rabatt ersetzt keine Steuerung des Laufs. Auch ein Hintergrundauftrag braucht ein explizites Timeout, eine Abbruchregel und einen Alarm, wenn er ins Stocken gerät oder unerwartet wächst. Ohne diese Kontrollen kann ein günstigerer Tokenpreis durch einen Agenten überkompensiert werden, der fortlaufend neue Arbeit erzeugt, ohne Lösung wiederholt oder auf eine fehlende Abhängigkeit wartet. Im operativen Design sollte festgehalten werden, wann der Auftrag eingereicht wurde, welches Zeitfenster gewählt wurde, welches Ereignis als Erfolg gilt und was nach Ablauf der Frist geschieht. Außerdem muss der Status des Auftrags so sichtbar sein, dass eine zuständige Person ihn stoppen kann, bevor aus einem ungewöhnlichen Lauf eine ungeprüfte Rechnung wird.
Ein sinnvoller Rollout besteht darin, Caching und Hintergrundausführung zunächst getrennt zu testen und erst danach in einer Produktionsroute zu kombinieren. Beginnen Sie mit festgelegten Eingaben und vergleichen Sie Cache-Rate, aufgabenbezogene Kosten, Latenz, Abschlussquote und die Zeit für menschliche Korrekturen. Anschließend sollte eine kleine Gruppe geeigneter Aufträge über jedes Hintergrundfenster laufen, wobei sowohl die Einsparungen als auch das Fehlerverhalten geprüft werden. Das Ergebnis sollte eine Routing-Regel mit klaren Grenzen sein: Interaktive Arbeit bleibt interaktiv, wenn Verzögerungen den Nutzer betreffen; geduldige Arbeit kann ein rabattiertes Zeitfenster verwenden, aber nur dann, wenn Timeout, Abbruch und Prüfpfad ausdrücklich festgelegt sind. So bleibt die Kostenkontrolle an den tatsächlichen Anforderungen des Workflows ausgerichtet, statt Rabatte zum Anlass zu nehmen, jeden Prozess asynchron zu machen.
Ein sicherer Rollout braucht Qualitätsgates, Datenschutzregeln und einen Not-Aus-Schalter
GPT-6.2 Astra und Sol führt man am sichersten ein, indem man die Modellauswahl als operative Änderung behandelt – nicht als simples Ersetzen einer Modell-ID durch eine andere. Beginnen Sie mit einem kleinen Pilotprojekt, das auf realen Abläufen und festen Eingaben basiert. Ziel ist keine beeindruckende Demonstration. Es geht darum, eine Vergleichsbasis zu schaffen, die den Zielkonflikt sichtbar macht: Was kostet jede Route für eine abgeschlossene Aufgabe, wie lange dauert sie, wie oft wird der Prompt-Cache genutzt, wie viel menschliche Korrektur ist nötig und wie schwer wiegt ein Fehler, sobald er einen Nutzer oder ein externes System erreicht?
Diese Messwerte sollten auf Aufgabenebene erhoben werden, statt sie über die gesamte Anwendung zu mitteln. Eine routinemäßige Extraktion und eine komplexe professionelle Analyse können unterschiedlich viel Kontext benötigen, verschiedene Tool-Pfade durchlaufen und bei einem Fehler sehr unterschiedliche Folgen haben. Niedrige Durchschnittskosten können eine teure Fehlerklasse verbergen, während eine höhere durchschnittliche Latenz bei Arbeit akzeptabel sein kann, die vor der Auslieferung geprüft wird. Erfassen Sie die gewählte Route, den Grund für jede Eskalation von Sol zu Astra, das Endergebnis und den erforderlichen menschlichen Eingriff. Mit der Zeit wird aus diesem Protokoll eine evidenzbasierte Richtlinie statt einer dauerhaft festgeschriebenen Präferenz.
Vor Beginn des Pilotprojekts sollten Qualitätsgates ausdrücklich definiert sein. Für Entwürfe, Extraktionen, routinemäßige Programmieraufgaben und wiederholbare Agentenaufgaben kann das Gate aus einem klaren Abnahmetest bestehen: Die erforderlichen Felder sind vorhanden, die Ausgabe entspricht dem erwarteten Format und der Ablauf wird abgeschlossen, ohne fehlende Informationen zu erfinden. Bei mehrdeutigen Quellen, komplexem Design oder Aufgaben mit finanzieller oder rechtlicher Beurteilung sollte das Gate zusätzlich prüfen, ob das Modell Unsicherheiten erkannt und die Grenzen seiner Belege offengelegt hat. Eine Route sollte nicht allein deshalb bestehen, weil ihre Formulierungen überzeugend klingen. Sie sollte bestehen, weil sich die Ausgabe an den Anforderungen der Aufgabe prüfen lässt und die Kosten eines Fehlers bekannt sind.
Für Agenten mit Tools gilt dieselbe Disziplin. OpenAI beschreibt für beide Modelle stärkere Schutzvorkehrungen, weist aber auch auf Fälle hin, in denen sie Hindernisse ausließen, die den Abschluss einer Aufgabe verhinderten. Das ist eine praktische Warnung für den Einsatz: Ein Agent darf einen blockierten Ablauf nicht stillschweigend in eine plausibel wirkende Antwort umwandeln. Er muss fehlende Dateien, nicht verfügbare Tools, fehlgeschlagene Aufrufe und ungeklärte Berechtigungen melden. Diese Meldungen sollten in den Protokollen sichtbar sein und gegebenenfalls an die für die Aufgabe verantwortliche Person zurückgegeben werden. Ein Abschlussstatus reicht nicht aus, wenn die zugrunde liegende Aktion nie stattgefunden hat.
Datenschutz und Zugriffskontrollen sollten für jede Route separat gestaltet werden. Geben Sie jedem Workflow nur die Daten und Tool-Berechtigungen, die er benötigt, und gehen Sie nicht davon aus, dass ein leistungsfähigeres Modell weitreichenden Zugriff sicher macht. Sensible Inhalte, gespeicherter Kontext und lange System-Prompts können selbst dann ein Risiko darstellen, wenn die endgültige Antwort korrekt aussieht. Die Routing-Richtlinie sollte festlegen, welche Informationen an welches Modell gesendet werden dürfen, welche Tools aufgerufen werden können, wie Ausgaben gespeichert werden und wer sie prüfen oder genehmigen darf. Modellfähigkeiten beseitigen keine Bedenken hinsichtlich Aufbewahrung, Zugriff oder Anbieterbindung; sie machen es umso wichtiger, diese Punkte zu dokumentieren, bevor das System in den täglichen Betrieb eingebettet ist.
Bei folgenreichen Aktionen bleibt menschliche Genehmigung erforderlich. Das Senden einer Nachricht, das Ändern eines Datensatzes, die Freigabe einer Transaktion, die Veröffentlichung von Material oder die Änderung von Produktivcode sollte eine klar definierte Prüfgrenze haben. Das Modell kann die Aktion vorbereiten und seine Begründung erläutern, aber das System muss den Genehmigungsstatus eindeutig kenntlich machen. Ein brauchbarer Not-Aus-Schalter ist daher mehr als eine allgemeine Abschaltfunktion. Er umfasst die Möglichkeit, lang laufende Jobs abzubrechen, Grenzen für Tool-Aufrufe und wachsenden Kontext zu setzen, bei festgefahrenen oder unerwartet umfangreichen Abläufen Warnungen auszulösen und eine Route zu deaktivieren, ohne die gesamte Anwendung offline zu nehmen.
Der Rollout kann anschließend stufenweise erfolgen: den bestehenden Ablauf messen, vergleichbare Fälle über die vorgesehenen Routen ausführen, Qualität und Schwere der Fehler prüfen und erst dann erweitern, wenn die Gates zuverlässig greifen. Halten Sie eine Ausweichroute verfügbar, solange Cache-Verhalten, Zeitfenster für Hintergrundabschlüsse und Eskalationsregeln noch abgestimmt werden. Ziel ist weder, jede Aufgabe auf Astra zu zwingen, noch Sol Arbeit übernehmen zu lassen, die es nicht zuverlässig bewältigen kann. Die Grenze zwischen beiden soll sichtbar, überprüfbar und umkehrbar werden. Wenn Kosten, Latenz, Qualität, Datenschutz und menschliche Aufsicht gemeinsam erfasst werden, wird die Modellwahl zu einer kontrollierten Betriebsentscheidung statt zu einer Vermutung am Anfang eines Prompts.
Related articles
OpenAI-Modelle kommen in die Google Cloud: Was Unternehmen vor dem Wechsel testen sollten
Die Partnerschaft von OpenAI und Google Cloud verändert, wo Unternehmen die Modelle kaufen und verwalten können. Sie beseitigt jedoch nicht die schwierigen Seiten des KI-Einsatzes. Was die private Vorschau bedeutet, welche Tests nötig sind und wo neue Kosten entstehen können.
Der automatisierte Forschungspraktikant ist da. Jetzt wird die Evidenz zum Engpass
OpenAI berichtet, dass seine Forschungsteams zusammengenommen bereits mehr Agentenarbeit als menschliche Arbeitszeit nutzen. Die praktische Konsequenz: Entdeckung muss nicht abgegeben, sondern durch überprüfbare, dokumentierte und verwerfbare Ergebnisse neu organisiert werden.
OpenAI Models Are Coming to Google Cloud: What Enterprise Teams Should Test Before Switching
OpenAI’s Google Cloud partnership changes where enterprises can buy and govern its models, but it does not remove the hard parts of AI deployment. Here is what the private preview means, what to test, and where cloud convenience can hide new costs.
Модели OpenAI появятся в Google Cloud: что корпоративным командам проверить перед переходом
Партнёрство OpenAI и Google Cloud меняет способы покупки и управления моделями, но не устраняет сложностей внедрения ИИ. Разбираем значение закрытого тестирования, ключевые проверки и скрытые издержки облачного удобства.
Comments
Sign in to comment.
No comments yet.