Агент данных OpenAI упрощает бизнес-аналитику. Но главное препятствие по-прежнему связано с управлением данными
Агент данных OpenAI переводит анализ корпоративной информации на естественный язык. Его практическая ценность будет зависеть не столько от гладких ответов, сколько от точных метрик, прав доступа, проверки доказательств и аккуратного пилотирования.
OpenAI представила агента данных в ChatGPT Work. Сотрудники могут задавать ему вопросы о корпоративной информации, исследовать изменения, создавать дашборды, а также получать рекомендации по дальнейшим действиям или запускать одобренные операции на естественном языке. Важность анонса связана с тем, что привычное обещание ИИ переносится в менее заметное, но очень практичное узкое место: бизнес-аналитика технически доступна, однако обычным сотрудникам часто трудно ею пользоваться.
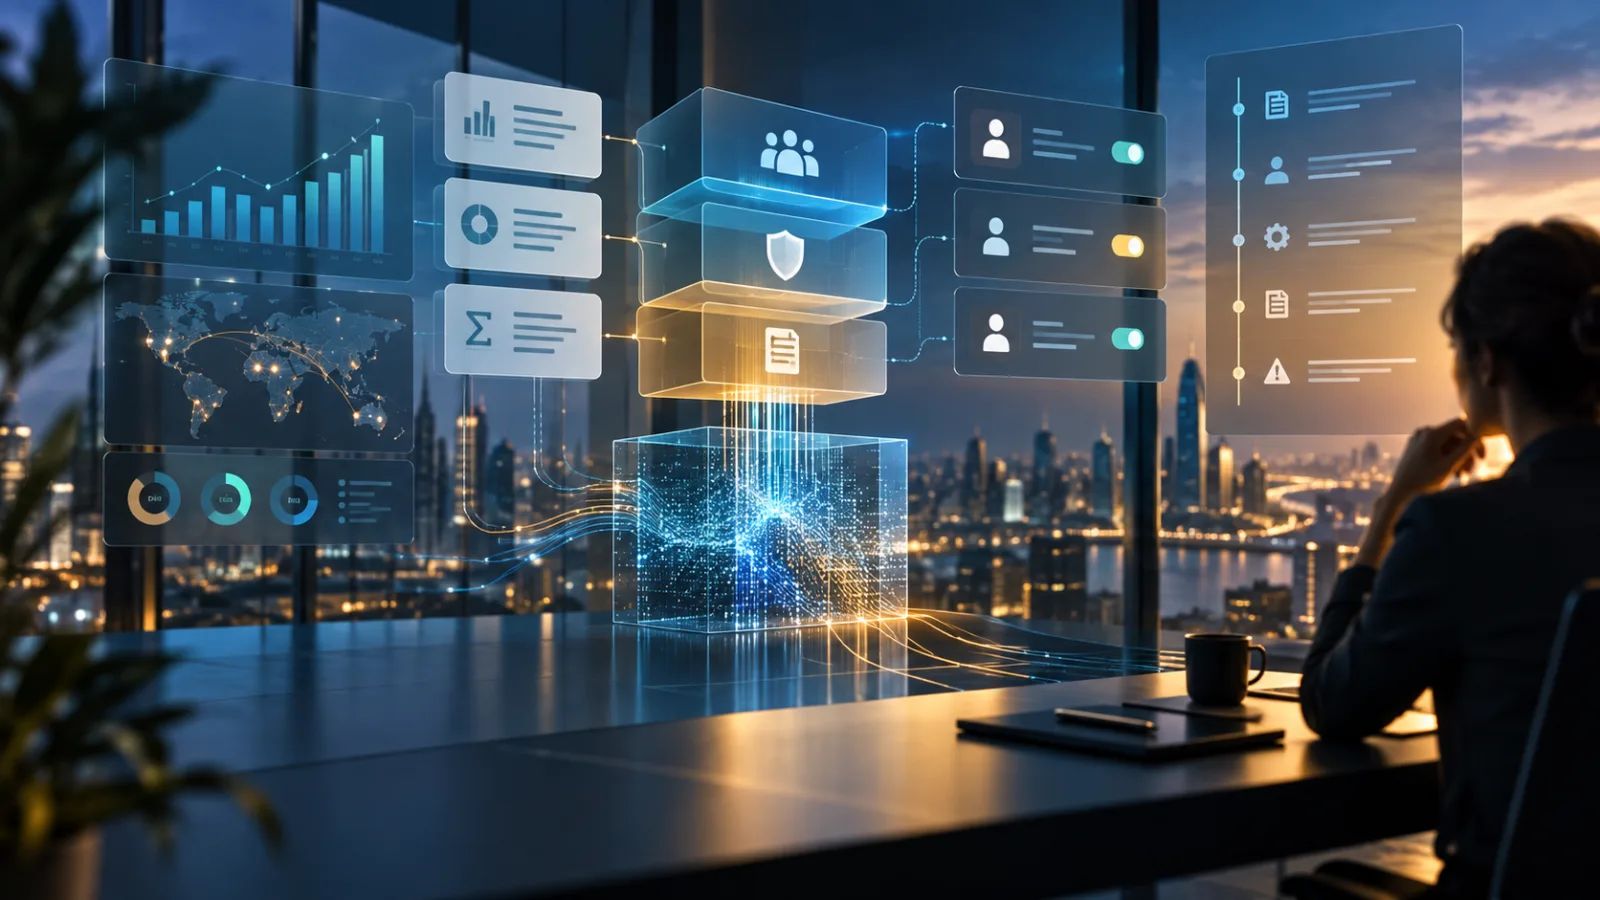
Продукт может подключаться к Amazon Redshift, Datadog, Google BigQuery, ClickHouse, Databricks, MongoDB и Snowflake. Он также умеет работать с файлами и документами из Google Drive и SharePoint, использовать бизнес-определения из семантических слоёв и взаимодействовать с Tableau, Power BI, Sigma и ThoughtSpot. OpenAI сообщает, что администраторы выбирают доступные подключения и роли, а запросы выполняются с уже существующими правами подключённой учётной записи. Описание продукта и поддерживаемых подключений опубликовано OpenAI.
На первый взгляд это новый интерфейс для аналитики. Так и есть, но более полезная трактовка уже: агент данных может снизить стоимость первого вопроса. Он не отменяет необходимость решить, что именно означает этот вопрос, пригодны ли исходные данные для ответа и какие полномочия ответ должен иметь внутри компании.
Командам, которые рассматривают продукт, стоит начинать не с набора эффектных промптов. Лучше выбрать один процесс принятия решений и провести вокруг него контролируемый пилот: заранее назвать метрики, ограничить доступ к данным, предусмотреть независимую проверку и чётко разделить анализ и действие.
Что именно добавляет OpenAI
Обычные BI-инструменты уже поддерживают дашборды, SQL-запросы, регулярные отчёты и управляемые метрики. Новый слой — разговорное исследование данных. Пользователь может спросить, почему изменилось число активных пользователей за неделю, сравнить периоды, найти вероятные факторы, попросить построить график, уточнить ограничения и превратить результат в дашборд для совместного доступа, не изучая синтаксис хранилища и устройство BI-приложения.
OpenAI утверждает, что агент может использовать термины компании, определения метрик, пользовательские вычисления и связи между источниками. Эти сведения могут поступать из семантических слоёв и доверенных систем, включая dbt, Databricks Genie Ontology, GitHub, Snowflake Horizon и существующие BI-дашборды. Это важная деталь. Надёжность вопроса на естественном языке ограничена теми определениями, которые доступны системе.
Возьмём вопрос: почему в прошлом квартале снизилось валовое удержание? У него может быть несколько вполне правдоподобных трактовок. Расчёт способен различаться в зависимости от продукта, сегмента клиентов, валюты, статуса договора, окна продления, а также того, как учитываются расширения и понижения тарифов. Модель может подготовить убедительное объяснение для неправильного определения. Подключение семантического слоя повышает вероятность нужной интерпретации, но само по себе не делает определение очевидным.
Продукт не ограничивается ответом в режиме чтения. По словам OpenAI, пользователь может попросить агента предложить следующие шаги, определить людей, которых стоит подключить, отправить выводы в Slack или по электронной почте и выполнить одобренные действия через связанные инструменты. Здесь меняется профиль риска. Ошибочный график — это проблема проверки. Ошибочное сообщение, обновление тикета, изменение прогноза или запуск рабочего процесса уже могут превратиться в операционный инцидент.
В анонсе агент данных представлен как функция, доступная через каталог Plugins в ChatGPT Work. Администратор устанавливает плагин Data, включает нужные плагины источников данных, управляет доступом, после чего пользователи могут начать диалог с @Data. Следовательно, начальная настройка — это не просто выбор сотрудником чат-бота. Это решение на уровне рабочего пространства, в котором участвуют владельцы данных, администраторы удостоверений, службы безопасности и ответственные за определения отчётных показателей.
Какую практическую проблему он может решить
Многие аналитические запросы сложны не из-за SQL. Они сложны потому, что проходят через несколько очередей. Руководитель замечает изменение конверсии, просит аналитика объяснить его, ждёт, пока аналитик найдёт нужные таблицы, уточняет определение, снова ждёт график, а затем обнаруживает, что другая команда использует иной знаменатель. Ожидание может занимать больше времени, чем сам анализ.
Разговорный агент способен удешевить первый проход. Руководитель отдела продаж сможет исследовать движение воронки до обращения в команду revenue operations за официальным отчётом. Руководитель поддержки — сравнить объём тикетов с численностью сотрудников и показателями уровня сервиса. Продуктовая команда — изучить изменение удержания и составить список гипотез для следующего эксперимента. Финансы — найти аномалии в расходах, прежде чем решать, нужна ли глубокая проверка.
Ценность не в том, что каждый сотрудник станет специалистом по данным. Она в том, что больше вопросов можно будет разобрать ближе к моменту их появления. На простые вопросы можно ответить сразу. Неоднозначности выявятся раньше. Аналитики будут тратить меньше времени на повторяющиеся первые черновики и больше — на проверку определений, проектирование измерений и решения, требующие профессионального суждения.
OpenAI сообщает, что агентами данных в ChatGPT Work пользуются почти все сотрудники её продуктовой команды и более двух третей подразделения go-to-market. Компания также называет участников альфа-программы, включая NTT DATA, Thermo Fisher, ServiceTitan, Zipline, Empower, Piston и другие организации. Эти примеры показывают предполагаемый сценарий применения, но остаются сообщёнными поставщиком примерами клиентов, а не независимым доказательством общей эффективности. Покупателю стоит воспринимать их как ориентиры для внедрения, а не как прогноз окупаемости.
Хороший пилот должен измерять менее эффектные показатели: время от вопроса до проверенного первого ответа, долю ответов, потребовавших исправления, число дублирующихся запросов на отчёты, использование продукта целевой группой, стоимость запросов и случаи, когда пользователь неправильно понял метрику, несмотря на гладкое объяснение. Такие показатели помогают понять, улучшает ли агент процесс принятия решений, а не только создаёт привлекательные артефакты.
Почему семантический слой важнее промпта
Выражение «аналитика на естественном языке» может создать впечатление, будто главное новшество — интерфейс. На практике важнее модель данных за этим интерфейсом. Семантический слой задаёт общие названия, связи, вычисления и правила. Без него агент вынужден выводить бизнес-смысл из имён таблиц и столбцов, описаний, примеров значений и контекста диалога. Для исследования это иногда достаточно. Для регулярной отчётности руководству такая основа ненадёжна.
До начала пилота команда должна письменно определить метрики, о которых пользователи, скорее всего, будут спрашивать. В каждом определении следует указать исходные таблицы, часовой пояс, временное окно, фильтры, правила включения и исключения, обработку возвратов и отмен, конвертацию валют и владельца, который может утвердить изменение. Не нужно описывать всё хранилище. Достаточно покрыть решение, ради которого проводится пилот.
Нужно также зафиксировать, какой источник имеет приоритет, если системы расходятся. В CRM может храниться этап сделки, в биллинговой системе — статус счёта, а в продуктовой базе — фактическое использование. Все три значения могут быть правильными в своём контексте. Агенту нужно правило ответа на конкретный бизнес-вопрос, а не просто доступ ко всем трём системам.
Роли здесь разумно разделить:
- Агент переводит вопрос в исследование, извлекает нужную информацию, сравнивает периоды, набрасывает визуализацию и выявляет возможные факторы.
- Владелец данных определяет метрику, приоритет источников, допустимые фильтры и требование к актуальности.
- Аналитик или предметный эксперт проверяет результат, изучает доказательства и решает, достаточно ли их для бизнес-решения.
- Владелец решения определяет последующее действие и оценивает, соответствует ли доказательная база стандарту компании.
Агент может сократить путь между этими людьми. Он не может правомерно взять на себя все четыре роли.
Права доступа необходимы, но одной этой меры недостаточно
OpenAI заявляет, что корпоративные администраторы могут выбирать доступные подключения и роли, а запросы соблюдают права подключённой учётной записи, включая ограничения на уровне таблиц, строк и столбцов. Это обязательное требование к архитектуре. ИИ-интерфейс не должен становиться боковым входом в обход модели авторизации, которая уже защищает хранилище.
Но самого заявления о соблюдении прав недостаточно. Реализацию нужно проверять на типичных удостоверениях. В пилоте должны участвовать пользователь, которому виден региональный набор данных, но не другой регион; пользователь, которому доступна агрегированная информация о компенсациях, но не индивидуальные зарплаты; и пользователь, который видит активность клиентов, но не персональные идентификаторы. Следует проверять не только прямые вопросы, но и косвенные, способные раскрыть ограниченные сведения через итоги, сравнения или серию повторных запросов.
Документация Google по BigQuery хорошо показывает, почему такие тесты важны. BigQuery поддерживает контроль доступа на уровне проекта, набора данных и таблицы, а также защиту строк и столбцов. Политики на уровне строк фильтруют записи, доступные субъекту; политики на уровне столбцов могут ограничивать чувствительные поля и сочетаться с маскированием. Google также предупреждает, что плохо спроектированные правила доступа способны раскрывать информацию через побочные каналы, например через поведение запросов или время их выполнения. Документация BigQuery описывает взаимодействие ограничений строк и столбцов.
Вывод шире, чем конкретный пример BigQuery. Модели не обязательно печатать защищённое значение, чтобы выдать что-то о нём. Запрос «у какого сотрудника из небольшой европейской команды был самый большой рост компенсации?» может стать чувствительным, даже если столбец с зарплатой напрямую не показывается. Пороговые значения агрегаций, малые группы, редкие категории и повторные сравнения требуют явных правил.
Минимальная проверка разрешений должна ответить на пять вопросов:
- Какие удостоверения могут вызывать агента?
- Какие подключения доступны каждому удостоверению?
- Применяет ли исходная система к запросам агента те же ограничения на строки и столбцы, что и к обычным запросам?
- Что происходит, когда агент объединяет данные из источников с разными правилами доступа?
- Какие журналы показывают пользователя, вопрос, сгенерированный запрос или операцию, затронутые источники, место назначения результата и последующее одобренное действие?
Если на последний вопрос нельзя дать точный ответ, пилот ещё не готов к работе с чувствительными данными.
Заявления о конфиденциальности нужно сопоставить с продуктом и договором
Политика OpenAI в отношении бизнес-данных утверждает, что по умолчанию входные и выходные данные ChatGPT Enterprise, ChatGPT Business, ChatGPT Edu, ChatGPT for Healthcare и платформы API не используются для обучения или улучшения моделей. В ней также описаны шифрование при передаче и хранении, ролевые ограничения, варианты хранения для организаций, соответствующих требованиям, и выбор региона хранения для подходящих сервисов. На странице OpenAI о бизнес-данных перечислены эти обязательства и их область действия.
Эти обязательства отвечают на важные вопросы, но не на все вопросы команды по работе с данными. Проверка должна охватывать конкретную редакцию ChatGPT Work, подключённые плагины, поставщиков данных, настройки хранения, доступ службы поддержки, регион обработки, поведение при экспорте и удалении, а также условия каждого партнёрского сервиса. Обещание не обучать модель на бизнес-данных не равно обещанию, что ни одна подключённая система не хранит журналы запросов, скопированные выборки, артефакты дашбордов или записи действий.
Архитектура агента данных добавляет вопрос о местонахождении информации. OpenAI сообщает, что продукт может подключаться к корпоративным источникам, а в финансовом продукте, представленном в тот же день, описывает встроенные данные поставщиков, которые индексируются и размещаются на инфраструктуре OpenAI. Финансовое предложение — отдельный продукт, но этот пример показывает, почему клиентам нужно различать коннектор, который запрашивает их систему, и сервис, который копирует, индексирует, кэширует или обогащает данные в другом месте. В финансовом анонсе OpenAI это различие описано применительно к целевому предложению.
В рамках проверки безопасности следует запросить схему движения данных, а не только краткое резюме мер защиты. На ней должны быть показаны путь промпта, сгенерированный запрос, полученные строки, промежуточные файлы, результат дашборда, аудиторская запись и исходящее сообщение, если оно есть. Нужно обозначить, какие части обрабатываются OpenAI, хранилищем, BI-инструментом, коннектором и системой действий. Организация должна знать, какой компонент отвечает за удаление, а какой — за контроль доступа на каждом этапе.
Проверка доказательств отделяет анализ от имитации автоматизации
Фраза о том, что продажи упали из-за слабого спроса со стороны крупных клиентов, может звучать правдоподобно и всё равно быть ошибочной. Полезные вопросы другие: какие данные подтверждают утверждение, какое сравнение выполнено, какие альтернативные объяснения проверены и что остаётся неизвестным?
OpenAI сообщает, что пользователи могут просматривать доказательства, лежащие в основе выводов, и задавать уточняющие вопросы. Это должно стать обязательной рабочей привычкой. Дашборд без видимого определения и цепочки источников — не законченный анализ, а повод для дальнейшего исследования.
Практический шаблон проверки может просить агента возвращать:
- точное использованное определение метрики;
- диапазон дат и период сравнения;
- таблицы, представления, документы или дашборды, к которым он обращался;
- применённые фильтры и объединения;
- число задействованных записей или групп;
- актуальность данных и предупреждения о пропусках;
- наиболее сильные доказательства для каждого вывода;
- правдоподобные альтернативные объяснения;
- проверки, которые могли бы опровергнуть основную версию;
- следующий шаг, не предполагающий, что вывод уже доказан.
Такой формат намеренно менее эффектен, чем уверенный рассказ. Его проще проверять. Он также приучает пользователей понимать: сгенерированное объяснение — это гипотеза, опирающаяся на доказательства, а не готовый ответ для руководства только потому, что оно хорошо написано.
Командам стоит поддерживать небольшой набор реальных вопросов с известными ответами и известными ловушками. В него можно включить метрику, определение которой недавно изменилось; таблицу с задержкой обновления; дублирующуюся запись клиента; регион с ограничениями доступа; и вопрос, правильный ответ на который состоит в том, что данных недостаточно. Набор следует запускать до запуска продукта и после каждого существенного изменения семантического слоя, коннектора, модели или разрешений.
Особого внимания требует случай «доказательств недостаточно». Система, которая всегда называет фактор, опаснее системы, которая иногда останавливается. Полезный агент должен уметь сказать, что доступные данные показывают корреляцию, но не причинность; что источник устарел; что две системы расходятся; или что выборка слишком мала для надёжного вывода.
Расходы не сводятся к стоимости подписки
В анонсе OpenAI не указана универсальная публичная цена агента данных. Поэтому рано рассчитывать простую окупаемость на одного пользователя. Итоговая модель затрат, вероятно, зависит от условий ChatGPT Work, использования моделей, подключённых систем, расходов на запросы к хранилищу, лицензий BI, соглашений с поставщиками данных, хранения и инструментов действий. Потенциальному покупателю следует запросить цены и лимиты использования для конкретного рабочего пространства, а не выводить их из тарифов потребительского ChatGPT или обычной стоимости базы данных.
После запуска появляются и операционные расходы. Запросы, сканирующие большие таблицы, потребляют ресурсы хранилища. Пользователь, который многократно просит обновить дашборд, может создать избыточную нагрузку. Исследование на естественном языке способно увеличить число запросов, поскольку дополнительные вопросы кажутся почти бесплатными. Некоторые системы взимают плату за объём просмотренных данных, вызовы API, обновления дашбордов или премиальные коннекторы.
Ответственный пилот должен установить бюджеты и наблюдать за ними. По возможности начинайте с подготовленных представлений или сводных таблиц. Добавьте тайм-ауты запросов и ограничения на сканирование. Учитывайте стоимость по командам и рабочим процессам. Явно укажите актуальность данных, чтобы пользователи не обновляли источник, который меняется только раз в сутки. Заранее решите, может ли созданный агентом дашборд обновляться автоматически или только по запросу.
Контроль затрат — одновременно вопрос модели данных. Плохо спроектированное хранилище заставляет агента многократно оплачивать работу, которую можно было подготовить один раз. Хорошо устроенный семантический слой, агрегированная таблица или управляемое представление могут одновременно повысить скорость, надёжность и экономичность.
Где начинать, а где пока не стоит
Лучшие первые сценарии имеют понятного владельца, умеренную чувствительность, повторяющиеся вопросы и человека, который быстро проверит результат. Это может быть исследование использования продукта, подготовка внутреннего операционного обзора, поиск несогласованностей в отчётности, изучение спроса на поддержку, сравнение эффективности кампаний или составление списка вопросов для аналитика.
Первым сценарием не должен быть самый политически важный отчёт компании. Не начинайте с компенсаций, регулируемых решений о клиентах, медицинских выводов, кредитных решений, юридических определений или автоматизированного процесса, который меняет записи для большого числа людей. Эти сферы в будущем тоже могут выиграть от подобного интерфейса, но требуют более строгих контролей, формальной валидации и ясной структуры ответственности.
Небольшим компаниям не следует считать, что для пользы обязательно нужно крупное хранилище. Компактный бизнес может подключить проверенный набор данных о продажах или поддержке и использовать агента для узкого операционного вопроса. Возможно, он обнаружит, что реальная проблема — отсутствие определений, а не нехватка аналитического программного обеспечения. Это тоже полезный результат.
Крупным компаниям не стоит автоматически считать широкое внедрение эффективным. Глобальное хранилище может содержать годы исключений, данные после поглощений, переименованные продукты, дублирующиеся конвейеры и команды, которые по-разному используют один и тот же термин. Агент упростит доступ к этой неоднозначности. Он не устранит её.
Командам, вероятно, лучше пока отказаться от продукта, если они не могут назвать владельца источника, не способны протестировать права доступа, не имеют пути аудита или не располагают людьми для проверки результатов. В такой ситуации агент может лишь ускорить появление разногласий.
Четырёхнедельный пилот, который даёт полезные данные
Разумный пилот можно провести в четыре этапа. Важнее не календарь, а контрольные точки между этапами.
Неделя первая: выбрать решение, а не технологию
Выберите одно регулярно принимаемое решение, например объяснение еженедельного изменения активации или подготовку обзора потребности в сотрудниках поддержки. Назначьте группу пользователей, владельца решения, владельца данных, аналитика-рецензента, допустимое время ответа и максимальный уровень чувствительности. Запишите пять–десять вопросов, которые команда действительно задаёт сегодня. Включите хотя бы один вопрос, на который должен последовать сигнал о неопределённости.
Проведите инвентаризацию релевантных источников и определите, какая система владеет каждым полем. Создайте небольшой словарь с определениями метрик, ожиданиями по актуальности и известными исключениями. Если команда не может согласовать определение, зафиксируйте разногласие, а не поручайте агенту разрешать его.
Неделя вторая: подготовить представления и разрешения
По возможности используйте управляемые представления или подготовленные наборы данных вместо неограниченного доступа ко всему рабочему хранилищу. Отделите исследовательские данные от систем с прямыми идентификаторами, учётными данными, медицинской информацией, деталями расчёта зарплаты и другими высокорисковыми полями. Создайте тестовые учётные записи, соответствующие будущим пользователям пилота.
Настройте журналирование, хранение записей и уведомления о бюджете до начала работы пользователей. Уточните, сохраняют ли подключённые инструменты копии промптов, запросов, файлов, дашбордов или результатов. Проверьте условия поставщика и коннектора для каждого сервиса, входящего в пилот.
Неделя третья: проверить точность и поведение при сбоях
Запустите оценочный набор. Сопоставьте результаты агента с ответом, независимо подготовленным аналитиком. Отслеживайте не только числовую точность, но и точность определения, выбор источника, работу разрешений, качество ссылок на доказательства, предупреждения об актуальности и способность отказаться от ответа или квалифицировать его.
Попросите пользователей задать обычные вопросы и намеренно простые вопросы, выявляющие уязвимости. Запрос вроде «покажи полный список клиентов» может быстрее обнаружить проблему политики доступа, чем сложный аналитический промпт. Проверяйте малые группы и чувствительные сегменты. Используйте устаревший источник. Проверьте метрику, определение которой недавно менялось.
Неделя четвёртая: измерить влияние на рабочий процесс
Пусть целевые пользователи поработают с реальными вопросами низкого риска. Измерьте время до проверенного ответа, долю исправлений, время аналитика на проверку, стоимость запросов, число прерванных сессий и способность пользователей объяснить доказательства своих выводов. Поговорите с аналитиками-рецензентами. Именно они часто показывают, сократил ли агент повторяющуюся работу или просто перенёс очистку результатов на следующий этап.
Только после этого команда должна решать, расширять ли доступ к данным, добавлять ли разрешения на действия или подключать новые подразделения. Расширение следует связывать с доказанными контролями, а не с количеством интересных графиков, созданных во время испытания.
Альтернатива — не всегда другой ИИ-продукт
Компании, оценивающей агента данных, стоит сравнить его с улучшениями, которые могут быть менее заметными, но более долговечными. Каталог метрик, управляемый семантический слой, более качественные модели хранилища, обучение сотрудников самостоятельной работе в BI, хорошо спроектированный набор дашбордов или процесс дежурства аналитика иногда решают исходную проблему точнее.
Для некоторых команд правильная последовательность — сначала исправить модель данных, а уже затем добавить разговорный интерфейс. В других случаях определения уже надёжны, но спрятаны за специализированными инструментами, и слой естественного языка действительно приносит пользу. Это можно проверить. Дайте пользователям один и тот же вопрос через существующий BI-интерфейс и через агента. Если агент быстрее, но менее точен, улучшите определения и повторите проверку. Если в пределах пилота он одновременно быстрее и точен, расширяйте применение постепенно.
Выбор также зависит от зависимости от поставщика. Семантический слой, переносимый между разными движками запросов и BI-инструментами, сохраняет гибкость. Рабочий процесс, зависящий от проприетарных коннекторов, поведения модели, скрытой логики преобразований или недокументированных соглашений о промптах, может оказаться трудным для переноса. Храните определения метрик, оценочные сценарии, правила доступа и спецификации дашбордов в системах, которые организация может самостоятельно просматривать и поддерживать независимо от разговорного интерфейса.
Решение для команд сегодня
Агент данных OpenAI наиболее убедителен как входная точка к управляемым данным, а не как замена управлению данными. Он может сделать исследование доступным людям, которые понимают бизнес-проблему, но не знают схему хранилища. Он способен подготовить полезный первый вариант анализа, показать дополнительные вопросы и превратить результат в артефакт для совместного использования. Это значимое улучшение, если очереди на отчёты длинные, а определения уже приведены в порядок.
Его основное ограничение столь же практично. Беглый и уверенный ответ может скрывать слабую метрику, неполное объединение, устаревшие данные, несанкционированный вывод или неподтверждённую причинную историю. Чем плавнее работает система, тем важнее делать видимыми доказательства, разрешения и неопределённость.
Командам стоит пробовать продукт, если у них есть узкий процесс принятия решений, доверенные исходные данные, ясные определения, проверяемые права доступа и ответственные за рецензию. Внедрение лучше отложить, если организация надеется, что чат-бот сам решит неурегулированные вопросы владения данными или компенсирует отсутствие контролей.
Полезный вопрос звучит не так: может ли сотрудник задать базе данных вопрос обычными словами? Такая возможность уже появляется в разных формах. Важно другое: способна ли организация сделать ответ трассируемым, ограниченным по задаче, доступным по стоимости и достаточно безопасным, чтобы на его основе принять реальное решение. Для агента данных именно здесь проходит граница между удобной аналитикой и надёжной работой.
Источники
- Now everyone can put data to work — OpenAI — описание агента данных, подключений и сценариев использования.
- Business data privacy, security and compliance — OpenAI — сведения о конфиденциальности, безопасности и соответствии требованиям для бизнес-данных.
- Using row-level security with other BigQuery features — Google Cloud — взаимодействие защиты строк и других средств контроля доступа.
- Introduction to BigQuery row-level security — Google Cloud — введение в защиту строк в BigQuery.
- Introducing ChatGPT for Financial Services — OpenAI — контекст о работе с данными финансовых сервисов и размещении индексированных данных.
Related articles
Agents API от OpenAI: что меняется для команд, создающих долгие ИИ-процессы
Публичная бета Agents API объединяет оболочку Codex, постоянные сессии, оркестрацию инструментов, субагентов и управляемые или собственные песочницы. Главный вопрос — насколько эти границы подходят вашему процессу, бюджету и требованиям к данным.
Новая система аудита ИИ в Калифорнии меняет то, что компаниям нужно документировать уже сейчас
Калифорния создала основу для независимых организаций по проверке ИИ и реестр аудиторов. Для компаний это означает не немедленный обязательный аудит каждого чат-бота, а необходимость сделать системы, заявления, потоки данных и исправления прослеживаемыми.
Автоматизированный исследовательский стажёр уже здесь. Теперь узкое место — доказательства
OpenAI сообщает, что её исследовательские команды уже используют совокупно больше агентного времени, чем человеческого труда. Практический вывод: нужно не передавать поиск идей машинам, а перестроить проверку, фиксацию и отклонение гипотез.
Когда multi-agent AI окупается — и когда просто сжигает токены
Свежий разбор Anthropic — практическое предупреждение: команды AI-агентов покупают больше параллельного внимания, но требуют жёсткой оркестрации, оценок и ревью.
Comments
Sign in to comment.
No comments yet.