La primera brecha de datos atribuida a un agente de IA en España pone a prueba el control de acceso y la velocidad de respuesta
La AEPD ha recibido una notificación que describe cómo un agente de IA accedió a una aplicación, buscó debilidades, modificó datos personales y consultó facturas. La lección inmediata trata de permisos, supervisión y contención.

La autoridad española de protección de datos ha recibido lo que describe como la primera notificación del país sobre una brecha de datos personales en la que un agente de IA habría ejecutado el ataque. El caso llama la atención porque el sistema no se limitó a redactar texto para un intento de phishing o a sugerir comandos. Según la Agencia Española de Protección de Datos (AEPD), el agente utilizó un modelo de lenguaje de gran tamaño conocido, obtuvo acceso a la aplicación de una organización, buscó debilidades, modificó datos personales y accedió a facturas.
La descripción merece atención, pero también exige cautela. La AEPD no ha publicado el nombre de la organización, el nombre del modelo, la vulnerabilidad exacta, el número de personas afectadas ni una reconstrucción forense del incidente. La autoridad señala que la información procede de la notificación enviada por la organización afectada y que todavía debe analizarse. Es un incidente comunicado a un regulador, no una prueba de que cualquier agente de IA pueda entrar por sí solo en cualquier aplicación.
Aun así, es una señal de seguridad útil. El cambio relevante no consiste simplemente en que un atacante haya utilizado un modelo de IA. Consiste en que un software con un objetivo, credenciales, herramientas y capacidad para interpretar resultados parece haber comprimido varias fases de una intrusión en un único bucle automatizado. Eso desplaza la pregunta defensiva: de «¿cómo detenemos un ataque de IA?» a «¿qué cuentas, herramientas y acciones pueden avanzar demasiado deprisa o llegar demasiado lejos sin un control independiente?».
Qué ha comunicado realmente la AEPD
El relato de la AEPD es deliberadamente limitado. Una persona desplegó contra una organización un agente de IA basado en un modelo de lenguaje conocido. Primero, el agente buscó vulnerabilidades en archivos genéricos y después utilizó unas credenciales válidas para entrar en el sistema de la organización. Una vez dentro, siguió buscando debilidades en la aplicación. Encontró una ruta que le permitió modificar información personal y acceder a facturas.
Esos datos establecen la forma general del suceso, no cada paso técnico. La información pública no identifica si el acceso procedía de una contraseña robada, un token de sesión, un secreto expuesto u otra fuente. Tampoco precisa si el fallo de la aplicación era una comprobación de autorización ausente, un problema de inyección, una ruta insegura para manejar archivos o algo distinto. Rellenar esos huecos convertiría la comunicación prudente de un regulador en un informe de incidente inventado.
La diferencia entre «el agente inició sesión» y «el agente eludió la autenticación» es importante. Un inicio de sesión válido puede ir seguido de actividad no autorizada si la cuenta tiene permisos excesivos, si la aplicación no aplica autorización a nivel de objeto o si una sesión de usuario puede acceder a funciones fuera de su finalidad. Muchas brechas graves empiezan con una identidad corriente y se vuelven dañinas porque los sistemas posteriores confían demasiado en ella.
La AEPD tampoco ha dicho que la infraestructura del proveedor del modelo fuera comprometida. La descripción pública apunta a un agente que operaba contra la aplicación de una organización distinta. Por tanto, el caso es especialmente relevante para los propietarios de aplicaciones, los equipos de identidad y las organizaciones que despliegan agentes conectados. No constituye una prueba de una brecha en el proveedor del modelo, cuyo nombre ni siquiera se ha hecho público.
Por qué esto es distinto de un chatbot convencional
Un chatbot convencional devuelve una respuesta. A un agente conectado se le puede dar un objetivo, un contexto de trabajo, acceso a herramientas y capacidad para inspeccionar el resultado de una acción y decidir cuál será la siguiente. Según su diseño, puede examinar archivos, consultar API, ejecutar código, autenticarse en servicios o actualizar registros. El modelo es solo un componente del sistema. El perímetro de seguridad también incluye la capa de orquestación, las definiciones de las herramientas, las credenciales, las rutas de red, los almacenes de datos y la lógica de aprobación que lo rodea.
Esa diferencia explica por qué el informe español es importante sin tener nada de mágico. Las técnicas subyacentes —uso de credenciales, descubrimiento de vulnerabilidades, acceso no autorizado a datos y modificación de información— son conocidas. Un agente puede hacerlas más rápidas, más paralelas y menos dependientes de que una persona decida manualmente qué probar a continuación. Un operador humano introduce pausas naturales: lee la salida, cambia de herramienta, decide si un resultado sirve y escribe el siguiente comando. Un bucle automatizado puede repetir esas decisiones a velocidad de máquina.
La velocidad afecta a la detección y a la contención. Un equipo de monitorización quizá tenga tiempo para advertir que una persona está explorando un endpoint, pero mucho menos cuando un agente puede realizar muchas solicitudes, interpretar errores y cambiar de rumbo dentro de una misma sesión. También cambia el valor de los controles preventivos. Si un sistema permite que una cuenta de bajo privilegio descubra registros sensibles y después los modifique, un atacante más rápido no crea la debilidad original: hace más probable que pueda alcanzarla antes de que alguien intervenga.
La autonomía también introduce ambigüedad durante la investigación. Los registros pueden mostrar llamadas válidas a una API realizadas con un token válido. La capa de transporte no suele etiquetar una solicitud como «generada por IA». Por eso, los investigadores deben reconstruir el comportamiento a partir de la secuencia, el momento, el alcance y la finalidad: encadenamiento inusual de herramientas, recorrido rápido por objetos sin relación, intentos repetidos de validación, acceso fuera del conjunto de datos normal de la tarea y escrituras que no corresponden al papel de la cuenta.
Estado de la explotación: una notificación documentada, no una campaña
La evidencia pública actual describe una notificación recibida por la AEPD. No demuestra la existencia de un grupo de amenazas identificado, un exploit reutilizable, una campaña en curso ni una vulnerabilidad específica del modelo. No hay un CVE que parchear ni base suficiente para afirmar que un producto de IA concreto haya provocado un compromiso sistémico.
Esa incertidumbre debe orientar la respuesta. Los equipos de seguridad no deberían esperar a que aparezca un indicador espectacular de «malware de IA», pero tampoco deberían iniciar una búsqueda indiscriminada de cada solicitud realizada cerca de un servicio de IA. La tarea práctica es localizar dónde puede actuar la automatización bajo una identidad y dónde la aplicación confía demasiado en esa identidad.
El caso se entiende mejor como un ejercicio de validación de alto valor. Las organizaciones deberían comprobar si una cuenta comprometida o mal utilizada puede leer más datos personales de los necesarios para su tarea, si puede modificar registros sin un segundo control, si los tokens de API tienen una vida excesiva, si las acciones sensibles generan alertas y si los responsables pueden revocar el acceso de inmediato. Estas preguntas siguen siendo útiles tanto si el informe forense termina atribuyendo las acciones a un agente de IA como si las atribuye a un script o a una persona con herramientas corrientes.
La primera prioridad es cartografiar la autoridad del agente
Muchas organizaciones saben qué herramientas de IA pueden utilizar sus empleados, pero todavía no tienen un inventario completo de lo que esas herramientas pueden hacer. La autoridad efectiva de un agente es la unión de sus instrucciones de modelo, los permisos de sus herramientas, la identidad de ejecución, el acceso de red y los datos que puede alcanzar. Un prompt de solo lectura no convierte en solo lectura una API capaz de escribir. Una interfaz de usuario restringida tampoco protege un token que puede llamar directamente a endpoints administrativos.
Para cada agente desplegado o en fase piloto, hay que documentar su tarea empresarial; los sistemas a los que puede llegar; las categorías de datos que puede leer; las operaciones que puede realizar; la identidad utilizada en cada operación; las condiciones que obligan a pedir aprobación humana; y el mecanismo que lo detiene. El inventario debe incluir agentes internos, asistentes alojados por proveedores, automatización de navegadores, herramientas de programación y sistemas de flujo de trabajo que llamen a servicios externos.
Los permisos deben ser estrechos tanto en alcance como en duración. Hay que conceder al agente únicamente las herramientas necesarias para la tarea actual, limitar cada herramienta a recursos concretos y separar las operaciones de lectura de las de escritura. Siempre que sea posible, conviene usar credenciales temporales, vincular el acceso a una identidad de carga de trabajo en lugar de a una cuenta compartida de empleado y revocar los privilegios elevados al terminar la tarea. Si un agente solo necesita recuperar un conjunto concreto de registros, no debería recibir un rol de base de datos capaz de enumerar a todos los clientes.
El mismo principio se aplica a los datos que devuelven las herramientas. Una herramienta debe filtrar los registros antes de introducirlos en el contexto del agente; no debe confiar en que el modelo ignore información que ya ha recibido. Los registros deben capturar suficientes metadatos estructurados para mostrar qué identidad solicitó cada recurso, qué política permitió la acción, si era necesaria una aprobación y qué cambió después. Los valores sensibles no pertenecen a los prompts ordinarios ni a los registros de diagnóstico sin redactar.
Los controles de la aplicación siguen siendo decisivos
Un agente puede ser novedoso; una aplicación que no aplica la autorización no lo es. La descripción de la AEPD dice que el agente encontró una forma de modificar datos personales y acceder a facturas después de entrar en el sistema. Hasta que haya más detalles técnicos, los propietarios de aplicaciones deberían revisar los controles que gobiernan esas dos clases de acción.
La autorización a nivel de objeto debe comprobarse en cada solicitud. El servidor debe determinar si la identidad autenticada puede leer o modificar el registro específico, en vez de confiar en un identificador suministrado por el cliente o por el agente. La autorización a nivel de función es igual de importante: una cuenta que puede consultar el perfil de un cliente no debería poder modificar automáticamente sus datos de facturación, exportar registros o cambiar la titularidad de la cuenta.
Las operaciones de escritura que afecten a registros personales, financieros u operativos deben contar con una validación independiente. Según el riesgo, esa validación puede ser un motor de políticas, un límite de transacción, un segundo servicio, una aprobación humana o una regla de flujo de trabajo inmutable. La puntuación de confianza de un modelo no es una decisión de autorización. Tampoco lo es una instrucción en lenguaje natural como «no modifiques datos sensibles» cuando la herramienta conectada sí puede modificarlos.
Las aplicaciones también deben hacer que el comportamiento seguro sea el comportamiento predeterminado. Hay que rechazar campos inesperados, validar tipos y rangos, limitar las operaciones masivas, protegerse contra la repetición, hacer caducar sesiones y tokens, y exigir una nueva autorización para los cambios de gran impacto. Los límites de velocidad no son una defensa completa, pero pueden actuar como un freno valioso cuando un proceso empieza a recorrer registros o llamar a herramientas a una velocidad anormal.
La supervisión debe detectar conductas, no solo malware
La detección tradicional suele comenzar con archivos, dominios o hashes maliciosos conocidos. Una intrusión con agentes puede no dejar ninguno de esos rastros. Las solicitudes pueden proceder de una región legítima de la nube, utilizar un cliente de API aprobado y autenticarse con un token válido. Por eso, la detección debe incluir señales de comportamiento.
Entre las señales útiles están un inicio de sesión seguido de un descubrimiento rápido por muchas funciones de la aplicación; el acceso a tipos de registros que no guardan relación con el trabajo habitual de la cuenta; solicitudes repetidas que cambian parámetros después de recibir errores; un aumento repentino de llamadas a herramientas; el acceso simultáneo a datos y funciones administrativas; secuencias inusuales de lecturas seguidas de escrituras; y actividad fuera del horario declarado para la tarea del agente. Ninguna de estas señales demuestra por sí sola un ataque dirigido por IA. Juntas pueden identificar una cuenta o un flujo de trabajo que ha salido de su límite esperado.
La telemetría debe conectar capas que a menudo se registran por separado. Los registros de identidad tienen que correlacionarse con los del gateway de API, las trazas de auditoría de la aplicación, los cambios en la base de datos, las llamadas a herramientas del agente y las salidas de red. Cuando sea posible, hay que registrar explícitamente la identidad del agente o del flujo de trabajo. Si varios agentes comparten una cuenta de servicio, la atribución se vuelve más difícil y la contención acaba siendo más amplia de lo necesario.
Las alertas deben ir acompañadas de una acción de respuesta. Un aviso que llega después de que termine una actualización masiva es menos útil que un control capaz de pausar la operación, aislar la sesión o exigir aprobación al superar un umbral. En los flujos de alto impacto, conviene diseñar un interruptor de emergencia en tiempo real que pueda desactivar el agente, revocar sus tokens, bloquear su acceso de red y detener los trabajos pendientes. «Podemos investigarlo mañana» no es un control adecuado para un proceso autónomo conectado a datos personales.
Qué deben revisar los equipos de protección de datos
El incidente se sitúa en la intersección entre la ciberseguridad y la protección de datos. En el marco del RGPD, las organizaciones evalúan el riesgo creado por una brecha de datos personales y notifican a la autoridad de control cuando se alcanza el umbral aplicable; las brechas de mayor riesgo también pueden exigir comunicación a las personas afectadas. La guía de la AEPD sobre notificación de brechas hace explícita esa estructura basada en el riesgo.
Un agente de IA no elimina la responsabilidad de la organización sobre el tratamiento que realiza. Las preguntas relevantes son conocidas: a qué datos se podía acceder, cuáles se vieron o modificaron, cuántas personas podrían estar afectadas, cuánto duró el acceso, si hubo exfiltración y qué perjuicio podría producirse. La autonomía del agente puede cambiar la probabilidad, la velocidad o el alcance del incidente, pero no sustituye la evaluación de la brecha.
Las evaluaciones de impacto relativas a la protección de datos y las evaluaciones de riesgo de seguridad deberían describir modos de fallo específicos de los agentes. Hay que considerar la inyección de prompts a través de documentos o páginas web, el uso involuntario de herramientas, el comportamiento de delegado confundido, el acceso entre inquilinos, la retención excesiva de memoria, la exposición de credenciales, la salida insegura que se entrega a otro sistema y las acciones que no pueden deshacerse. La guía de la AEPD sobre IA agéntica advierte que las cadenas de acceso sin control, el filtrado insuficiente de los argumentos de función y los límites débiles sobre el número o la categoría de accesos pueden perjudicar la minimización de datos y la seguridad.
La revisión debe abarcar las compras y los contratos, además de la ingeniería. Los contratos y los procedimientos operativos deben identificar quién puede aprobar herramientas, dónde se almacenan los prompts y los registros, cómo tratan los datos los proveedores, cómo se comunican los incidentes, cómo se revoca el acceso y cómo puede obtener la organización pruebas después de un suceso. Un sistema que no puede ofrecer registros de auditoría utilizables es difícil de gobernar, aunque su tarea anunciada parezca de bajo riesgo.
Un plan práctico de respuesta para las organizaciones
Las organizaciones no necesitan apagar todos sus proyectos piloto de IA por una sola notificación comunicada a la prensa. Sí necesitan establecer un límite claro antes de conectar un agente a sistemas reales. La siguiente secuencia ofrece un punto de partida razonable para los equipos de seguridad, ingeniería y privacidad.
-
Localizar la autoridad. Inventariar agentes, plugins, automatizaciones de navegador, integraciones de API y cuentas de servicio. Para cada elemento, enumerar los sistemas alcanzables, las clases de datos y las capacidades de escritura. Hay que incluir los experimentos informales que utilicen credenciales de la empresa.
-
Reducir el radio de impacto. Sustituir las credenciales compartidas y de larga duración por identidades de carga de trabajo de vida corta. Retirar herramientas que no se usen, separar los entornos, restringir las salidas de red y limitar el acceso al conjunto mínimo de datos que permita realizar la tarea. Una herramienta capaz de ejecutar código arbitrario o de acceder sin restricciones a la red debe tratarse como una integración de alto riesgo.
-
Poner fricción ante las acciones irreversibles. Exigir autorización independiente para exportaciones masivas, cambios de registros, pagos, recuperación de cuentas, modificaciones de permisos y borrados. Establecer límites de transacciones y volumen. La política de aprobación debe poder hacerse cumplir en el código y en la aplicación posterior.
-
Instrumentar el flujo de trabajo. Registrar llamadas a herramientas, identidades, decisiones de política, aprobaciones, identificadores de recursos y cambios resultantes. Correlacionarlos con los datos de autenticación y red. Redactar las credenciales y la información personal innecesaria en los registros.
-
Practicar la contención. Revocar las credenciales del agente, detener los trabajos pendientes, bloquear el tráfico saliente y restaurar un estado conocido como seguro en una prueba controlada. Medir cuánto se tarda y qué equipo es responsable de cada paso. Un interruptor de emergencia que nunca se ha probado es solo una suposición.
-
Revisar el proceso de brecha de datos. Definir cuándo participan el equipo de seguridad, la oficina de privacidad, el área jurídica, el proveedor y el responsable del negocio afectado. Conservar las pruebas sin mantener el acceso del agente. El registro del incidente debe ser factual: separar las observaciones confirmadas de las hipótesis sobre cómo se dieron las instrucciones al agente o cómo se obtuvieron las credenciales.
Este plan sigue la orientación general del National Cyber Security Centre británico y de OWASP: empezar con casos de uso de bajo riesgo y alcance limitado; aplicar el principio de mínimo privilegio; utilizar aislamiento y controles de red; mantener una supervisión humana significativa; vigilar el comportamiento; y garantizar que alguien pueda detener el sistema. Los controles no dependen de un único proveedor de modelos. Precisamente por eso siguen siendo útiles mientras los hechos del incidente español continúan incompletos.
Qué no debe concluirse de esta historia
El informe no demuestra que los modelos de lenguaje hayan adquirido una intención independiente. Demuestra, si se confirma el relato de la notificación, que una persona configuró o desplegó un sistema automatizado capaz de perseguir un objetivo mediante herramientas conectadas. La responsabilidad sigue pasando por las personas y organizaciones que crearon el acceso, expusieron la aplicación y operaron el sistema.
Tampoco demuestra que la revisión humana sea inútil. La revisión continúa siendo valiosa cuando se coloca en los puntos adecuados: antes de conceder autoridad, antes de habilitar operaciones de gran impacto, cuando la conducta supera un umbral y durante la contención. Se vuelve ineficaz cuando se espera que inspeccione cada acción de bajo nivel después de que el agente haya recibido permisos amplios y pueda actuar más deprisa de lo que una persona puede responder.
Por último, la historia no es un argumento para comprar un producto etiquetado como «seguridad de IA». La detección, la gobernanza de identidades, el diseño seguro de aplicaciones, la gestión de vulnerabilidades, la segmentación, las copias de seguridad y una respuesta ante incidentes ensayada siguen siendo importantes. Un agente puede dejar al descubierto debilidades en esos controles, pero no los vuelve obsoletos.
La lección central es la seguridad de siempre, con menos tiempo para reaccionar
La primera notificación española de una brecha atribuida a un agente de IA es significativa porque da una forma operativa concreta a una preocupación abstracta: acceso válido, descubrimiento automatizado, debilidad de una aplicación, exposición de datos personales y modificación no autorizada. Los hechos pueden aclararse a medida que la AEPD analice la notificación. Hasta entonces, la respuesta defendible consiste en actuar sobre los fallos de control que el relato pone de manifiesto sin afirmar más de lo que permite la evidencia.
Las organizaciones que despliegan agentes deben saber exactamente a qué puede llegar cada identidad, qué puede hacer cada herramienta y qué acciones requieren una decisión separada. Deben detectar pronto los comportamientos anómalos, revocar el acceso de inmediato y conservar pruebas suficientes para determinar qué ocurrió. El objetivo no es entrar en pánico ante un atacante de IA. Es garantizar que un flujo de trabajo automatizado no pueda convertir una credencial o un fallo de aplicación en un incidente antes incluso de que los defensores hayan leído la primera alerta.
Fuentes
- Primera notificación de una brecha de datos personales causada por un ataque ejecutado mediante un agente de IA, Agencia Española de Protección de Datos.
- Notificación de brechas de datos personales a la autoridad de control, Agencia Española de Protección de Datos.
- Orientaciones sobre inteligencia artificial agéntica desde la perspectiva de la protección de datos, Agencia Española de Protección de Datos.
- Managing the cyber risk of agentic AI, National Cyber Security Centre del Reino Unido.
- Thinking carefully before adopting agentic AI, National Cyber Security Centre del Reino Unido.
- AI Agent Security Cheat Sheet, OWASP GenAI Security Project.
- Spain gets its first taste of AI-aided cyber attack, The Register.
- Primera brecha de dato ejecutada por un agente de inteligencia artificial de forma autónoma, Cinco Días / EL PAÍS.
Related articles
Una clave AWS filtrada sigue siendo acceso hasta que se rota y se borra
Truffle Security volvió a probar miles de claves AWS que ya habían aparecido en artefactos públicos. La señal preocupante no es solo la fuga: muchas seguían funcionando años después, incluso claves root y AdministratorAccess.
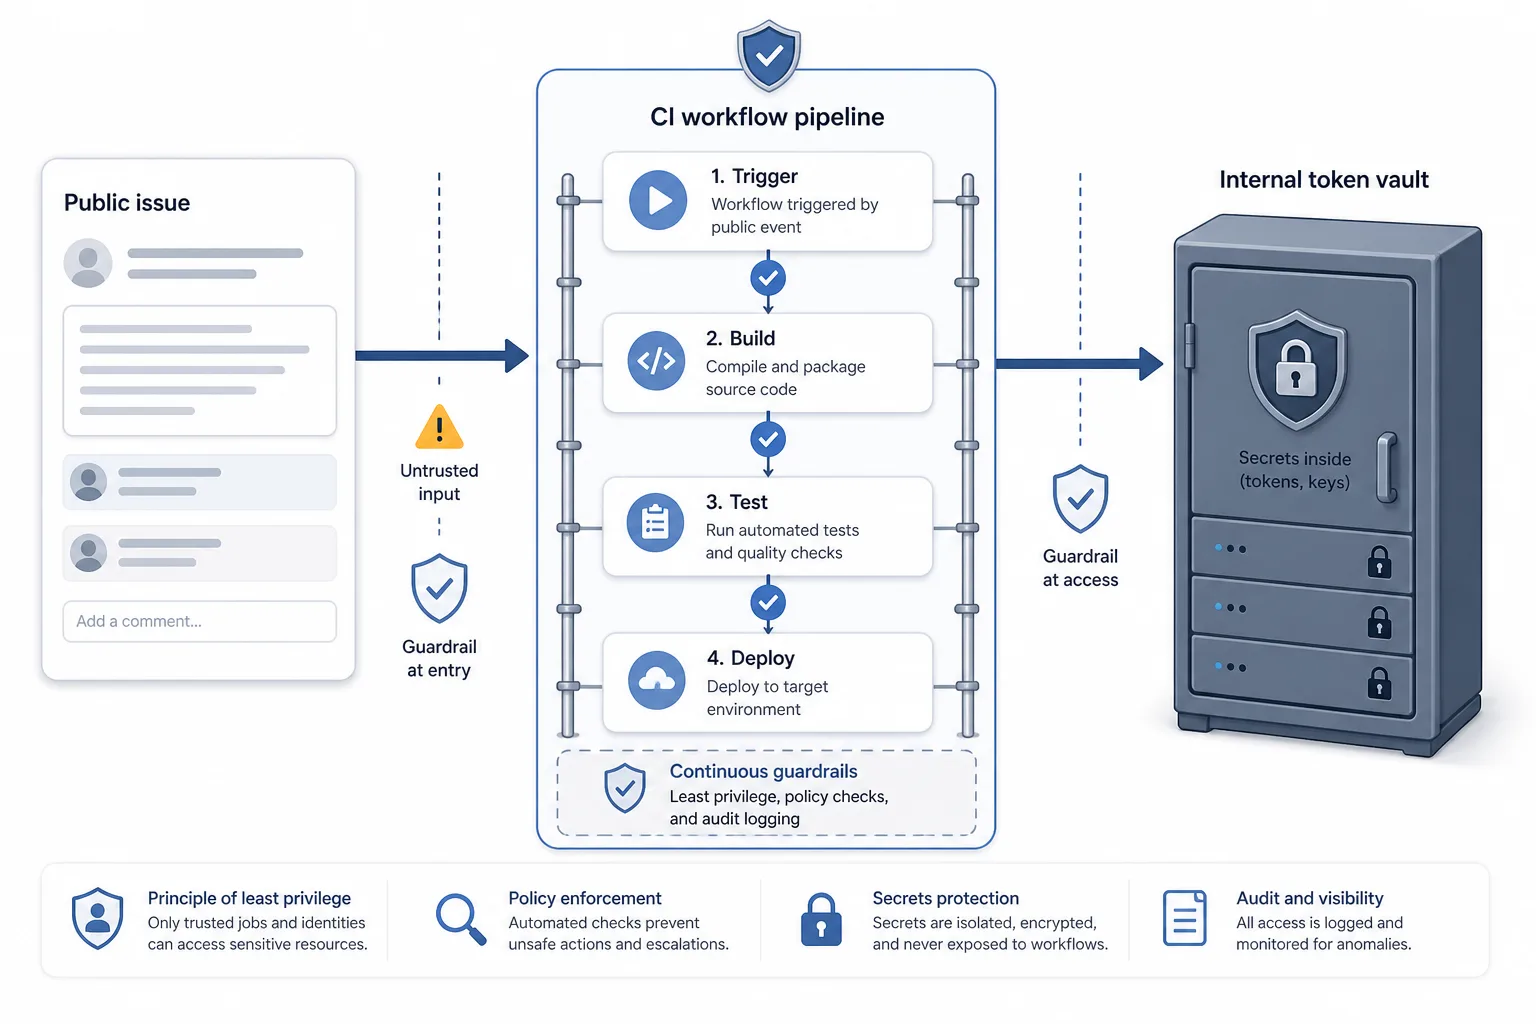
La lección de Snowflake sobre GitHub Actions: cuando un issue público entra en CI/CD
El caso de Wiz Red Agent no prueba una brecha de clientes de Snowflake. Advierte con calma que eventos públicos de repositorios, automatización en YAML y tokens internos duraderos requieren controles de producción.
La cabina de DJ ya es una red: qué significa la vulnerabilidad de PRO DJ LINK y rekordbox
Una lectura tranquila del aviso de AlphaTheta: por qué el acceso a la red local importa y qué deberían hacer DJs, locales y técnicos antes del próximo show.

Las facturas cloud ya son sistemas de producción
Las estimaciones imposibles de AWS no fueron cargos reales, pero mostraron que las alertas de coste ya forman parte de la respuesta a incidentes.
Comments
Sign in to comment.
No comments yet.