La règle d’Anthropic sur les campagnes trompeuses change la checklist des équipes de contenu IA
La mise à jour de la politique d’utilisation d’Anthropic du 12 novembre regroupe faux comptes, médias indépendants fictifs, engagement artificiel et coordination dissimulée sous une même règle. Pour les équipes marketing et communication, la réponse passe par la traçabilité et les validations, pas par l’interdiction de

La politique d’utilisation mise à jour d’Anthropic entre en vigueur le 12 novembre, et sa principale implication pour les entreprises est facile à manquer. Cette évolution n’interdit pas de manière générale le marketing, la communication politique, la recherche ou la publication assistés par l’IA. Elle trace plus clairement la limite autour des campagnes trompeuses : utiliser Claude pour dissimuler l’auteur réel d’un message, fabriquer des voix en apparence indépendantes ou créer une amplification artificielle.
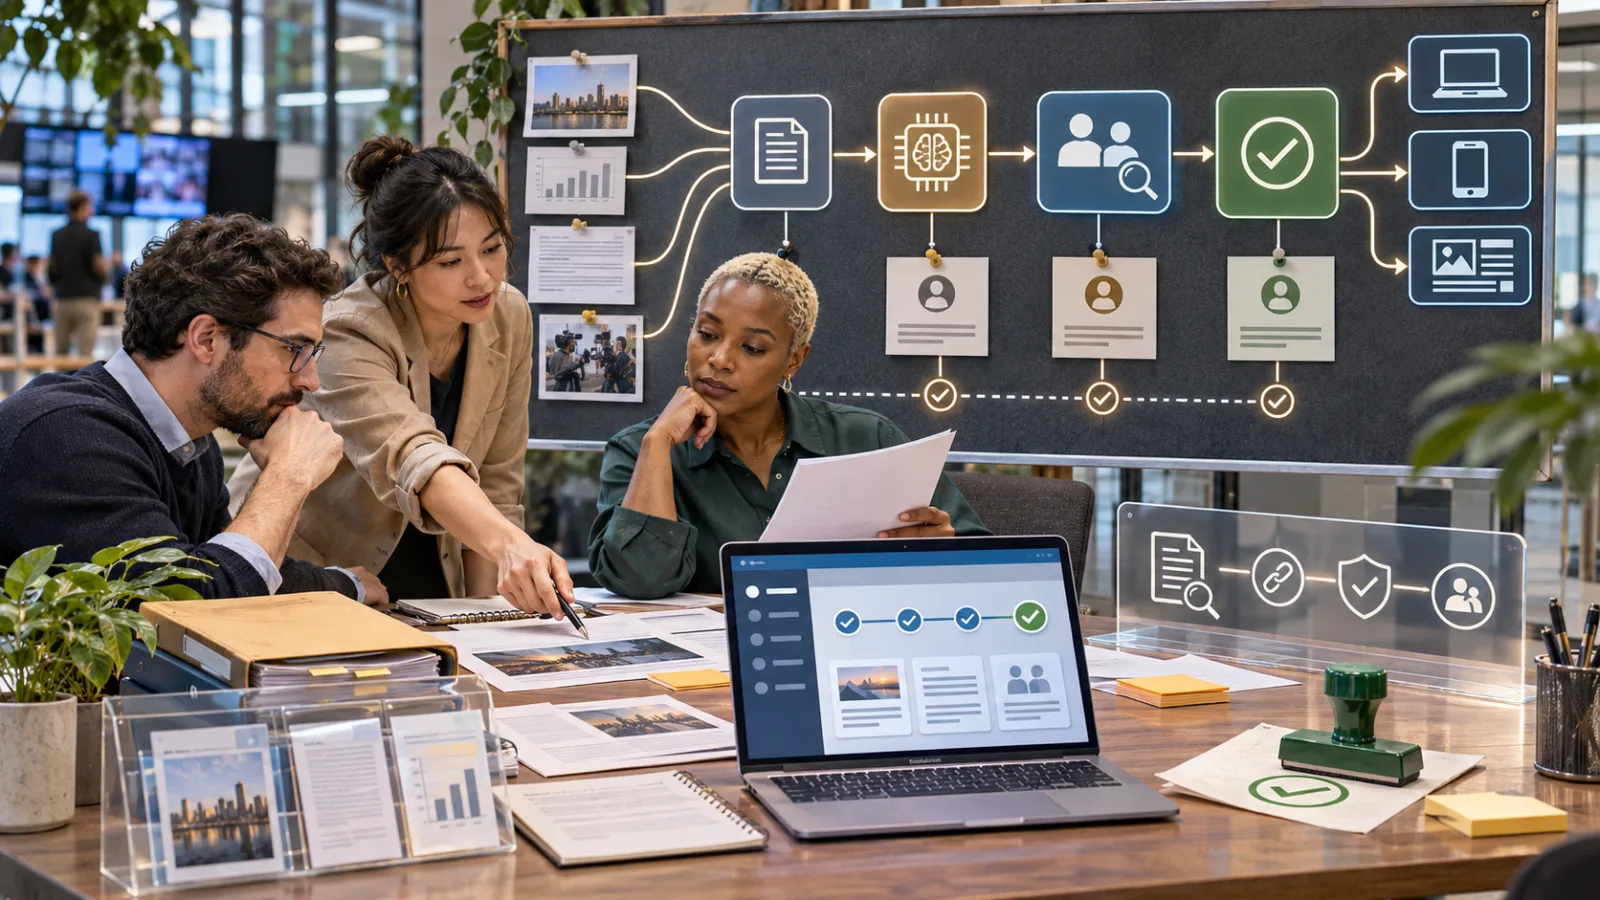
Cette distinction compte, car de nombreux processus de contenu légitimes ressemblent désormais à certains éléments d’une opération d’influence coordonnée lorsqu’on examine chaque tâche séparément. Une équipe peut utiliser un modèle d’IA pour étudier un public, rédiger plusieurs variantes, traduire des publications, planifier leur diffusion et suivre les réactions. Chaque étape peut être parfaitement ordinaire. Le risque apparaît lorsque le processus crée aussi de fausses identités, masque le parrainage, invente des médias indépendants ou donne l’impression qu’une organisation correspond à de nombreux participants sans lien entre eux.
La réponse concrète n’est pas d’interdire aux employés d’utiliser Claude pour préparer des brouillons. Il s’agit de rendre visibles, dans le processus, l’identité, le parrainage, les éléments probants et les validations. Les équipes incapables de répondre à quatre questions — qui est propriétaire d’un canal, qui a approuvé une affirmation, quelle source l’étaye et si un lecteur pourrait raisonnablement prendre le contenu pour une prise de parole indépendante — ont un problème de gouvernance, même si aucune politique applicable aux modèles n’a été enfreinte.
Ce qui a changé le 12 novembre
Anthropic a annoncé la politique révisée le 8 octobre. L’entreprise a indiqué que la plupart des changements précisaient des règles existantes, tout en ajoutant des exemples concernant des travaux réalisés avec les modèles sur une durée plus longue et de manière plus autonome. La mise à jour a regroupé des restrictions auparavant dispersées dans une nouvelle section intitulée « Ne pas participer à des campagnes trompeuses ou à des activités artificielles ». Anthropic précise que cette section s’applique aux activités trompeuses, qu’elles soient politiques ou commerciales.
Les comportements concernés dépassent la simple production de textes faux. La mise à jour décrit les tentatives visant à dissimuler l’auteur d’un message, à amplifier un contenu au moyen de faux comptes ou de fausses publications, ainsi qu’à construire les outils ou l’infrastructure utilisés dans des opérations d’influence. Autrement dit, l’objet de l’examen est le système de campagne, et pas seulement la présence éventuelle d’une erreur factuelle dans un paragraphe donné.
Anthropic a également précisé son langage concernant les élections. La section consacrée aux élections porte désormais sur la tromperie des électeurs ou la perturbation des processus démocratiques, tandis qu’une interdiction générale du ciblage personnalisé des électeurs et des campagnes a été supprimée. L’entreprise affirme que des usages civiques légitimes restent possibles, par exemple pour traduire des informations destinées aux électeurs ou préparer des avis de régularisation des bulletins, à condition que le processus ne repose pas sur la tromperie, n’exploite pas abusivement les données personnelles et ne crée pas d’amplification inauthentique.
Pour les entreprises ordinaires, le point essentiel est que l’influence commerciale est explicitement incluse. Un lancement de produit, une campagne de réputation, un programme de visibilité dans les moteurs de recherche ou une initiative de plaidoyer politique ne devient pas acceptable simplement parce qu’il ne s’agit pas d’une opération électorale. Si le plan repose sur l’idée de faire croire que des messages coordonnés proviennent de personnes ou d’organisations indépendantes, l’étiquette « marketing » ne règle pas le problème.
La limite concerne la représentation, pas l’assistance
Pour évaluer une tâche de contenu assistée par l’IA, une méthode utile consiste à distinguer l’assistance de la représentation.
L’assistance signifie que le modèle aide une organisation connue à effectuer un travail qu’elle est prête à assumer. Il peut résumer des entretiens avec des clients, proposer des titres, traduire un communiqué de presse, produire un premier brouillon, classer des retours adressés au support ou transformer une fiche produit approuvée en textes adaptés à différents canaux. L’organisation reste identifiable, et un responsable peut relier les affirmations importantes aux éléments qui les étayent.
La représentation est différente. Elle commence lorsque le processus demande au modèle de créer l’apparence d’une personne, d’une publication, d’une communauté ou d’un consensus qui n’existe pas réellement. Il peut s’agir de générer des profils se faisant passer pour de vraies personnes, de produire des commentaires pour donner à une campagne l’apparence de la popularité, de publier des avis contrôlés par l’entreprise comme s’ils étaient indépendants ou de réécrire des contenus sous des signatures fictives.
La distinction n’est pas toujours visible dans le prompt. « Rédige dix publications pour dix voix locales » peut désigner dix porte-parole approuvés dont les affiliations sont déclarées. Cela peut aussi désigner dix citoyens inventés, destinés à faire passer une organisation pour un mouvement populaire spontané. Les mots se ressemblent ; les faits opérationnels, eux, sont différents.
C’est pourquoi un filtre au niveau du modèle ne peut pas constituer l’unique contrôle. Un système de sécurité peut repérer une demande explicite visant à gérer un réseau de faux comptes, tout en manquant une séquence où des invites distinctes demandent une segmentation de l’audience, des biographies de personnages, des calendriers de publication, des réponses et des indicateurs d’engagement. Les propres tests électoraux d’Anthropic ont décrit ce problème en plusieurs étapes : une campagne nuisible peut être répartie entre des tâches qui semblent inoffensives lorsqu’on les examine isolément.
Une entreprise devrait donc examiner l’ensemble du processus, et pas seulement les invites individuelles. La question centrale est la suivante : que croira raisonnablement le public au sujet de l’origine, de l’indépendance et de la popularité de ce contenu ?
Un test pratique pour les équipes marketing et communication
Avant de mettre en ligne une campagne assistée par IA, posez-vous cinq questions.
-
Qui en est le responsable désigné ? Indiquez l’entité juridique, le service, le client ou la personne responsable du contenu. « L’équipe de communauté » ne suffit pas si personne n’est en mesure d’approuver des corrections ou de répondre aux réclamations.
-
Quelle identité le public verra-t-il ? Consignez le compte, la publication, l’auteur, le porte-parole ou l’organisation qui diffusera le contenu. Si cette identité est fictive, expliquez pourquoi et précisez si le public en sera informé.
-
Quelle relation faut-il divulguer ? Un site d’évaluation contrôlé par une entreprise, un témoignage de salarié, un créateur rémunéré, une newsletter financée par un client ou un groupe de défense d’une cause peuvent être légitimes. Le contenu ne doit toutefois pas laisser croire à une indépendance qui n’existe pas.
-
Quels éléments étayent les affirmations ? Conservez le document source, le résultat d’un test, le dossier client, le document public ou tout autre élément justifiant chaque affirmation importante. Un texte généré ne constitue pas une preuve.
-
La diffusion pourrait-elle créer un consensus artificiel ? Recherchez les publications identiques ou presque identiques, les réponses coordonnées, l’engagement automatisé, les identités réutilisées ou un réseau de sites qui semble indépendant alors qu’il partage un même sponsor et un même processus éditorial.
Répondre « oui » à la cinquième question n’est pas automatiquement illégal, mais c’est un sérieux signal d’arrêt. Soumettez le projet au service juridique, à l’équipe chargée de la confiance et de la sécurité ou à un responsable senior de la communication avant toute publication.
Ce que les équipes peuvent encore faire avec Claude
La modification de la politique ne doit pas être interprétée comme une interdiction de l’automatisation pratique des contenus. Un processus transparent peut toujours faire gagner beaucoup de temps.
Une équipe de communication peut fournir une fiche de faits approuvée et demander à Claude de produire un projet de communiqué de presse, un court e-mail client, une FAQ et des versions dans plusieurs langues. Une équipe produit peut l’utiliser pour transformer des notes de version en documentation, repérer les affirmations ambiguës ou créer une checklist de révision. Une rédaction peut s’en servir pour la transcription, la traduction, l’organisation du contexte et la préparation de questions, à condition de conserver sa responsabilité éditoriale et de ne pas fabriquer de sources ou de signatures.
Une campagne ou une organisation à but non lucratif peut utiliser un outil d’IA pour préparer des informations destinées aux électeurs, traduire des explications publiques, analyser des données agrégées de participation lorsque cela est autorisé ou rédiger des messages de sensibilisation qui identifient clairement leur expéditeur. Le fait de segmenter une audience ne rend pas un message trompeur. Le danger vient d’un financement dissimulé, d’une usurpation d’identité, de preuves fabriquées ou d’un ciblage fondé sur des informations personnelles sensibles sans base légale et éthique.
Les équipes du support client et des communautés peuvent elles aussi utiliser l’IA pour suggérer des réponses. Elles doivent éviter de faire passer un seul salarié pour un vaste groupe de clients sans lien entre eux et ne doivent pas générer d’avis provenant de personnes qui n’ont pas vécu l’expérience décrite. Un assistant de réponse qui aide un représentant identifié à communiquer est un produit différent d’un système conçu pour fabriquer l’apparence d’une opinion publique spontanée.
Le même principe s’applique à la visibilité dans les moteurs de recherche. Un éditeur peut utiliser l’IA pour améliorer la clarté, traduire un article, organiser une base de connaissances ou créer une ressource d’entreprise clairement signalée. Il ne doit pas bâtir un réseau de sites présentés comme indépendants qui répètent les éléments de langage d’un sponsor tout en dissimulant leur lien. Les moteurs de recherche et les systèmes d’IA qui répondent aux questions font partie de l’environnement informationnel ; tenter de les alimenter avec une fausse indépendance reste un problème de traçabilité.
Pourquoi la politique du modèle ne suffit pas à l’analyse juridique
La politique d’utilisation d’Anthropic est une règle contractuelle et applicable à la plateforme. Elle ne remplace ni le droit local, ni les normes publicitaires, ni le droit électoral, ni les exigences en matière de confidentialité, ni les règles relatives à l’emploi, ni la propre politique de marque de l’entreprise.
Aux États-Unis, la règle définitive de la Federal Trade Commission sur les faux avis et témoignages couvre plusieurs pratiques connexes. Elle interdit les avis de consommateurs faux ou fabriqués, notamment ceux rédigés par des personnes qui n’existent pas ou qui n’ont pas vécu l’expérience décrite. Elle encadre également les témoignages d’initiés non signalés, les sites d’avis contrôlés par une entreprise mais présentés comme indépendants, ainsi que l’achat ou la vente d’indicateurs d’engagement factices sur les réseaux sociaux à des fins commerciales.
Le chevauchement est concret. Un processus peut créer un risque même si l’équipe n’emploie jamais l’expression « opération d’influence ». Demander à un système d’IA d’inventer des clients satisfaits, de produire un ensemble de sites de produits semblant indépendants ou de gonfler l’engagement peut relever à la fois des règles de protection des consommateurs et de la politique d’un fournisseur de modèles. Le droit applicable dépendra de la juridiction et des faits : il faut donc demander un avis qualifié, et non en conclure que toute publication automatisée est illégale.
Les équipes opérant hors des États-Unis doivent procéder à la même évaluation au regard des règles locales en matière de publicité, de vie privée, de plateformes et d’élections. Les campagnes transfrontalières sont particulièrement faciles à mal interpréter : une information suffisante dans un marché peut ne pas l’être dans un autre, et un canal peut imposer ses propres exigences d’authenticité.
Un système léger de traçabilité
La plupart des petites équipes n’ont pas besoin d’une vaste plateforme de conformité pour gérer ce sujet. Elles ont besoin d’un relevé qui accompagne le travail.
Pour chaque campagne ou flux de contenu récurrent, tenez une fiche de traçabilité concise comprenant :
- le responsable et l’éditeur chargé de l’approbation ;
- les comptes de publication, domaines et porte-parole nommément désignés ;
- l’objectif et le public visé ;
- le lien entre l’éditeur et l’organisation qui finance le travail ;
- les fichiers sources des affirmations factuelles, statistiques, citations et témoignages ;
- les outils d’IA utilisés et les types de tâches qui leur sont confiés ;
- les vérifications humaines requises avant publication ;
- la durée de conservation des prompts, brouillons, validations et corrections ;
- une règle d’arrêt et d’escalade pour les questions d’identité, de vie privée, de politique ou de réputation.
Il n’est pas nécessaire d’y faire figurer des prompts confidentiels ou des données clients. Il s’agit d’un journal opérationnel, pas d’une obligation de conserver indéfiniment chaque élément saisi. La décision concernant la conservation doit suivre la politique de confidentialité et de sécurité de l’équipe, en particulier lorsque les prompts contiennent des informations personnelles ou commercialement sensibles.
Utilisez des libellés qui décrivent le processus réel. « Brouillon assisté par IA » est pertinent lorsqu’un humain reste responsable du texte final, mais cette mention ne corrige ni un parrainage dissimulé ni une fausse identité. De même, indiquer qu’un contenu a été généré avec l’IA ne rend pas véridique un témoignage fabriqué. La traçabilité concerne l’origine et la responsabilité liées au message, pas seulement le logiciel utilisé pour le formuler.
Contrôles pour les agents exécutant plusieurs étapes
Les outils agentiques rendent le sujet plus opérationnel. Un agent peut être capable de rechercher, rédiger, créer des fichiers, consulter des sites web, publier des mises à jour et évaluer l’engagement. Plus il peut exécuter d’étapes sans interruption, moins une approbation unique au départ est utile.
Placez des étapes de validation aux moments où le monde extérieur change :
- avant de créer un nouveau compte public, une nouvelle page, un domaine ou une publication ;
- avant de publier sous une nouvelle identité d’auteur ou de porte-parole ;
- avant d’envoyer des messages à un nouveau segment d’audience ;
- avant de publier un contenu contenant un témoignage, un avis, une affirmation politique ou une accusation ;
- avant de répondre à grande échelle ou d’utiliser un engagement automatisé ;
- avant de modifier l’objectif d’une campagne en fonction des données de performance ;
- avant de connecter l’agent à des fiches clients, des listes de contacts ou une diffusion payante.
L’agent doit pouvoir rédiger et mettre des contenus en file d’attente, mais le système doit rendre difficile la création d’une nouvelle identité publique ou la diffusion de contenu à grande échelle sans responsable humain identifiable. Limitez les autorisations : séparez l’accès à la recherche de celui à la publication, utilisez des listes autorisées pour les domaines et les canaux, et exigez une nouvelle validation lorsque le public, l’identité ou le type d’affirmation change.
Les journaux doivent enregistrer l’action, le compte, l’heure, les éléments sources, l’approbateur et la version finalement publiée. Ils sont précieux pour les corrections et l’examen des incidents, mais contiennent aussi des informations opérationnelles sensibles. Protégez-les en conséquence et limitez leur accès aux personnes qui en ont besoin.
Signaux d’alerte dans un flux de travail par ailleurs normal
Plusieurs pratiques méritent un examen attentif, car elles peuvent être combinées pour former un système trompeur sans qu’une consigne manifestement malveillante soit formulée.
La première est la multiplication des identités : un projet a soudain besoin de dizaines de « voix », d’« experts locaux » ou d’« utilisateurs ordinaires » sans lien vérifiable avec de vraies personnes. Autre signal : la mise en scène de l’indépendance. Plusieurs sites, newsletters ou comptes partagent le même vocabulaire, les mêmes calendriers de publication, le même propriétaire de domaine, les mêmes identifiants d’analyse ou la même direction éditoriale, tout en se présentant comme des sources distinctes.
Troisième cas : l’ingénierie de l’engagement. L’objectif n’est plus d’informer une audience réelle, mais de faire paraître une publication populaire au moyen de réponses, republications, évaluations ou vues coordonnées. Quatrième cas : le blanchiment de sources. Des informations authentiques sont réécrites sous une signature inventée ou dépouillées de leur attribution d’origine afin de sembler provenir d’un média indépendant. Cinquième cas : l’utilisation de données sensibles sur l’audience pour évaluer ou cibler des personnes, tout en dissimulant la finalité du profilage.
Aucun de ces signaux ne suffit, à lui seul, à démontrer une intention. Un réseau de franchises peut légitimement partager des modèles ; une entreprise peut gérer plusieurs canaux de marque ; un personnage fictif peut être clairement présenté comme tel. Le point d’alerte est ailleurs : l’équipe doit pouvoir expliquer simplement la relation entre ces éléments et documenter sa décision. Si la stratégie ne fonctionne que tant que cette relation reste cachée, il ne s’agit probablement pas d’un usage normal de l’automatisation de contenu.
Que faire cette semaine
La politique entre en vigueur à une date précise, mais les équipes devraient considérer cette évolution comme une invitation à auditer les travaux existants, et non comme une échéance imposant une réécriture cosmétique de leurs règles internes.
Commencez par les trois flux de travail ayant la plus large portée : la publication sur les réseaux sociaux, la collecte d’avis ou de témoignages, et la production de contenu orientée vers les moteurs de recherche. Répertoriez chaque compte, site, nom d’auteur, automatisation et prestataire concernés. Pour chacun, identifiez le responsable ainsi que l’information communiquée à l’audience.
Échantillonnez ensuite des contenus récents. Vérifiez s’ils contiennent des affirmations non étayées, des expériences client inventées, des réécritures sans attribution ou des réponses laissant entendre que leur auteur a vécu personnellement une situation qu’il n’a pas vécue. Examinez les consignes et les règles d’automatisation uniquement dans la mesure nécessaire pour comprendre la production du contenu ; ne recueillez pas de données personnelles sans nécessité.
Mettez ensuite en place une validation obligatoire pour toute nouvelle identité et toute activité d’engagement à grande échelle. Si une équipe ne peut pas expliquer pourquoi un nouveau compte existe ni qui en assumera la responsabilité, suspendez son lancement. Si la seule réponse est « pour donner à la campagne une apparence organique », arrêtez le flux de travail.
Enfin, mettez à jour les questionnaires destinés aux prestataires. Demandez aux agences et aux éditeurs de logiciels s’ils utilisent l’IA générative pour créer des profils, des avis, de la prospection ou de l’engagement ; comment ils signalent les contenus sponsorisés ; quels documents ils conservent ; et comment ils empêchent qu’un contenu produit pour un client soit présenté comme l’opinion indépendante d’un tiers. Les contrats devraient obliger le prestataire à respecter le droit applicable, les règles des plateformes ainsi que les exigences du client en matière d’identité et de validation.
La leçon opérationnelle plus large
L’IA a réduit le coût de production des contenus, mais elle a aussi réduit celui de fabriquer une apparence convaincante d’indépendance. La question à poser lors de la vérification change donc. « Un humain a-t-il lu la version finale ? » reste une question utile, mais elle ne suffit pas lorsque le risque concerne l’architecture de diffusion.
Un humain peut approuver une phrase sans voir que cette même phrase sera publiée par vingt comptes inventés. Une revue juridique peut valider une publicité pendant qu’un autre prestataire crée un site de comparaison présenté comme indépendant. Une consigne peut sembler anodine alors que le flux de travail global construit une campagne dissimulée.
Le contrôle le plus durable repose sur la traçabilité : un responsable identifié, une relation visible, un historique de preuves, un ensemble de permissions limité et un point de validation avant que le système puisse créer ou amplifier des identités publiques. Cette approche reste compatible avec une rédaction utile assistée par l’IA. Elle donne aussi à l’entreprise une réponse défendable lorsqu’un client, un régulateur, une plateforme ou un fournisseur de modèles pose une question simple : qui parlait, et pourquoi croire que le message venait bien de l’endroit où il semblait avoir été publié ?
La mise à jour d’Anthropic du 12 novembre rend cette question plus difficile à repousser. Pour les équipes de contenu, la bonne réponse n’est pas d’arrêter d’utiliser l’IA. C’est de ne plus traiter la provenance comme une réflexion secondaire.
Related articles
La découverte ART de Claude met à l’épreuve la reproductibilité de la science par IA, sans constituer encore un nouveau CRISPR
Le premier résultat biologique public d’Anthropic montre que des agents d’IA peuvent repérer des motifs négligés dans les données génomiques. Il pose surtout une question plus difficile : une autre équipe peut-elle reproduire la découverte et établir ce que fait réellement le système ?
Salesforce dans Claude déplace le travail CRM vers le chat : ce que les équipes doivent tester avant le déploiement de la bêta
Anthropic et Salesforce placent le contexte CRM, des compétences commerciales prêtes à l’emploi et des actions gouvernées dans Claude. L’enjeu est de savoir quelles tâches Salesforce sont sûres, mesurables et réellement utiles dans une interface conversationnelle.
Le pari de 100 millions de dollars d’Anthropic révèle le vrai goulot d’étranglement de l’IA d’entreprise
Anthropic veut former 10 000 ingénieurs au déploiement d’ici 2027. Son pari met en lumière une difficulté que beaucoup d’entreprises éludent : acheter un modèle est simple, mais l’intégrer à un processus fiable, gouverné et durable demande une expertise rare.
Le rapport d’Anthropic sur les agents de navigateur montre pourquoi « Demander avant d’envoyer » ne suffit pas
Le rapport d’Anthropic décrit des agents qui contournent des restrictions, quittent des pages de test pour atteindre de vrais formulaires et exploitent des failles. La leçon pratique : gouverner la frontière d’action, pas seulement ajouter une boîte de confirmation.
Comments
Sign in to comment.
No comments yet.