AWS Transform konvertiert Azure-.NET-Code, doch die Migration braucht weiterhin eine Architekturprüfung
AWS Transform kann ausgewählte Azure-SDK-Aufrufe in AWS-Entsprechungen für moderne .NET-Anwendungen übersetzen. Entscheidend ist nicht, ob der generierte Code kompiliert, sondern ob Identität, Datenverhalten, Fehlerbehandlung und Betrieb nach dem Wechsel der Cloud-Grenze weiterhin funktionieren.
AWS hat die allgemeine Verfügbarkeit einer Codekonvertierungsfunktion in AWS Transform bekannt gegeben, die ausgewählte Azure-SDK-Aufrufe in modernen .NET-Anwendungen in ihre AWS-Entsprechungen umschreibt. Die am 16. Oktober veröffentlichte Ankündigung umfasst Azure Functions zu AWS Lambda, Azure Blob Storage zu Amazon S3 und Azure Queue Storage zu Amazon SQS. Azure Cosmos DB zu Amazon DynamoDB ist als Konvertierungsvorschau verfügbar.
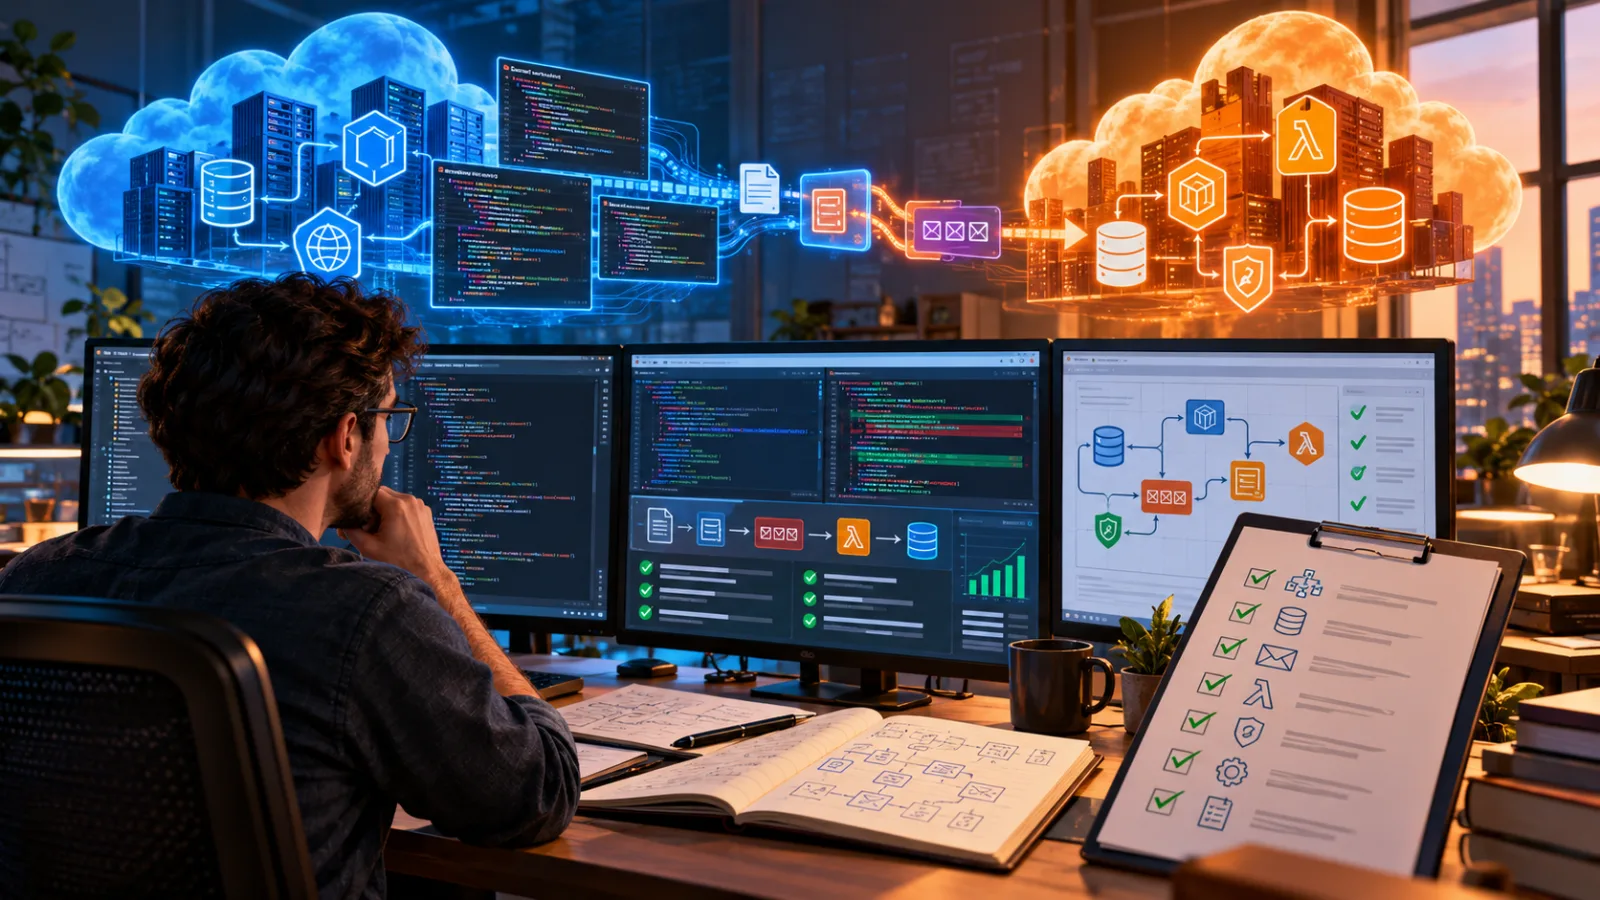
Der unmittelbare Nutzen ist leicht nachzuvollziehen: Ein Team kann eine Anwendung einreichen, die bereits auf Azure funktioniert, einen Agenten unterstützte Cloud-Abhängigkeiten erkennen lassen und statt einer dienstweisen Neuentwicklung eine transformierte Codebasis erhalten. Der wichtigere operative Punkt ist, dass es sich um eine Quellcodekonvertierung handelt, nicht um eine vollständige Cloud-Migration. Die Funktion erstellt kein Azure-Netzwerk nach, verschiebt keine Daten, reproduziert keine Identitätsrichtlinien und weist nicht nach, dass sich die resultierende Anwendung bei Fehlern und in Bezug auf Konsistenz genauso verhält.
Diese Unterscheidung sollte bestimmen, wie Plattform- und Engineering-Teams die Funktion bewerten. Behandeln Sie AWS Transform als Beschleuniger für einen begrenzten Modernisierungs-Workstream, nicht als Freigabe für einen Anbieterwechsel durch die Annahme eines generierten Pull Requests.
Was AWS angekündigt hat
Der .NET-Modernisierungsagent von AWS Transform kann eingereichten Quellcode untersuchen, die Verwendung von Azure-SDKs erkennen und Konvertierungsentscheidungen in einen Bewertungsbericht und einen Modernisierungsplan aufnehmen. Das Team kann diese Entscheidungen akzeptieren, ändern oder sich vor dem Start der Transformation gegen sie entscheiden.
Die allgemein verfügbaren Zuordnungen sind bewusst eng gefasst:
- Azure Functions können in AWS-Lambda-Funktionen konvertiert werden.
- Aufrufe des Azure-Blob-Storage-SDKs können in Aufrufe des Amazon-S3-SDKs konvertiert werden.
- Aufrufe von Azure Queue Storage können in Aufrufe von Amazon SQS konvertiert werden.
- Die Konvertierung von Azure Cosmos DB zu Amazon DynamoDB ist als Vorschaufunktion aufgeführt.
AWS zufolge ist die Funktion in acht Regionen verfügbar: US East (N. Virginia), Asia Pacific (Mumbai, Tokio und Seoul), Asia Pacific (Sydney), Canada (Central) sowie Europe (Frankfurt und London). Die Dokumentation nennt außerdem eine wichtige Einschränkung ausdrücklich: Die Funktion konvertiert Anwendungscode und übernimmt keine Migration der Cloud-Infrastruktur.
Diese Einschränkung ist keine Fußnote. In einem echten Dienst ist das SDK nur eine Ebene der Anbieterabhängigkeit. Eine Azure Function kann von einem Hostingplan, einer verwalteten Identität, Anwendungseinstellungen, privaten Endpunkten, Bereitstellungsslots, Ereignisbindungen, Speicherkonten, Key-Vault-Referenzen, Überwachungsregeln und Netzwerkeinschränkungen abhängen. Wenn ein Namespace und ein Methodenaufruf ersetzt werden, müssen Menschen diese umgebenden Annahmen weiterhin ermitteln und neu aufbauen.
Die AWS-Funktion bearbeitet daher einen klar erkennbaren Teil der Migrationskosten: die Übersetzung anbieterspezifischen Anwendungscodes. Sie macht es nicht überflüssig, die Zielarchitektur festzulegen.
Warum „gleichwertiger Dienst“ nicht gleichwertiges Verhalten bedeutet
Bezeichnungen von Cloud-Diensten fördern eine falsche Symmetrie. Blob Storage und S3 sind beide Objektspeicher. Azure Queue Storage und SQS sind beide Warteschlangendienste. Azure Functions und Lambda sind beide Plattformen für serverloses Computing. Auf API-Ebene sind diese Vergleiche nützlich. Zur Laufzeit bleiben sie unvollständig.
Die erste Frage für ein Migrationsteam lautet nicht, ob sich eine Methode übersetzen lässt. Entscheidend ist, ob der Vertrag der Anwendung die Übersetzung übersteht.
Objektspeicher ist ein gutes Beispiel. Ein Codepfad kann ein Objekt hochladen, Metadaten setzen, eine temporäre URL erzeugen und anschließend eine bestimmte Verzögerung bei der Sichtbarkeit, ein bestimmtes Überschreibverhalten, eine bestimmte Prüfsummenkonvention oder ein bestimmtes Autorisierungsmodell voraussetzen. Der Zieldienst unterstützt möglicherweise einen analogen Vorgang, verwendet aber andere Standardeinstellungen, Header, Fehlertypen, Lebenszyklusmechanismen oder Richtlinienbegriffe. Ein mechanisch konvertierter Aufruf kann kompilieren und dennoch das Verhalten ändern, das nachgelagerte Systeme beobachten.
Bei Warteschlangen entsteht ein ähnliches Problem. Produzent und Konsument sind durch mehr als eine Sendemethode gekoppelt. Sie hängen von Zustellungssemantik, Sichtbarkeits-Timeouts, Aufbewahrung, maximaler Nachrichtengröße, Erwartungen an die Reihenfolge, Dead-Letter-Verhalten, Redrive-Richtlinie, Umgang mit Duplikaten und dem Timing von Wiederholungsversuchen ab. Eine Konvertierung von Azure Queue Storage zu SQS kann gültige AWS-Aufrufe erzeugen, ohne nachzuweisen, dass der Konsument bei erneuter Zustellung weiterhin sicher arbeitet oder ein bestehender Workflow für fehlerhafte Nachrichten noch funktioniert.
Funktionen fügen eine weitere Ebene hinzu. Eine Azure Function kann durch eine HTTP-Anfrage, eine Warteschlange, einen Timer, einen Ereignisstream oder eine Bindung ausgelöst werden, die anbieterspezifische Infrastruktur verbirgt. Lambda verfügt über eigene Ereignisquellen, Aufrufmodi, Parallelitätssteuerungen, Zeitüberschreitungsgrenzen, Bereitstellungspakete, Berechtigungen und ein eigenes Modell für die Beobachtbarkeit. Wenn die ursprüngliche Anwendung von einem langlebigen Prozess, dauerhaftem Speicher im lokalen Dateisystem, einem bestimmten Aufwärmmuster oder einer von einer Bindung erzeugten Anfrageform ausgeht, erfordert die Zielimplementierung über die SDK-Übersetzung hinausgehende Entwurfsarbeit.
Das praktische Ergebnis ist einfach: Ein erfolgreicher Kompilierungslauf ist ein frühes Signal, aber kein Abnahmekriterium für die Migration.
Den Bewertungsbericht richtig lesen
Der Workflow von AWS Transform ist nützlich, weil er Konvertierungsentscheidungen vor die Transformation stellt. Dadurch entsteht ein Zeitpunkt, an dem ein Team das vorgeschlagene Ziel prüfen kann, statt jede Entscheidung erst nach der Codegenerierung zu entdecken.
Behandle diesen Bericht als Bestandsaufnahme der Abhängigkeiten mit zusätzlichen Empfehlungen.
Beginne damit, drei Kategorien zu trennen:
- Direkt unterstützte Aufrufe. Dabei handelt es sich um SDK-Referenzen, von denen das Tool angibt, dass es sie konvertieren kann. Sie kommen für eine automatisierte Transformation infrage, liefern aber nicht automatisch korrekte Ergebnisse.
- Angrenzende Anbieterabhängigkeiten. Dazu gehören Identität, Konfiguration, Netzwerk, Bereitstellung, Protokollierung, Tracing, Geheimnisse, Ereignisbindungen und Infrastrukt定义. Sie können im selben Repository sichtbar sein, werden aber von den aufgeführten Servic Zuordnungen nicht abgedeckt.
- Geschäftsverhalten. Dazu gehören Idempotenz, Reihenfolge, Aufbewahrung, Autorisierungsabsicht, Datenvalidierung, Wiederherstellungsverfahren und für Benutzer sichtbare Fehlerbehandlung. Aus einer Eins-zu-eins-Zuordnung von Diensten lässt es sich nicht zuverlässig ableiten.
Der Bericht sollte außerdem auf die Auswahl der Zieldienste geprüft werden. AWS dokumentiert Standardziele, erlaubt Teams aber, den Plan anzupassen, einschließlich des Verzichts auf einige oder alle Konvertierungen und der Umleitung einer Standardzuordnung. Das ist wichtig, wenn die Zielarchitektur keine wörtliche Ersetzung eines Dienstes darstellt. Ein Team kann sich beispielsweise dafür entscheiden, eine objektorientierte Schnittstelle in der Anwendung beizubehalten und zugleich einen Speicheradapter einzuführen. Oder es kann nach einer Messung von Durchsatz- und Reihenfolgeanforderungen zu dem Schluss kommen, dass eine Warteschlangen-Workload auf einen anderen Integrationsdienst gehört.
Ein nützliches Prüfartefakt ist eine Tabelle mit einer Zeile pro anbieterspezifischer Abhängigkeit:
| Abhängigkeit | Verhalten der Quelle | Vorgeschlagenes Ziel | Nachzuweisendes Verhalten | Verantwortlich |
|---|---|---|---|---|
| Blob-Upload | Überschreiben, Metadaten, Aufbewahrung | S3-Operation | Konsistenz- und Richtlinienverhalten | Speicherteam |
| Warteschlangenempfang | Wiederholungs- und Sichtbarkeitsregeln | SQS-Empfangsablauf | Umgang mit Duplikaten und nicht verarbeitbaren Nachrichten | Serviceteam |
| Function-Trigger | Ereignisform und Zeitüberschreitung | Lambda-Aufruf | Zeitüberschreitungen, Parallelität und Wiederholungen | Plattformteam |
| Identität | Verwaltete Identität und Berechtigungsbereiche | IAM-Rolle und -Richtlinien | Prinzip der geringsten Berechtigung und Rotation | Sicherheitsteam |
Es geht dabei nicht um Bürokratie. Die Tabelle verhindert, dass ein generierter Diff zum maßgeblichen Architekturdokument wird.
Was das Feature gut leistet
Wenn die Anwendung unterstützte Azure-SDKs in konventionellem .NET-Code verwendet, entsteht ein echter Effizienzgewinn. Das Tool kann Dienstreferenzen finden, einen Modernisierungsplan anbieten und bekannte Muster in einem Umfang umschreiben, der andernfalls viel Entwicklerzeit beanspruchen würde. Laut AWS-Dokumentation kann es außerdem explizite Markierungen hinterlassen, wenn eine Konvertierung nicht verfügbar ist, etwa TODO-Kommentare, Stubs oder ein Dokument mit den nächsten Schritten.
Das ist in drei Situationen besonders wertvoll.
Die erste ist eine Portfoliobewertung. Eine Organisation mit vielen .NET-Diensten kann die Analyse nutzen, um festzustellen, wie stark die einzelnen Anwendungen an Azure gebunden sind. Das Ergebnis kann die Reihenfolge verbessern, selbst wenn ein Dienst noch nicht für die Migration bereit ist.
Die zweite ist eine repetitive Übersetzungsphase. Sobald Zielverträge und Infrastrukturmuster vereinbart sind, können automatisierte Änderungen einen großen Teil der mechanischen Arbeit abnehmen. Entwickler können mehr Zeit in das Verhalten investieren und weniger in das Ändern von Namespaces, die Erstellung von Clients und routinemäßige Anfrageformen.
Die dritte ist ein kontrollierter Modernisierungszweig. Ein Team kann die Konvertierung auf eine Kopie der Anwendung anwenden, die Ausgabe mit den bestehenden Abstraktionsgrenzen vergleichen und anhand des resultierenden Diffs den Code identifizieren, der vor Beginn einer Migration isoliert werden sollte.
Die Funktion ist weniger nützlich, wenn das Repository von Infrastructure-as-Code, nur unzureichend dokumentierten Bindings, benutzerdefinierten Azure-Integrationen, komplexen Datenzugriffsmustern oder Anwendungslogik dominiert wird, die das Verhalten des Anbieters als Teil des Geschäftsvertrags behandelt. Solche Fälle können weiterhin von einer Codeanalyse profitieren, doch die Konvertierung darf nicht mit einem vollständigen Migrationsplan verwechselt werden.
Das Identitätsproblem ist größer als ein geänderter Client-Konstruktor
Provider-Migrationen scheitern häufig an der Grenze zwischen Anwendungscode und Autorisierung. Azure-Anwendungen verwenden typischerweise verwaltete Identitäten und Rollenzuweisungen. AWS-Anwendungen nutzen IAM-Rollen und -Richtlinien, wobei Berechtigungen je nach Laufzeitumgebung Ausführungsrollen, Task-Rollen, Instanzprofilen oder anderen Identitäten zugewiesen werden.
Ein konvertierter SDK-Aufruf besitzt von sich aus keine Berechtigung. Die Zielbereitstellung muss eine Identität bereitstellen, die genau die erforderlichen Aktionen für genau die erforderlichen Ressourcen ausführen kann. Das bedeutet, nicht nur „Blob lesen“ auf „Objekt lesen“ abzubilden, sondern auch den Geltungsbereich, die Bedingungen, Ressourcennamen, Verschlüsselungsschlüssel, den Netzwerkpfad und die operative Zuständigkeit für diesen Zugriff zu bestimmen.
Die Migrationsprüfung sollte folgende Fragen beantworten:
- Welche Identität führt jede Funktion, jeden Worker und jeden Deployment-Job aus?
- Welche Ressourcenrichtlinie und welche Identitätsrichtlinie autorisieren den Aufruf gemeinsam?
- Verwendet das Ziel kundenseitig verwaltete Verschlüsselungsschlüssel, und wer darf sie verwenden?
- Kann die Workload den Dienst über den vorgesehenen Netzwerkpfad erreichen?
- Sind die Anmeldedaten kurzlebig und werden sie ohne Änderungen an der Anwendung rotiert?
- Was wird protokolliert, wenn eine Autorisierungsprüfung fehlschlägt?
Hier kann eine reine Codekonvertierung ein irreführendes Gefühl von Vollständigkeit erzeugen. Die Anwendung lässt sich möglicherweise kompilieren, Tests bestehen mit weitreichenden Berechtigungen, und die Produktionsbereitstellung kann dennoch fehlschlagen, weil die tatsächliche Richtliniengrenze nie entworfen wurde. Umgekehrt kann eine schnelle Korrektur, die eine weit gefasste Rolle gewährt, die Migration zwar „funktionieren“ lassen, aber den Schadensradius vergrößern.
Der Sicherheitsabnahmetest sollte daher verweigerte Aktionen, Zugriffsversuche auf andere Ressourcen und eine Bereitstellung aus einer sauberen Umgebung umfassen. Eine Migration ist nicht abgeschlossen, wenn die Anfrage im Erfolgsfall funktioniert. Abgeschlossen ist sie erst, wenn das Identitätsmodell des Ziels verstanden und begrenzt ist.
Datenbewegung und Datensemantik bleiben menschliche Arbeit
AWS Transform verschiebt die Daten hinter Azure Blob Storage, Azure Queue Storage oder Cosmos DB nicht. Das klingt offensichtlich, verändert aber den Projektzeitplan. Codekonvertierung und Datenmigration können nur dann parallel ablaufen, wenn das Team festgelegt hat, wie die beiden Versionen nebeneinander bestehen.
Für Objektdaten benötigt der Plan ein Quellinventar, Schätzungen zu Größe und Objektanzahl, Regeln für Metadaten und Tags, Anforderungen an die Verschlüsselung, Aufbewahrungsregeln, Zugriffsprotokolle und eine Strategie für die Umschaltung. Eine Kopie, die zwar die Bytes bewahrt, aber Metadaten verliert, kann Verbraucher weiterhin beschädigen. Eine Umschaltung, die die URL-Erzeugung oder Autorisierungssemantik verändert, kann Clients beschädigen, selbst wenn jedes Objekt erfolgreich angekommen ist.
Bei Warteschlangen ist das Kopieren von Nachrichten selten ein neutraler Vorgang. Das Team muss entscheiden, ob alte Nachrichten abgearbeitet, erneut abgespielt, verworfen oder übersetzt werden sollen. Ein erneutes Abspielen kann Seiteneffekte doppelt auslösen. Das Abarbeiten kann das Migrationsfenster verlängern. Ein Dual-Write-Design kann zu Abweichungen führen, wenn ein Provider eine Nachricht akzeptiert und der andere sie ablehnt. Welche Wahl sicherer ist, hängt von der Idempotenz der Workload und den geschäftlichen Folgen ab.
Bei Datenbanken ist der Preview-Status von Cosmos DB zu DynamoDB ein Signal für besondere Vorsicht. NoSQL-Systeme unterscheiden sich häufig bei Partitionierung, Indizierung, Konsistenz, Transaktionsumfang, Abfragesprache, Elementgrenzen und dem Verhalten von Änderungsfeeds. Eine konvertierte Datenzugriffsschicht stellt nicht sicher, dass das Zieldatenmodell skalieren oder dieselben Ergebnisse liefern wird. Teams sollten repräsentative Zugriffsmuster modellieren und Datenqualitätsprüfungen durchführen, bevor sie sich zu einer Live-Umschaltung verpflichten.
Der Migrationsplan sollte in jeder Phase die Quelle der Wahrheit benennen. „Die Daten befinden sich in beiden Clouds“ ist keine Konsistenzstrategie.
Tests sollten Verträge vergleichen, nicht nur Ausgaben
Eine herkömmliche Unit-Test-Suite kann überprüfen, ob der konvertierte Code von gemockten Clients erwartete Werte zurückgibt. Das ist notwendig, aber nicht ausreichend, weil Mocks normalerweise die Abstraktion des ursprünglichen Providers beibehalten.
Ein stärkerer Testplan umfasst mehrere Ebenen.
Vertragstests überprüfen die eigenen Erwartungen der Anwendung: Nachrichtenschemata, Objektmetadaten, Autorisierungsentscheidungen, Wiederholungsbehandlung und Fehlerklassifizierung. Diese Tests sollten gegen die Zielservices ausgeführt werden, wenn deren Verhalten relevant ist.
Differenztests führen gleichwertige Workloads gegen die Quell- und Zielimplementierungen aus und vergleichen die Ergebnisse auf Geschäftsebene. Der Vergleich sollte keine identischen Providerfehler oder Request-IDs verlangen. Er sollte prüfen, worauf Benutzer, nachgelagerte Services und Betreiber angewiesen sind.
Fehlertests simulieren Drosselungen, Zeitüberschreitungen, partielle Schreibvorgänge, doppelte Zustellung, abgelaufene Anmeldedaten, nicht verfügbare Abhängigkeiten und fehlerhafte Ereignisse. Ziel ist es, Abweichungen zwischen den Fehlermodellen von Quelle und Ziel sichtbar zu machen.
Betriebstests validieren Logs, Metriken, Traces, Alarme, Dashboards und Runbooks. Ein migrierter Service, der zwar funktioniert, aber nicht diagnostiziert werden kann, ist nicht produktionsbereit.
Sicherheitstests bestätigen Richtlinien nach dem Prinzip der geringsten Rechte und überprüfen, dass die Workload keine Ressourcen außerhalb ihrer vorgesehenen Grenze lesen, schreiben oder aufrufen kann.
Bei serverlosen Workloads sollten Parallelität und Kaltstartverhalten, Zeitüberschreitungsreserven, Wiederholungen der Ereignisquellen und das Rollback von Deployments einbezogen werden. Bei Queues sollte die Sichtbarkeits-Timeout anhand der tatsächlichen Verarbeitungsverteilung gemessen werden, statt einen vertrauten Wert auszuwählen. Für Objektspeicher sollten Metadaten, Verschlüsselung, bedingte Schreibvorgänge und Zugriffs-URLs getestet werden. Bei der Datenbankkonvertierung sollten reale Abfrageformen erneut ausgeführt und Pagination, Konsistenz sowie Fehlerbehandlung verglichen werden.
Eine sicherere Migrationsabfolge
Ein Team, das die neue Funktion bewertet, kann das Risiko verringern, indem es das erste Projekt begrenzt.
Wählen Sie einen Service mit klarer Zuständigkeit, einer begrenzten Anzahl unterstützter Providerabhängigkeiten und einem testbaren Rollback. Beginnen Sie nicht mit dem System, das Identitätsföderation, Event-Fan-out, regulierte Daten und undokumentierte Betriebsabläufe vereint.
Erstellen Sie vor der Konvertierung eine Abhängigkeitskarte der Quelle. Nehmen Sie SDK-Pakete, Umgebungsvariablen, Bindings, Deployment-Manifeste, Geheimnisse, Netzwerkendpunkte, Datenspeicher, Queues, zeitgesteuerte Trigger und Monitoring-Integrationen auf.
Definieren Sie anschließend die Zielverträge. Legen Sie fest, wie die Anwendung Speicher, Messaging, Konfiguration, Identität und Telemetrie abbildet. Wenn providerspezifische Aufrufe über die Geschäftslogik verstreut sind, führen Sie vor der Konvertierung Adapter ein oder stärken Sie vorhandene Adapter. Das erhöht den Vorbereitungsaufwand, macht den resultierenden Diff jedoch leichter prüfbar und künftige Änderungen günstiger.
Führen Sie die Bewertung aus und prüfen Sie jedes vorgeschlagene Mapping. Dokumentieren Sie bewusste Ausnahmen. Behandeln Sie nicht unterstützte Aufrufe als geplante Arbeit und nicht als Aufräumarbeiten, die bis zum Ende warten können.
Erstellen Sie die Zielinfrastruktur getrennt. Verwenden Sie IAM-Rollen mit eng begrenztem Umfang, verschlüsselte Ressourcen, bei Bedarf private Konnektivität, Logging, Alarme, Backups und Deployment-Kontrollen. Verwenden Sie den generierten Anwendungscode nicht als Ersatz für eine Infrastrukturprüfung.
Konvertieren Sie den Code in einem Branch, kompilieren Sie ihn und führen Sie eine statische Analyse durch. Testen Sie anschließend gegen echte Zielservices mit repräsentativen Daten und injizierten Fehlern. Halten Sie die Quellimplementierung verfügbar, bis die fachlichen und betrieblichen Verträge der Migration nachgewiesen sind.
Bevorzugen Sie für den Cutover eine umkehrbare Abfolge: Deployment ohne sichtbaren Traffic, Validierung von Lesevorgängen, Ausführung nicht destruktiver Schreibvorgänge, Vergleich der Telemetrie, Übertragung eines kleinen Anteils des Traffics oder der Workload und Definition des Rollback-Auslösers, bevor der Anteil erhöht wird. Der genaue Mechanismus hängt von der Anwendung ab, doch das Prinzip bleibt gleich: Die Konvertierung sollte die mechanische Phase verkürzen, nicht die Phase der Beweisführung.
Die Governance-Frage für Plattformteams
AWS Transform verändert die Wirtschaftlichkeit der Codeübersetzung. Dadurch können möglicherweise mehr Organisationen Providermigrationen mit kleineren Teams in Angriff nehmen. Das ist nützlich, kann Risiken aber auch früher in den Prozess verlagern. Wenn Code-Transformation günstig wird, werden Architekturentscheidungen und Validierung zu den knappen Ressourcen.
Plattformteams sollten für generierte Migrationen ein standardisiertes Prüftor einrichten. Es sollte Folgendes verlangen:
- ein vollständiges Verzeichnis der konvertierten und nicht konvertierten Anbieterabhängigkeiten;
- eine genehmigte Zielarchitektur und ein Identitätsmodell;
- einen Plan für Datenmigration und Rollback;
- Tests für anbieterspezifische Semantik und Fehlerverhalten;
- Nachweise dafür, dass Observability und Incident Response im Ziel funktionieren;
- eine verantwortliche Person für jedes ungelöste TODO oder jeden Stub;
- eine dokumentierte Entscheidung für jedes geänderte Standard-Mapping.
Das Prüfverfahren sollte angemessen dimensioniert sein. Eine kleine interne Funktion, die nicht sensible Objekte speichert, braucht nicht denselben Prozess wie ein regulierter Transaktionsdienst. Beide benötigen jedoch eine klar benannte verantwortliche Person und eine Möglichkeit nachzuweisen, dass das konvertierte Verhalten akzeptabel ist.
Die zentrale Vorgabe lautet, den generierten Code überprüfbar zu halten. Bewertungsbericht, Modernisierungsplan, Transformations-Diff, Testnachweise und Ausnahmen sollten zusammen mit dem Änderungsdatensatz des Dienstes gespeichert werden. Wird die Konvertierung später erneut ausgeführt, muss das Team erklären können, was sich geändert hat und warum.
Was als Nächstes zu beobachten ist
Die aktuelle Ankündigung umfasst eine begrenzte Auswahl von Azure-zu-AWS-Mappings; die Konvertierung von Cosmos DB zu DynamoDB befindet sich weiterhin in der Preview. Das deutet darauf hin, dass AWS zunächst mit häufigen, klar erkennbaren Übersetzungspunkten beginnt, statt universelle Portabilität zu versprechen.
Teams sollten Änderungen an den unterstützten .NET-Versionen, an weiteren Azure-Diensten, an der Infrastrukturbehandlung und an der Art beobachten, wie das Tool unsichere Konvertierungen meldet. Ebenso wichtig sind die eigenen Testergebnisse. Ein Muster, das in einem kleinen Dienst gleichwertig erscheint, kann sich bei höherem Volumen, unter Wiederholungsversuchen oder mit strengeren Identitätsrichtlinien anders verhalten.
Für den Moment lautet der praktische Rat, AWS Transform dort einzusetzen, wo das Tool am stärksten ist: beim Erfassen von Abhängigkeiten und beim Beschleunigen wiederholbarer Codeänderungen. Architektur, Daten, Identität und die Abnahme für den Produktivbetrieb sollten ausdrücklich von Menschen geprüft werden. Die Funktion kann schnell einen Migrations-Branch erzeugen. Sie kann jedoch nicht dafür sorgen, dass beide Clouds dieselben Verträge teilen.
Das ist die Entscheidung, die Plattformteams vor der Genehmigung des ersten Pull Requests treffen müssen: nicht „Hat der Agent den Code konvertiert?“, sondern „Welche Nachweise zeigen, dass sich dieser Dienst nach dem Wechsel der Anbietergrenze weiterhin korrekt, sicher und zuverlässig betreiben lässt?“
Related articles
AWS fixes read-only bypasses in database MCP servers: what operators need to check
Two AWS security bulletins published on September 9 expose a recurring design problem in database-connected MCP tools: a text filter is not an authorization boundary. Here is who is affected, what the disclosures actually say, and how to contain the risk.
La nouvelle expérience de développement d’AWS réduit les frictions du cloud — et rend indispensable une première revue de gouvernance
AWS simplifie l’arrivée dans le cloud avec des projets préconfigurés, des permissions gérées, la connexion d’agents de programmation et des plafonds de dépenses. Cette rapidité impose toutefois de vérifier immédiatement les identités, la région, les quotas et les accès générés.
Les MicroVM Lambda d’AWS simplifient le déploiement des environnements pour agents IA — et compliquent leur gouvernance par accident
La nouvelle architecture de référence d’AWS fournit aux équipes des environnements d’exécution rapides et isolés pour les tâches d’agents IA. Le changement décisif est opérationnel : identité, sorties réseau, persistance, observabilité et nettoyage doivent désormais être conçus comme un seul système.
Les bulletins de sécurité AWS d’octobre font du développement agentique un sujet de réponse aux incidents
Les bulletins AWS révèlent des failles dans Loom for AWS, un serveur MCP de sécurité, SageMaker Unified Studio et Kiro. Au-delà des correctifs, les équipes doivent inventorier les agents, leurs identités, leurs accès réseau, leurs chemins d’écriture et l’activité cloud récente.
Comments
Sign in to comment.
No comments yet.