AWS Transform convertit le code .NET Azure, mais la migration nécessite toujours une revue d’architecture
AWS Transform traduit désormais certains appels au SDK Azure vers leurs équivalents AWS pour les applications .NET modernes. L’enjeu n’est pas la compilation du code généré, mais la continuité de l’identité, des données, de la gestion des défaillances et de l’exploitation après le changement de cloud.
AWS a rendu généralement disponible une fonctionnalité de conversion de code dans AWS Transform, qui réécrit certains appels aux SDK Azure utilisés par des applications .NET modernes pour les remplacer par leurs équivalents AWS. L’annonce, publiée le 16 octobre, couvre le passage d’Azure Functions à AWS Lambda, d’Azure Blob Storage à Amazon S3 et d’Azure Queue Storage à Amazon SQS. La conversion d’Azure Cosmos DB vers Amazon DynamoDB est proposée en préversion.
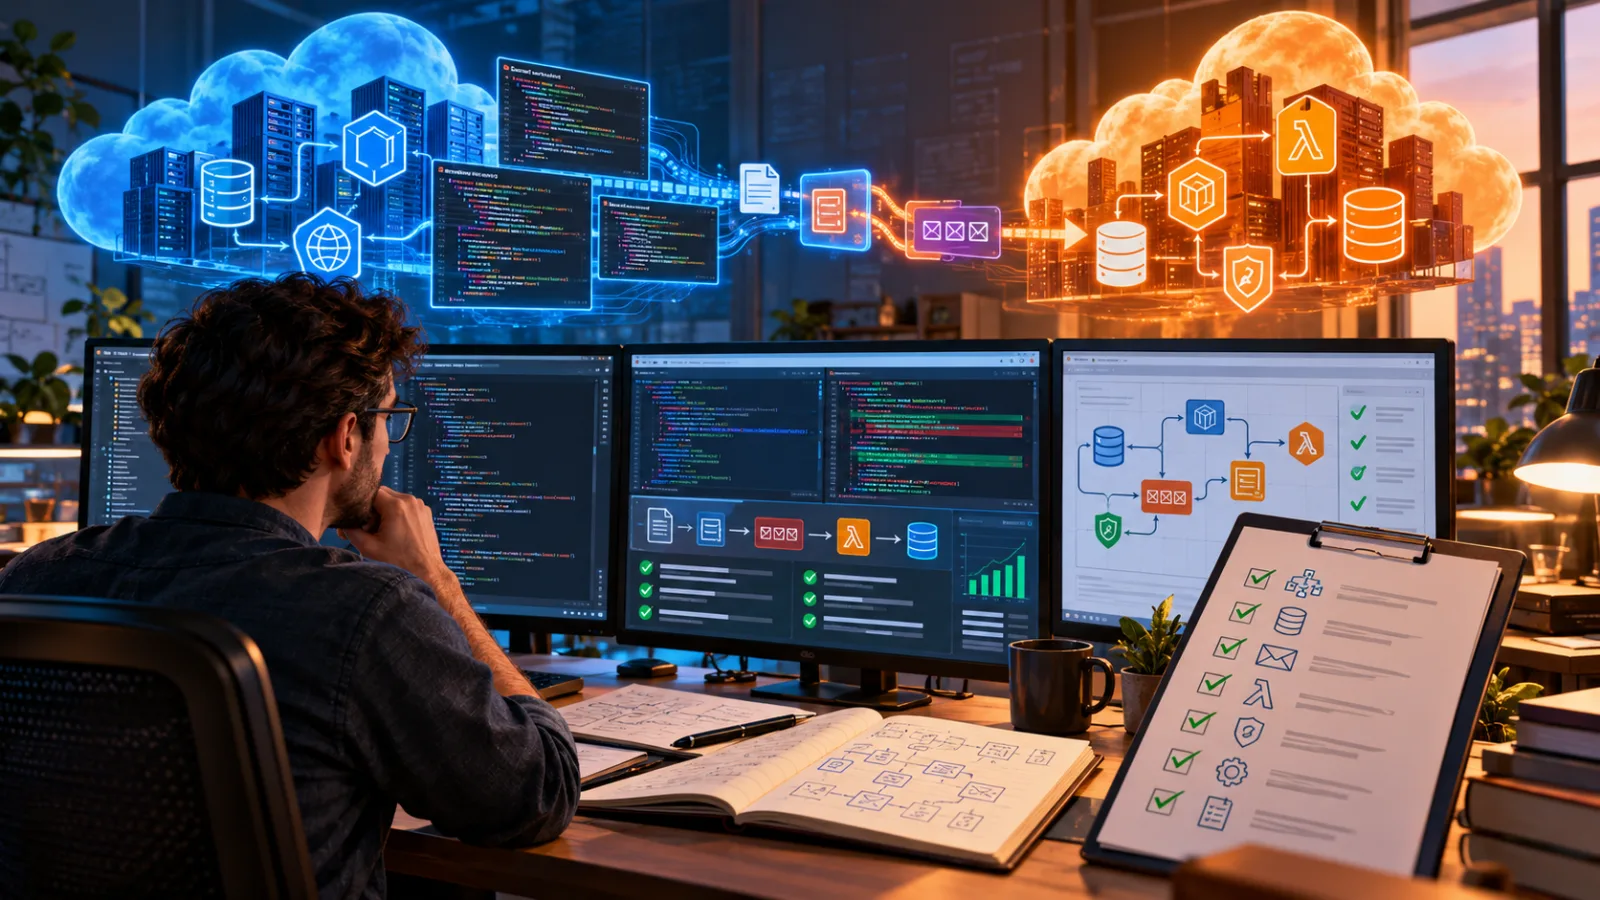
L’intérêt immédiat est facile à comprendre : une équipe peut soumettre une application qui fonctionne déjà sur Azure, laisser un agent identifier les dépendances cloud prises en charge et recevoir une base de code transformée, au lieu de repartir de zéro pour réécrire chaque service. Le point opérationnel le plus important est qu’il s’agit d’une conversion du code source, et non d’une migration cloud complète. La fonctionnalité ne recrée pas un réseau Azure, ne déplace pas les données, ne reproduit pas les politiques d’identité et ne prouve pas que l’application obtenue conservera les mêmes comportements en matière de défaillances et de cohérence.
Cette distinction doit guider l’évaluation de la fonctionnalité par les équipes chargées de la plateforme et de l’ingénierie. Considérez AWS Transform comme un accélérateur pour un chantier de modernisation délimité, et non comme une autorisation de changer de fournisseur en acceptant une pull request générée.
Ce qu’AWS a annoncé
L’agent de modernisation .NET d’AWS Transform peut examiner le code source soumis, identifier l’utilisation des SDK Azure et intégrer les choix de conversion dans un rapport d’évaluation et un plan de modernisation. L’équipe peut accepter ces choix, les modifier ou se désengager avant l’exécution de la transformation.
Les correspondances généralement disponibles restent volontairement limitées :
- Azure Functions peut être converti en fonctions AWS Lambda.
- Les appels au SDK Azure Blob Storage peuvent être convertis en appels au SDK Amazon S3.
- Les appels à Azure Queue Storage peuvent être convertis en appels à Amazon SQS.
- La conversion d’Azure Cosmos DB vers Amazon DynamoDB est présentée comme une fonctionnalité en préversion.
AWS indique que la fonctionnalité est disponible dans huit régions : États-Unis Est (Virginie du Nord), Asie-Pacifique (Mumbai, Tokyo et Séoul), Asie-Pacifique (Sydney), Canada (Centre), ainsi qu’Europe (Francfort et Londres). La documentation précise également une limite importante : la fonctionnalité convertit le code applicatif, mais ne prend pas en charge la migration de l’infrastructure cloud.
Cette limite n’est pas une note de bas de page. Dans un service réel, le SDK ne représente qu’une seule couche de la dépendance au fournisseur. Une Azure Function peut reposer sur un plan d’hébergement, une identité managée, des paramètres d’application, des points de terminaison privés, des emplacements de déploiement, des liaisons d’événements, des comptes de stockage, des références à Key Vault, des règles de supervision et des restrictions réseau. Remplacer un espace de noms et un appel de méthode laisse aux équipes le soin de découvrir puis de reconstruire toutes ces hypothèses environnantes.
La fonctionnalité AWS traite donc une partie bien identifiable du coût de migration : la traduction du code applicatif propre au fournisseur. Elle ne dispense pas de définir l’architecture cible.
Pourquoi un « service équivalent » n’implique pas un comportement équivalent
Les noms des services cloud favorisent une fausse symétrie. Blob Storage et S3 sont tous deux des stockages d’objets. Azure Queue Storage et SQS sont tous deux des services de file d’attente. Azure Functions et Lambda sont toutes deux des plateformes de calcul serverless. Au niveau de l’API, ces comparaisons sont utiles. À l’exécution, elles restent incomplètes.
La première question d’une équipe de migration n’est pas de savoir si une méthode peut être traduite. Il faut déterminer si le contrat de l’application survit à cette traduction.
Le stockage d’objets en est un bon exemple. Un chemin de code peut téléverser un objet, définir ses métadonnées, générer une URL temporaire, puis supposer un délai de visibilité, un comportement d’écrasement, une convention de somme de contrôle ou un modèle d’autorisation précis. Le service cible peut prendre en charge une opération analogue tout en appliquant d’autres valeurs par défaut, en-têtes, types d’erreur, mécanismes de cycle de vie ou vocabulaire de politiques. Un appel converti mécaniquement peut compiler tout en modifiant le comportement observé par les systèmes en aval.
Les files d’attente posent un problème similaire. Le producteur et le consommateur sont liés par davantage qu’une méthode d’envoi. Ils dépendent de la sémantique de livraison, des délais de visibilité, de la conservation, de la taille maximale des messages, des attentes en matière d’ordre, de la gestion des files d’attente de messages non distribuables, de la politique de réinjection, du traitement des doublons et du calendrier des nouvelles tentatives. Une conversion d’Azure Queue Storage vers SQS peut produire des appels AWS valides sans démontrer que le consommateur reste sûr en cas de nouvelle livraison ni qu’un flux de traitement des messages défectueux continue de fonctionner.
Les fonctions ajoutent une difficulté supplémentaire. Une fonction Azure peut être déclenchée par une requête HTTP, une file d’attente, un minuteur, un flux d’événements ou une liaison qui masque les éléments propres au fournisseur. Lambda possède ses propres sources d’événements, modes d’invocation, contrôles de concurrence, limites de délai d’exécution, mécanismes de déploiement, autorisations et modèle d’observabilité. Si l’application d’origine suppose un processus de longue durée, la persistance sur le système de fichiers local, un schéma particulier de préchauffage ou une forme de requête générée par une liaison, l’implémentation cible demande un travail de conception qui dépasse la traduction du SDK.
La conclusion pratique est simple : la réussite de la compilation est un premier indicateur, pas un critère d’acceptation de la migration.
Bien interpréter le rapport d’évaluation
Le flux de travail d’AWS Transform est utile parce qu’il place les décisions de conversion avant la transformation. L’équipe dispose ainsi d’un point de contrôle pour examiner la cible proposée, au lieu de découvrir chaque choix après la génération du code.
Utilisez ce rapport comme un inventaire des dépendances, assorti de recommandations.
Commencez par distinguer trois catégories :
- Appels directement pris en charge. Il s’agit des références aux SDK que l’outil indique pouvoir convertir. Elles peuvent faire l’objet d’une transformation automatisée, mais les résultats produits ne sont pas automatiquement corrects.
- Dépendances adjacentes au fournisseur. Elles comprennent l’identité, la configuration, le réseau, le déploiement, la journalisation, la traçabilité, les secrets, les liaisons d’événements et les définitions d’infrastructure. Elles peuvent être visibles dans le même dépôt, mais ne sont pas couvertes par les correspondances de services répertoriées.
- Comportement métier. Cela inclut l’idempotence, l’ordre de traitement, la rétention, l’intention d’autorisation, la validation des données, les procédures de reprise et la gestion des erreurs visibles par l’utilisateur. Il est impossible de le déduire de manière fiable d’une correspondance de services un à un.
Le rapport doit également être examiné sous l’angle des choix de services cibles. AWS documente des cibles par défaut, mais permet aux équipes de personnaliser le plan, notamment en excluant certaines conversions ou la totalité d’entre elles, ou en redirigeant une correspondance par défaut. C’est important lorsque l’architecture cible ne consiste pas en un simple remplacement de service. Par exemple, une équipe peut choisir de conserver une interface orientée objet dans l’application tout en introduisant un adaptateur de stockage, ou décider qu’une charge de travail de file d’attente relève d’un autre service d’intégration après avoir mesuré les exigences de débit et d’ordre de traitement.
Un artefact de revue utile est un tableau comportant une ligne par dépendance propre au fournisseur :
| Dépendance | Comportement source | Cible proposée | Comportement à démontrer | Responsable |
|---|---|---|---|---|
| Téléversement d’objets blob | écrasement, métadonnées, rétention | opération S3 | cohérence et comportement des politiques | équipe stockage |
| Réception dans une file | règles de nouvelle tentative et de visibilité | flux de réception SQS | gestion des doublons et des messages irrécupérables | équipe service |
| Déclencheur de fonction | forme de l’événement et délai d’exécution | invocation Lambda | délai d’exécution, concurrence et nouvelles tentatives | équipe plateforme |
| Identité | identité managée et étendues | rôle et politiques IAM | privilèges minimaux et rotation | équipe sécurité |
L’objectif n’est pas d’ajouter de la bureaucratie. Il s’agit d’empêcher qu’un diff généré ne devienne, de fait, le document d’architecture.
Ce que la fonctionnalité fait bien
Le gain d’efficacité est réel lorsque l’application utilise les SDK Azure pris en charge dans un code .NET conventionnel. L’outil peut trouver les références aux services, proposer un plan de modernisation et réécrire des schémas connus à une échelle qui mobiliserait autrement beaucoup de temps de développement. Selon la documentation AWS, il peut aussi laisser des marqueurs explicites lorsqu’une conversion n’est pas disponible, notamment des commentaires TODO, des stubs ou un document présentant les prochaines étapes.
Cela est utile dans trois situations.
La première est l’évaluation d’un portefeuille. Une organisation disposant de nombreux services .NET peut utiliser l’analyse pour déterminer dans quelle mesure chaque application dépend d’Azure. Le résultat peut améliorer l’ordre des migrations, même lorsqu’un service n’est pas encore prêt à migrer.
La deuxième est une phase de traduction répétitive. Une fois les contrats cibles et les modèles d’infrastructure convenus, les modifications automatisées peuvent éliminer une grande part du travail mécanique. Les ingénieurs peuvent consacrer davantage de temps au comportement et moins à la modification des espaces de noms, à la construction des clients et aux formes de requête courantes.
La troisième est une branche de modernisation contrôlée. Une équipe peut exécuter la conversion sur une copie de l’application, comparer le résultat à ses frontières d’abstraction existantes et utiliser le diff obtenu pour repérer le code qui devrait être isolé avant le début de la migration.
La fonctionnalité est moins utile lorsque le dépôt est dominé par l’infrastructure as code, des liaisons peu documentées, des intégrations Azure personnalisées, des schémas d’accès aux données complexes ou une logique applicative qui considère le comportement du fournisseur comme faisant partie du contrat métier. Ces cas peuvent tout de même tirer parti d’une analyse du code, mais la conversion ne doit pas être confondue avec un plan de migration complet.
Le problème de l’identité dépasse largement le changement de constructeur client
Les migrations entre fournisseurs échouent souvent à la frontière entre le code applicatif et l’autorisation. Les applications Azure utilisent couramment des identités managées et des attributions de rôles. Les applications AWS utilisent des rôles et des politiques IAM, les autorisations étant associées à des rôles d’exécution, des rôles de tâche, des profils d’instance ou d’autres identités selon l’environnement d’exécution.
Un appel SDK converti ne possède aucune autorité par lui-même. Le déploiement cible doit fournir une identité capable d’exécuter exactement les actions requises sur exactement les ressources concernées. Il faut donc faire correspondre non seulement « peut lire un blob » à « peut lire un objet », mais aussi la portée, les conditions, les noms de ressources, les clés de chiffrement, le chemin réseau et la responsabilité opérationnelle liés à cet accès.
La revue de migration doit répondre aux questions suivantes :
- Quelle identité exécute chaque fonction, worker et tâche de déploiement ?
- Quelles politique de ressource et politique d’identité autorisent ensemble l’appel ?
- La cible utilise-t-elle des clés de chiffrement gérées par le client, et qui peut les utiliser ?
- La charge de travail peut-elle atteindre le service par le chemin réseau prévu ?
- Les identifiants ont-ils une durée de vie limitée et sont-ils renouvelés sans modifier l’application ?
- Que consigne-t-on lorsqu’un contrôle d’autorisation échoue ?
C’est ici qu’une conversion limitée au code peut donner une impression trompeuse d’achèvement. L’application peut compiler, les tests peuvent réussir avec des autorisations trop larges et le déploiement en production peut tout de même échouer, parce que la véritable frontière de politique n’a jamais été conçue. À l’inverse, une correction rapide qui accorde un rôle étendu peut faire « fonctionner » la migration tout en augmentant le rayon d’impact.
Le test d’acceptation de sécurité doit donc inclure des actions refusées, des tentatives d’accès entre ressources et un déploiement depuis un environnement vierge. Une migration n’est pas terminée lorsque la requête nominale réussit ; elle l’est lorsque le modèle d’identité cible est compris et correctement limité.
Le déplacement des données et leur sémantique restent un travail humain
AWS Transform ne déplace pas les données derrière Azure Blob Storage, Azure Queue Storage ou Cosmos DB. Cela semble évident, mais cette réalité modifie le calendrier du projet. La conversion du code et la migration des données ne peuvent progresser en parallèle qu’après que l’équipe a défini la manière dont les deux versions vont coexister.
Pour les données objet, le plan doit prévoir un inventaire de la source, des estimations de taille et de nombre d’objets, la gestion des métadonnées et des balises, les exigences de chiffrement, les règles de conservation, les journaux d’accès et une stratégie de bascule. Une copie qui préserve les octets mais perd les métadonnées peut tout de même casser les consommateurs. Une bascule qui modifie la génération des URL ou la sémantique d’autorisation peut casser les clients, même lorsque chaque objet est arrivé correctement.
Pour les files d’attente, copier les messages est rarement une opération neutre. L’équipe doit décider si les anciens messages doivent être traités jusqu’à épuisement, rejoués, supprimés ou traduits. Un rejeu peut déclencher deux fois les effets de bord. Le traitement jusqu’à épuisement peut prolonger la fenêtre de migration. Une double écriture peut créer une divergence si un fournisseur accepte un message et que l’autre le refuse. Le choix le plus sûr dépend de l’idempotence de la charge de travail et des conséquences métier.
Pour les bases de données, le statut de préversion de Cosmos DB vers DynamoDB est un signal appelant une prudence particulière. Les systèmes NoSQL diffèrent souvent par leur partitionnement, leur indexation, leur cohérence, la portée de leurs transactions, leur langage de requête, les limites applicables aux éléments et le comportement de leur flux de modifications. Une couche d’accès aux données convertie ne prouve pas que le modèle de données cible passera à l’échelle ni qu’il renverra les mêmes résultats. Les équipes doivent modéliser des schémas d’accès représentatifs et exécuter des contrôles de qualité des données avant de s’engager dans une bascule en production.
Le plan de migration doit désigner la source de vérité à chaque étape. « Les données sont dans les deux clouds » n’est pas une stratégie de cohérence.
Les tests doivent comparer les contrats, pas seulement les résultats
Une suite classique de tests unitaires peut vérifier que le code converti renvoie les valeurs attendues à partir de clients simulés. C’est nécessaire, mais insuffisant, car les simulations préservent généralement l’abstraction conçue par le fournisseur d’origine.
Un plan de test plus solide comporte plusieurs niveaux.
Les tests de contrat vérifient les attentes propres à l’application : schémas des messages, métadonnées des objets, décisions d’autorisation, gestion des nouvelles tentatives et classification des erreurs. Ces tests doivent s’exécuter sur les services cibles lorsque leur comportement est déterminant.
Les tests différentiels exécutent des charges de travail équivalentes sur les implémentations source et cible, puis comparent les résultats au niveau métier. La comparaison ne doit pas exiger des erreurs de fournisseur ou des identifiants de requête identiques. Elle doit vérifier ce dont dépendent les utilisateurs, les services en aval et les opérateurs.
Les tests de défaillance injectent de la limitation de débit, des dépassements de délai, des écritures partielles, des livraisons en double, des identifiants expirés, des dépendances indisponibles et des événements mal formés. L’objectif est de révéler les divergences entre les modèles de défaillance source et cible.
Les tests opérationnels valident les journaux, les métriques, les traces, les alertes, les tableaux de bord et les procédures d’exploitation. Un service migré qui fonctionne mais ne peut pas être diagnostiqué n’est pas prêt pour la production.
Les tests de sécurité confirment les politiques du moindre privilège et vérifient que la charge de travail ne peut pas lire, écrire ou invoquer des ressources en dehors de son périmètre prévu.
Pour les charges de travail serverless, incluez le comportement lié à la concurrence et aux démarrages à froid, les marges de délai d’expiration, les nouvelles tentatives des sources d’événements et l’annulation des déploiements. Pour les files d’attente, mesurez le délai de visibilité par rapport à la distribution réelle des temps de traitement au lieu de choisir une valeur familière. Pour le stockage d’objets, testez les métadonnées, le chiffrement, les écritures conditionnelles et les URL d’accès. Pour la conversion de bases de données, rejouez les formes de requêtes réelles et comparez la pagination, la cohérence et la gestion des défaillances.
Une séquence de migration plus sûre
Une équipe qui évalue cette nouvelle fonctionnalité peut réduire les risques en limitant la portée du premier projet.
Choisissez un service dont le responsable est clairement identifié, qui dépend d’un nombre limité de fournisseurs pris en charge et qui dispose d’un retour arrière testable. Évitez de commencer par le système qui combine fédération d’identités, diffusion d’événements, données réglementées et procédures opérationnelles non documentées.
Avant d’exécuter la conversion, créez une cartographie des dépendances sources. Incluez les packages SDK, les variables d’environnement, les liaisons, les manifestes de déploiement, les secrets, les points de terminaison réseau, les magasins de données, les files d’attente, les déclencheurs planifiés et les intégrations de supervision.
Définissez ensuite les contrats cibles. Décidez comment l’application représentera le stockage, la messagerie, la configuration, l’identité et la télémétrie. Si les appels spécifiques au fournisseur sont dispersés dans la logique métier, introduisez ou renforcez les adaptateurs avant la conversion. Cela augmente le travail de préparation, mais facilite la revue du diff obtenu et réduit le coût des changements ultérieurs.
Exécutez l’évaluation et examinez chaque mappage proposé. Consignez les exclusions intentionnelles. Considérez les appels non pris en charge comme des travaux planifiés, et non comme du nettoyage à remettre à la fin.
Créez séparément l’infrastructure cible. Utilisez des rôles IAM aux privilèges strictement nécessaires, des ressources chiffrées, une connectivité privée lorsque cela est requis, la journalisation, des alertes, des sauvegardes et des contrôles de déploiement. Le code applicatif généré ne doit pas servir de substitut à une revue de l’infrastructure.
Convertissez le code dans une branche, compilez-le et exécutez une analyse statique. Testez-le ensuite avec les services cibles réels, des données représentatives et une injection de défaillances. Conservez l’implémentation source jusqu’à ce que les contrats métier et opérationnels de la migration soient démontrés.
Pour la mise en production, privilégiez une séquence réversible : déployez sans exposer le service, validez les lectures, testez des écritures non destructives, comparez la télémétrie, transférez une faible part du trafic ou de la charge de travail, puis définissez le seuil de retour arrière avant d’augmenter cette part. Le mécanisme exact variera selon l’application, mais le principe reste constant : la conversion doit raccourcir la phase mécanique sans raccourcir la phase de collecte des preuves.
La question de la gouvernance pour les équipes plateforme
AWS Transform modifie l’économie de la traduction de code, ce qui signifie que davantage d’organisations pourront tenter des migrations entre fournisseurs avec des équipes plus réduites. C’est utile, mais cela peut aussi faire remonter les risques plus tôt dans le processus. Lorsque la transformation du code devient peu coûteuse, les décisions d’architecture et la validation deviennent les ressources rares.
Les équipes plateforme devraient instaurer une étape de revue standard pour les migrations générées. Elle devrait exiger :
- un inventaire complet des dépendances du fournisseur converties et non converties ;
- une architecture cible et un modèle d’identité approuvés ;
- un plan de migration des données et de retour arrière ;
- des tests portant sur les sémantiques propres au fournisseur et le comportement en cas d’échec ;
- des preuves que l’observabilité et la réponse aux incidents fonctionnent dans l’environnement cible ;
- un responsable identifié pour chaque TODO ou stub non résolu ;
- une décision documentée pour tout mappage par défaut ayant été modifié.
Le niveau d’exigence doit rester proportionné. Une petite fonction interne qui stocke des objets non sensibles n’a pas besoin du même processus qu’un service de transactions soumis à une réglementation. Mais les deux doivent avoir un responsable désigné et un moyen de démontrer que le comportement converti est acceptable.
La règle essentielle consiste à garder le code généré vérifiable. Conservez le rapport d’évaluation, le plan de modernisation, le diff de transformation, les éléments de preuve issus des tests et les exceptions avec l’enregistrement des changements du service. Si la conversion est relancée plus tard, l’équipe doit pouvoir expliquer ce qui a changé et pourquoi.
Ce qu’il faudra surveiller
L’annonce actuelle couvre un ensemble ciblé de mappages d’Azure vers AWS et maintient la conversion de Cosmos DB vers DynamoDB en aperçu. Cela laisse penser qu’AWS commence par des points de traduction courants et facilement identifiables, sans prétendre assurer une portabilité universelle.
Les équipes doivent surveiller l’évolution des versions de .NET prises en charge, l’ajout de services Azure, la gestion de l’infrastructure et la manière dont l’outil signale les conversions incertaines. Elles doivent aussi suivre leurs propres résultats de test. Un comportement qui paraît équivalent dans un petit service peut différer à plus grande échelle, lors de nouvelles tentatives ou avec des politiques d’identité plus strictes.
Pour l’instant, le conseil pratique est d’utiliser AWS Transform là où il est le plus efficace : inventorier les dépendances et accélérer les modifications de code répétitives. L’architecture, les données, l’identité et l’acceptation en production doivent rester soumises à une revue humaine explicite. La fonctionnalité peut faire apparaître rapidement une branche de migration. Elle ne peut pas faire en sorte que les deux clouds partagent les mêmes contrats.
C’est la décision que les équipes responsables de la plateforme doivent prendre avant d’approuver la première pull request : non pas « l’agent a-t-il converti le code ? », mais « quelles preuves montrent que ce service continue de fonctionner correctement, de manière sécurisée et exploitable après le déplacement de la frontière entre fournisseurs ? »
Related articles
La nouvelle expérience de développement d’AWS réduit les frictions du cloud — et rend indispensable une première revue de gouvernance
AWS simplifie l’arrivée dans le cloud avec des projets préconfigurés, des permissions gérées, la connexion d’agents de programmation et des plafonds de dépenses. Cette rapidité impose toutefois de vérifier immédiatement les identités, la région, les quotas et les accès générés.
Les MicroVM Lambda d’AWS simplifient le déploiement des environnements pour agents IA — et compliquent leur gouvernance par accident
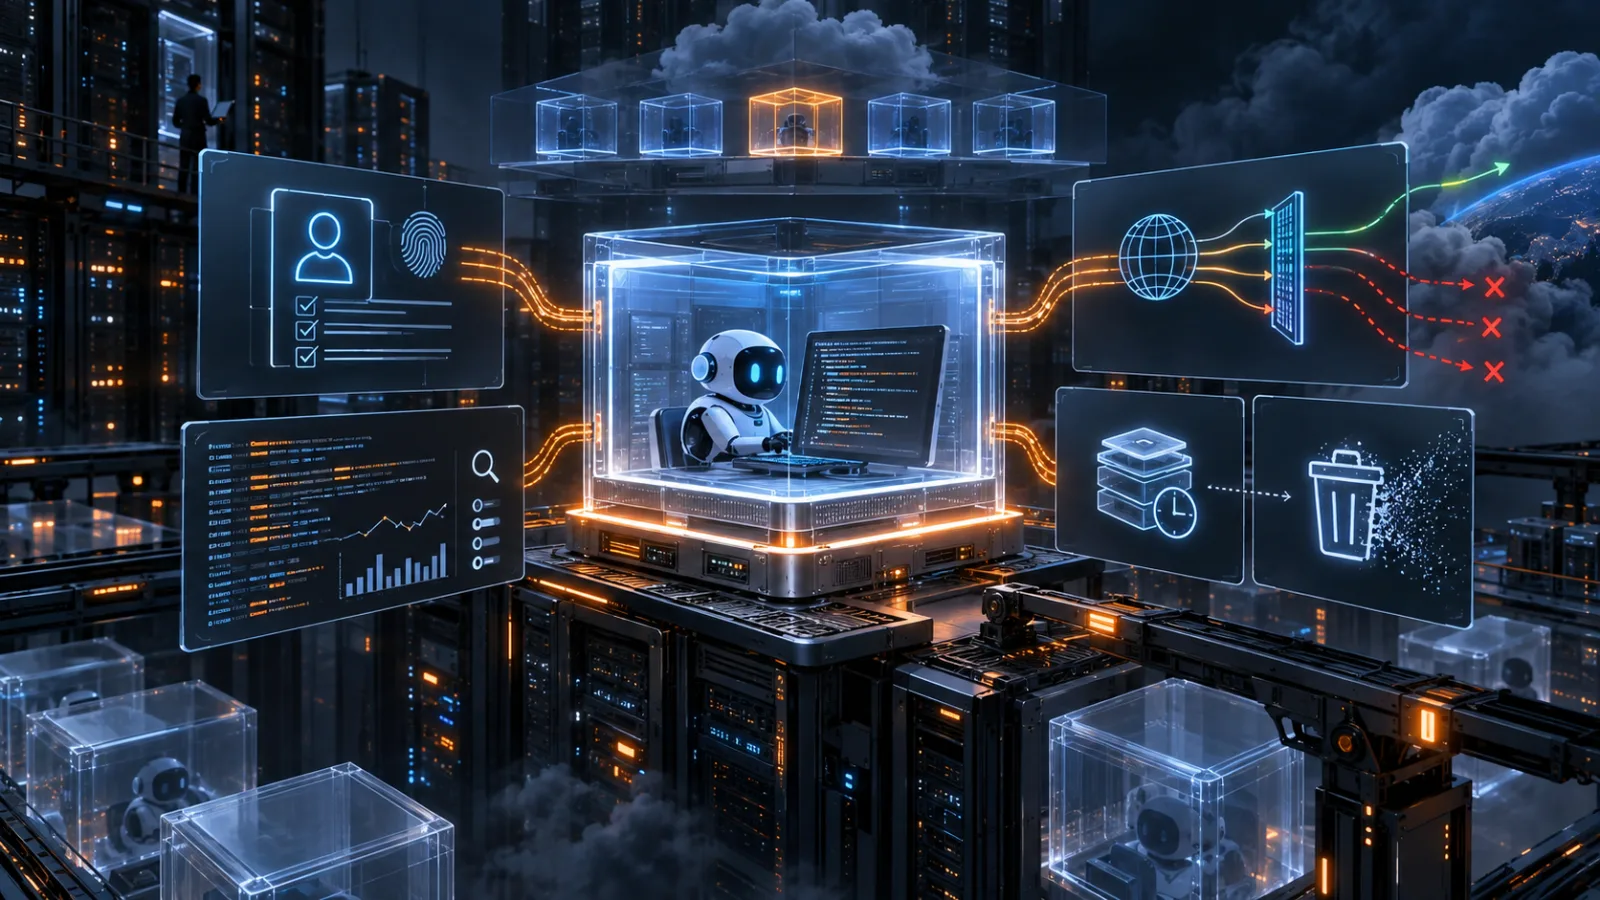
La nouvelle architecture de référence d’AWS fournit aux équipes des environnements d’exécution rapides et isolés pour les tâches d’agents IA. Le changement décisif est opérationnel : identité, sorties réseau, persistance, observabilité et nettoyage doivent désormais être conçus comme un seul système.
Les bulletins de sécurité AWS d’octobre font du développement agentique un sujet de réponse aux incidents
Les bulletins AWS révèlent des failles dans Loom for AWS, un serveur MCP de sécurité, SageMaker Unified Studio et Kiro. Au-delà des correctifs, les équipes doivent inventorier les agents, leurs identités, leurs accès réseau, leurs chemins d’écriture et l’activité cloud récente.
Les agents de programmation IA ne sont plus de l’autocomplétion
GhostApproval et Friendly Fire montrent pourquoi ces outils doivent être traités comme des runtimes privilégiés, pas comme de simples assistants d’éditeur.
Comments
Sign in to comment.
No comments yet.