AWS Transform convierte código .NET de Azure, pero la migración aún necesita una revisión de arquitectura
AWS Transform ya puede traducir determinadas llamadas del SDK de Azure a equivalentes de AWS para aplicaciones .NET modernas. La cuestión es si la identidad, los datos, los fallos y las operaciones siguen funcionando al mover la frontera de la nube.
AWS ha incorporado la disponibilidad general de una función de conversión de código en AWS Transform que reescribe determinadas llamadas del SDK de Azure en aplicaciones .NET modernas y las convierte en sus equivalentes de AWS. El anuncio, publicado el 16 de octubre, abarca Azure Functions a AWS Lambda, Azure Blob Storage a Amazon S3 y Azure Queue Storage a Amazon SQS. La conversión de Azure Cosmos DB a Amazon DynamoDB está disponible como función en versión preliminar.
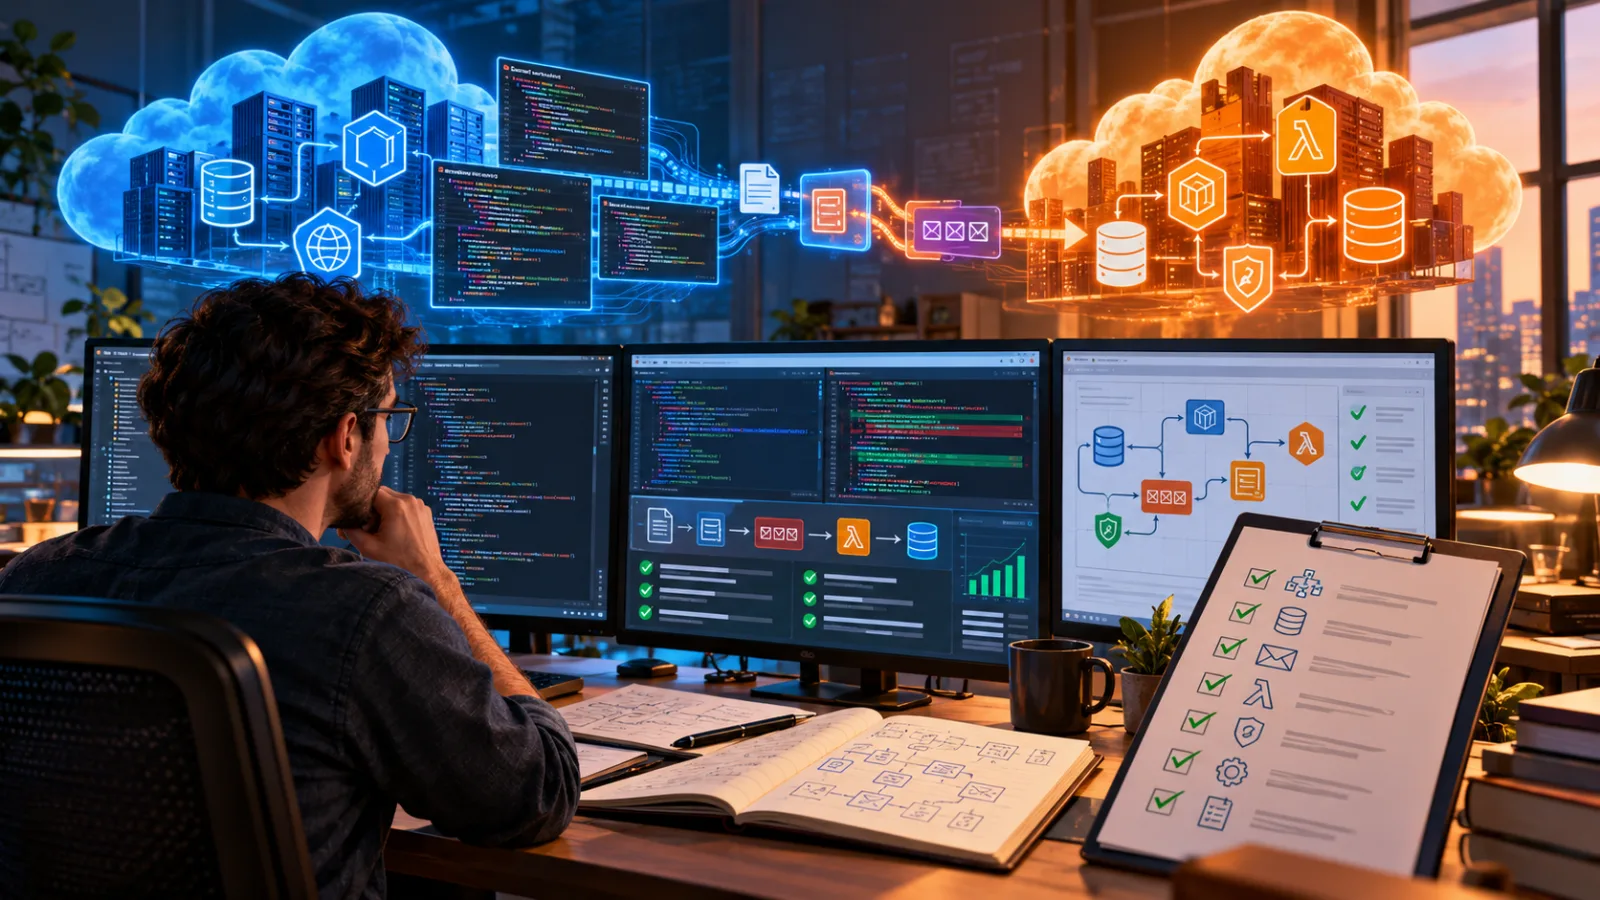
El atractivo inmediato es fácil de entender: un equipo puede enviar una aplicación que ya funciona en Azure, dejar que un agente identifique las dependencias de nube compatibles y recibir una base de código transformada, en lugar de empezar una reescritura servicio por servicio. El aspecto operativo más importante es que se trata de una conversión del código fuente, no de una migración completa a la nube. No recrea una red de Azure, no mueve datos, no reproduce políticas de identidad ni demuestra que la aplicación resultante conserve el mismo comportamiento ante fallos y en materia de consistencia.
Esa distinción debería determinar cómo evalúan la función los equipos de plataforma e ingeniería. Consideren AWS Transform un acelerador para una línea de trabajo de modernización con límites definidos, no una autorización para cambiar de proveedor aceptando una solicitud de incorporación de cambios generada automáticamente.
Qué anunció AWS
El agente de modernización de .NET de AWS Transform puede inspeccionar el código fuente enviado, identificar el uso del SDK de Azure e incluir las opciones de conversión en un informe de evaluación y un plan de modernización. El equipo puede aceptar esas opciones, modificarlas o excluirse antes de ejecutar la transformación.
Las correspondencias disponibles de forma general son deliberadamente limitadas:
- Azure Functions se puede convertir en funciones de AWS Lambda.
- Las llamadas al SDK de Azure Blob Storage se pueden convertir en llamadas al SDK de Amazon S3.
- Las llamadas a Azure Queue Storage se pueden convertir en llamadas a Amazon SQS.
- La conversión de Azure Cosmos DB a Amazon DynamoDB figura como función en versión preliminar.
AWS afirma que la función está disponible en ocho regiones: Este de EE. UU. (Norte de Virginia), Asia-Pacífico (Mumbai, Tokio y Seúl), Asia-Pacífico (Sídney), Canadá (Central) y Europa (Fráncfort y Londres). La documentación también deja clara una limitación importante: la función convierte el código de la aplicación y no gestiona la migración de la infraestructura de nube.
Esa limitación no es una nota al pie. En un servicio real, el SDK es solo una capa de la dependencia del proveedor. Una función de Azure puede depender de un plan de hospedaje, una identidad administrada, configuraciones de la aplicación, puntos de conexión privados, ranuras de implementación, vinculaciones de eventos, cuentas de almacenamiento, referencias a Key Vault, reglas de supervisión y restricciones de red. Sustituir un espacio de nombres y una llamada a un método deja que las personas descubran y reconstruyan esas suposiciones circundantes.
Por tanto, la función de AWS aborda una parte reconocible del coste de migración: traducir el código de aplicación específico del proveedor. No elimina la necesidad de definir la arquitectura de destino.
Por qué «servicio equivalente» no significa «comportamiento equivalente»
Los nombres de los servicios en la nube fomentan una falsa simetría. Blob Storage y S3 son almacenes de objetos. Azure Queue Storage y SQS son servicios de colas. Azure Functions y Lambda son plataformas de computación sin servidor. A nivel de API, esas comparaciones son útiles. En tiempo de ejecución, son incompletas.
La primera pregunta para un equipo de migración no es si se puede traducir un método. Es si el contrato de la aplicación sobrevive a la traducción.
El almacenamiento de objetos es un buen ejemplo. Una ruta de código puede cargar un objeto, establecer metadatos, generar una URL temporal y asumir después un determinado retraso de visibilidad, comportamiento de sobrescritura, convención de suma de comprobación o modelo de autorización. El servicio de destino puede admitir una operación análoga y, aun así, utilizar valores predeterminados, encabezados, tipos de error, mecanismos de ciclo de vida o vocabulario de políticas diferentes. Una llamada convertida mecánicamente puede compilar y cambiar, sin embargo, el comportamiento que observan los sistemas posteriores.
Las colas plantean un problema similar. Un productor y un consumidor están acoplados por algo más que un método de envío. Dependen de la semántica de entrega, los tiempos de espera de visibilidad, la retención, el tamaño máximo de los mensajes, las expectativas de orden, el comportamiento de la cola de mensajes fallidos, la política de reenvío, la gestión de duplicados y el tiempo entre reintentos. Una conversión de Azure Queue Storage a SQS puede generar llamadas válidas a AWS sin demostrar que el consumidor siga siendo seguro ante una redelivery o que un flujo existente para mensajes no procesables continúe funcionando.
Las funciones añaden otra capa. Una Azure Function puede activarse mediante una solicitud HTTP, una cola, un temporizador, un flujo de eventos o un binding que oculta la lógica específica del proveedor. Lambda tiene sus propias fuentes de eventos, modos de invocación, controles de concurrencia, límites de tiempo de espera, empaquetado de despliegue, permisos y modelo de observabilidad. Si la aplicación original presupone un proceso de larga duración, persistencia en el sistema de archivos local, un patrón concreto de calentamiento o una forma de solicitud generada por un binding, la implementación de destino necesita trabajo de diseño que va más allá de traducir el SDK.
El resultado práctico es sencillo: que el código compile es una señal inicial, no un criterio de aceptación de la migración.
Cómo interpretar correctamente el informe de evaluación
El flujo de trabajo de AWS Transform resulta útil porque sitúa las decisiones de conversión antes de la transformación. Así se crea un momento en el que el equipo puede revisar el destino propuesto en lugar de descubrir cada decisión después de generar el código.
Usa ese informe como un inventario de dependencias con opiniones incorporadas.
Empieza separando tres categorías:
- Llamadas compatibles directamente. Son referencias del SDK que la herramienta afirma poder convertir. Son candidatas a una transformación automatizada, no salidas automáticamente correctas.
- Dependencias adyacentes del proveedor. Incluyen identidad, configuración, redes, despliegue, registros, trazas, secretos, bindings de eventos y definiciones de infraestructura. Pueden ser visibles en el mismo repositorio, pero no están cubiertas por las correspondencias de servicios enumeradas.
- Comportamiento de negocio. Incluye idempotencia, orden, retención, intención de autorización, validación de datos, procedimientos de recuperación y gestión de errores visible para el usuario. No puede inferirse de forma segura a partir de una correspondencia de servicios uno a uno.
El informe también debe revisarse para comprobar las elecciones de servicios de destino. AWS documenta destinos predeterminados, pero permite a los equipos personalizar el plan, incluso excluir algunas o todas las conversiones y redirigir una correspondencia predeterminada. Esto importa cuando la arquitectura de destino no es una sustitución literal de servicios. Por ejemplo, un equipo puede optar por mantener una interfaz orientada a objetos en la aplicación e introducir un adaptador de almacenamiento, o decidir que una carga de trabajo de cola corresponde a otro servicio de integración después de medir los requisitos de rendimiento y orden.
Un recurso útil para la revisión es una tabla con una fila por cada dependencia específica del proveedor:
| Dependencia | Comportamiento de origen | Destino propuesto | Comportamiento que debe demostrarse | Responsable |
|---|---|---|---|---|
| Carga de blobs | sobrescritura, metadatos, retención | operación de S3 | coherencia y comportamiento de las políticas | equipo de almacenamiento |
| Recepción de cola | reglas de reintento y visibilidad | flujo de recepción de SQS | gestión de duplicados y mensajes no procesables | equipo de servicios |
| Disparador de función | forma del evento y tiempo de espera | invocación de Lambda | tiempo de espera, concurrencia y reintentos | equipo de plataforma |
| Identidad | identidad administrada y ámbitos | rol y políticas de IAM | mínimo privilegio y rotación | equipo de seguridad |
El propósito no es crear burocracia. Evita que un diff generado se convierta en el documento de arquitectura de facto.
Lo que la función hace bien
Existe una ganancia de eficiencia legítima cuando la aplicación usa SDK de Azure compatibles en código .NET convencional. La herramienta puede encontrar referencias a servicios, ofrecer un plan de modernización y reescribir patrones conocidos a una escala que, de otro modo, consumiría tiempo de desarrollo. También puede dejar marcadores explícitos cuando una conversión no está disponible, incluidos comentarios TODO, stubs o un documento con los siguientes pasos, según la documentación de AWS.
Eso resulta valioso en tres situaciones.
La primera es la evaluación de una cartera. Una organización con muchos servicios .NET puede usar el análisis para descubrir hasta qué punto cada aplicación depende de Azure. El resultado puede mejorar la secuenciación incluso cuando un servicio todavía no está listo para migrar.
La segunda es una fase de traducción repetitiva. Una vez acordados los contratos de destino y los patrones de infraestructura, las ediciones automatizadas pueden eliminar una gran cantidad de trabajo mecánico. Los ingenieros pueden dedicar más tiempo al comportamiento y menos a cambiar espacios de nombres, construir clientes y ajustar formas de solicitud rutinarias.
La tercera es una rama de modernización controlada. Un equipo puede ejecutar la conversión sobre una copia de la aplicación, comparar el resultado con sus límites de abstracción existentes y usar el diff resultante para identificar el código que debería aislarse antes de iniciar la migración.
La función resulta menos útil cuando el repositorio está dominado por infraestructura como código, vinculaciones con documentación escasa, integraciones personalizadas con Azure, patrones complejos de acceso a datos o lógica de aplicación que trata el comportamiento del proveedor como parte del contrato de negocio. Esos casos aún pueden beneficiarse del análisis de código, pero la conversión no debe confundirse con un plan de migración completo.
El problema de la identidad es mayor que cambiar el constructor del cliente
Las migraciones entre proveedores suelen fallar en la frontera entre el código de la aplicación y la autorización. Las aplicaciones de Azure suelen utilizar identidades administradas y asignaciones de roles. Las aplicaciones de AWS utilizan roles y políticas de IAM, con permisos asociados a roles de ejecución, roles de tareas, perfiles de instancia u otras identidades según el entorno de ejecución.
Una llamada convertida del SDK no tiene autoridad por sí misma. La implementación de destino debe proporcionar una identidad capaz de realizar exactamente las acciones necesarias sobre exactamente los recursos requeridos. Esto implica mapear no solo «puede leer un blob» a «puede leer un objeto», sino también el alcance, las condiciones, los nombres de los recursos, las claves de cifrado, la ruta de red y la responsabilidad operativa de ese acceso.
La revisión de la migración debe responder a estas preguntas:
- ¿Qué identidad ejecuta cada función, trabajador y trabajo de implementación?
- ¿Qué política de recursos y qué política de identidad autorizan conjuntamente la llamada?
- ¿El destino utiliza claves de cifrado administradas por el cliente y quién puede usarlas?
- ¿Puede la carga de trabajo llegar al servicio por la ruta de red prevista?
- ¿Las credenciales tienen una vida corta y se rotan sin cambios en la aplicación?
- ¿Qué se registra cuando falla una comprobación de autorización?
Aquí es donde una conversión basada solo en el código puede crear una sensación engañosa de finalización. La aplicación puede compilar, las pruebas pueden pasar con permisos demasiado amplios y la implementación en producción puede seguir fallando porque nunca se diseñó el límite real de las políticas. A la inversa, una solución rápida que conceda un rol amplio puede hacer que la migración «funcione» mientras aumenta el radio de impacto.
Por tanto, la prueba de aceptación de seguridad debe incluir acciones denegadas, intentos de acceso entre recursos y una implementación desde un entorno limpio. Una migración no está completa cuando la solicitud del camino feliz tiene éxito; lo está cuando el modelo de identidades de destino se comprende y está limitado.
El movimiento de datos y la semántica de los datos siguen requiriendo trabajo humano
AWS Transform no mueve los datos que respaldan Azure Blob Storage, Azure Queue Storage o Cosmos DB. Parece obvio, pero cambia el calendario del proyecto. La conversión del código y la migración de datos solo pueden avanzar en paralelo después de que el equipo haya definido cómo coexistirán las dos versiones.
Para los datos de objetos, el plan necesita un inventario del origen, estimaciones del tamaño y del número de objetos, gestión de metadatos y etiquetas, requisitos de cifrado, reglas de retención, registros de acceso y una estrategia de cambio. Una copia que conserve los bytes pero pierda los metadatos aún puede romper a los consumidores. Un cambio que modifique la generación de URL o la semántica de autorización puede romper a los clientes aunque todos los objetos hayan llegado correctamente.
En el caso de las colas, copiar mensajes rara vez es una operación neutral. El equipo debe decidir si los mensajes antiguos se agotarán, se reproducirán, se descartarán o se traducirán. Una reproducción puede activar dos veces los efectos secundarios. Agotar la cola puede prolongar la ventana de migración. Un diseño de escritura dual puede crear divergencias si un proveedor acepta un mensaje y el otro lo rechaza. La opción más segura depende de la idempotencia de la carga de trabajo y de sus consecuencias de negocio.
En las bases de datos, el estado preliminar de Cosmos DB a DynamoDB es una señal para actuar con especial cautela. Los sistemas NoSQL suelen diferir en particionamiento, indexación, consistencia, alcance de las transacciones, lenguaje de consulta, límites de los elementos y comportamiento del registro de cambios. Una capa de acceso a datos convertida no demuestra que el modelo de datos de destino vaya a escalar ni que devuelva los mismos resultados. Los equipos deben modelar patrones de acceso representativos y ejecutar comprobaciones de calidad de datos antes de comprometerse con un cambio en vivo.
El plan de migración debe indicar cuál es la fuente de verdad en cada etapa. «Los datos están en ambas nubes» no es una estrategia de consistencia.
Las pruebas deben comparar contratos, no solo resultados
Una suite convencional de pruebas unitarias puede verificar que el código convertido devuelve los valores esperados a partir de clientes simulados. Es necesario, pero no suficiente, porque los mocks suelen conservar la abstracción diseñada por el proveedor original.
Un plan de pruebas más sólido tiene varias capas.
Las pruebas de contrato verifican las expectativas propias de la aplicación: esquemas de mensajes, metadatos de objetos, decisiones de autorización, gestión de reintentos y clasificación de errores. Estas pruebas deben ejecutarse contra los servicios de destino cuando el comportamiento sea relevante.
Las pruebas diferenciales someten cargas equivalentes a las implementaciones de origen y destino y comparan los resultados a nivel de negocio. La comparación no debe exigir errores del proveedor ni identificadores de solicitud idénticos. Debe comprobar aquello de lo que dependen los usuarios, los servicios posteriores y los operadores.
Las pruebas de fallos inyectan limitación de tasa, tiempos de espera agotados, escrituras parciales, entregas duplicadas, credenciales caducadas, dependencias no disponibles y eventos malformados. El objetivo es revelar dónde divergen los modelos de fallo de origen y destino.
Las pruebas operativas validan registros, métricas, trazas, alarmas, paneles y procedimientos operativos. Un servicio migrado que funciona pero no puede diagnosticarse no está listo para producción.
Las pruebas de seguridad confirman las políticas de privilegio mínimo y verifican que la carga de trabajo no pueda leer, escribir ni invocar recursos fuera de su límite previsto.
En las cargas de trabajo sin servidor, incluye el comportamiento de concurrencia y arranque en frío, los márgenes de tiempo de espera, los reintentos del origen de eventos y la reversión del despliegue. En las colas, mide el tiempo de visibilidad según la distribución real del procesamiento, en lugar de elegir un valor conocido. En el almacenamiento de objetos, prueba los metadatos, el cifrado, las escrituras condicionales y las URL de acceso. Para la conversión de bases de datos, reproduce formas de consulta reales y compara la paginación, la consistencia y la gestión de fallos.
Una secuencia de migración más segura
Un equipo que evalúe la nueva capacidad puede reducir el riesgo acotando el primer proyecto.
Elige un servicio con un responsable claro, un número limitado de dependencias de proveedores compatibles y una reversión comprobable. Evita empezar por el sistema que combina federación de identidades, distribución de eventos, datos regulados y procedimientos operativos sin documentar.
Antes de ejecutar la conversión, crea un mapa de dependencias del origen. Incluye paquetes del SDK, variables de entorno, vinculaciones, manifiestos de despliegue, secretos, extremos de red, almacenes de datos, colas, activadores programados e integraciones de monitorización.
Después, define los contratos de destino. Decide cómo representará la aplicación el almacenamiento, la mensajería, la configuración, la identidad y la telemetría. Si las llamadas específicas del proveedor están dispersas por la lógica de negocio, introduce o refuerza adaptadores antes de la conversión. Esto aumenta el trabajo de preparación, pero facilita la revisión de las diferencias resultantes y abarata los cambios futuros.
Ejecuta la evaluación y revisa cada asignación propuesta. Registra las exclusiones intencionadas. Trata las llamadas no compatibles como trabajo planificado, no como limpieza que pueda dejarse para el final.
Crea la infraestructura de destino por separado. Usa roles de IAM con el alcance mínimo necesario, recursos cifrados, conectividad privada cuando sea necesaria, registros, alarmas, copias de seguridad y controles de despliegue. No uses el código de aplicación generado como sustituto de la revisión de infraestructura.
Convierte el código en una rama, compílalo y ejecuta análisis estático. Después, prueba contra servicios de destino reales con datos representativos e inyección de fallos. Mantén disponible la implementación de origen hasta demostrar los contratos empresariales y operativos de la migración.
Para el cambio, prefiere una secuencia reversible: despliega sin tráfico, valida las lecturas, ejecuta escrituras no destructivas, compara la telemetría, transfiere una pequeña cantidad de tráfico o carga de trabajo y define el disparador de reversión antes de aumentar la proporción. El mecanismo exacto variará según la aplicación, pero el principio es constante: la conversión debe acortar la fase mecánica sin acortar la fase de evidencias.
La cuestión de gobernanza para los equipos de plataforma
AWS Transform cambia la economía de la traducción de código, por lo que más organizaciones podrían intentar migraciones entre proveedores con equipos más pequeños. Es útil, pero también puede adelantar el riesgo en el proceso. Cuando transformar código resulta barato, las decisiones de arquitectura y la validación se convierten en los recursos escasos.
Los equipos de plataforma deberían establecer un punto de revisión estándar para las migraciones generadas. Debería exigir:
- un inventario completo de las dependencias del proveedor convertidas y no convertidas;
- una arquitectura de destino y un modelo de identidad aprobados;
- un plan de migración de datos y reversión;
- pruebas de la semántica específica del proveedor y del comportamiento ante fallos;
- pruebas de que la observabilidad y la respuesta a incidentes funcionan en el destino;
- un responsable humano para cada TODO o stub sin resolver;
- una decisión documentada para cualquier asignación predeterminada que se haya cambiado.
El control debe ser proporcional. Una función interna pequeña que almacena objetos no sensibles no necesita el mismo proceso que un servicio de transacciones regulado. Pero ambos necesitan un responsable identificado y una forma de demostrar que el comportamiento convertido es aceptable.
La política clave es mantener el código generado sujeto a revisión. Guarda el informe de evaluación, el plan de modernización, el diff de transformación, las pruebas y las excepciones junto con el registro de cambios del servicio. Si la conversión se vuelve a ejecutar más adelante, el equipo debe poder explicar qué cambió y por qué.
Qué habrá que observar a continuación
El anuncio actual cubre un conjunto específico de asignaciones de Azure a AWS y mantiene Cosmos DB a DynamoDB en vista previa. Eso sugiere que AWS empieza por puntos de traducción comunes y reconocibles, en lugar de afirmar que existe portabilidad universal.
Los equipos deberían observar los cambios en las versiones compatibles de .NET, los servicios de Azure adicionales, el tratamiento de la infraestructura y la forma en que la herramienta informa de las conversiones inciertas. También deberían vigilar sus propios resultados de prueba. Un patrón que parece equivalente en un servicio pequeño puede comportarse de otra manera con un volumen mayor, durante los reintentos o bajo políticas de identidad más estrictas.
Por ahora, el consejo práctico es usar AWS Transform donde resulta más sólido: para inventariar dependencias y acelerar cambios de código repetitivos. La arquitectura, los datos, la identidad y la aceptación en producción deben seguir bajo una revisión humana explícita. La función puede hacer que aparezca rápidamente una rama de migración. No puede hacer que ambas nubes compartan los mismos contratos.
Esa es la decisión que los equipos de plataforma deben tomar antes de aprobar la primera solicitud de cambios: no «¿el agente convirtió el código?», sino «¿qué pruebas demuestran que este servicio sigue comportándose correctamente, de forma segura y operable después de trasladar el límite entre proveedores?»
Related articles
AWS corrige bypasses del modo de solo lectura en servidores MCP de bases de datos: qué deben revisar los operadores
Dos boletines de seguridad de AWS revelan un problema recurrente en herramientas MCP conectadas a bases de datos: un filtro de texto no es una frontera de autorización. Estas son las versiones afectadas, las condiciones de riesgo y las medidas de contención.
AWS fixes read-only bypasses in database MCP servers: what operators need to check
Two AWS security bulletins published on September 9 expose a recurring design problem in database-connected MCP tools: a text filter is not an authorization boundary. Here is who is affected, what the disclosures actually say, and how to contain the risk.
Amazon S3 arrive dans la Marketplace de Vercel : un provisionnement plus simple, une nouvelle gouvernance pour les équipes plateforme
Amazon S3, S3 Tables et S3 Vectors peuvent désormais être provisionnés depuis Vercel et v0. Le véritable enjeu est de préserver la propriété AWS, les frontières d’accès, les contrôles sur les données et la visibilité des coûts lorsque le stockage rejoint le workflow de déploiement.
La nouvelle expérience de développement d’AWS réduit les frictions du cloud — et rend indispensable une première revue de gouvernance
AWS simplifie l’arrivée dans le cloud avec des projets préconfigurés, des permissions gérées, la connexion d’agents de programmation et des plafonds de dépenses. Cette rapidité impose toutefois de vérifier immédiatement les identités, la région, les quotas et les accès générés.
Comments
Sign in to comment.
No comments yet.