L’apprentissage fédéré vérifiable de Google change la question de la confidentialité pour les acheteurs d’IA
Le système d’apprentissage fédéré de Google associe environnements d’exécution de confiance, journaux transparents et confidentialité différentielle. Pour les acheteurs d’IA, l’enjeu est de distinguer les protections techniquement imposées des promesses qui restent à vérifier.
Les derniers travaux de Google sur l’apprentissage fédéré pourraient facilement être classés dans la recherche sur les infrastructures. Ce serait passer à côté de l’essentiel. Le changement important ne tient pas seulement au fait qu’un modèle peut apprendre à partir de données conservées sur des téléphones ou dans plusieurs organisations. Il tient aussi à la conception du processus d’entraînement côté serveur : des tiers peuvent examiner les charges de travail autorisées, vérifier l’identité du logiciel et contrôler que seuls des résultats anonymisés sont transmis.
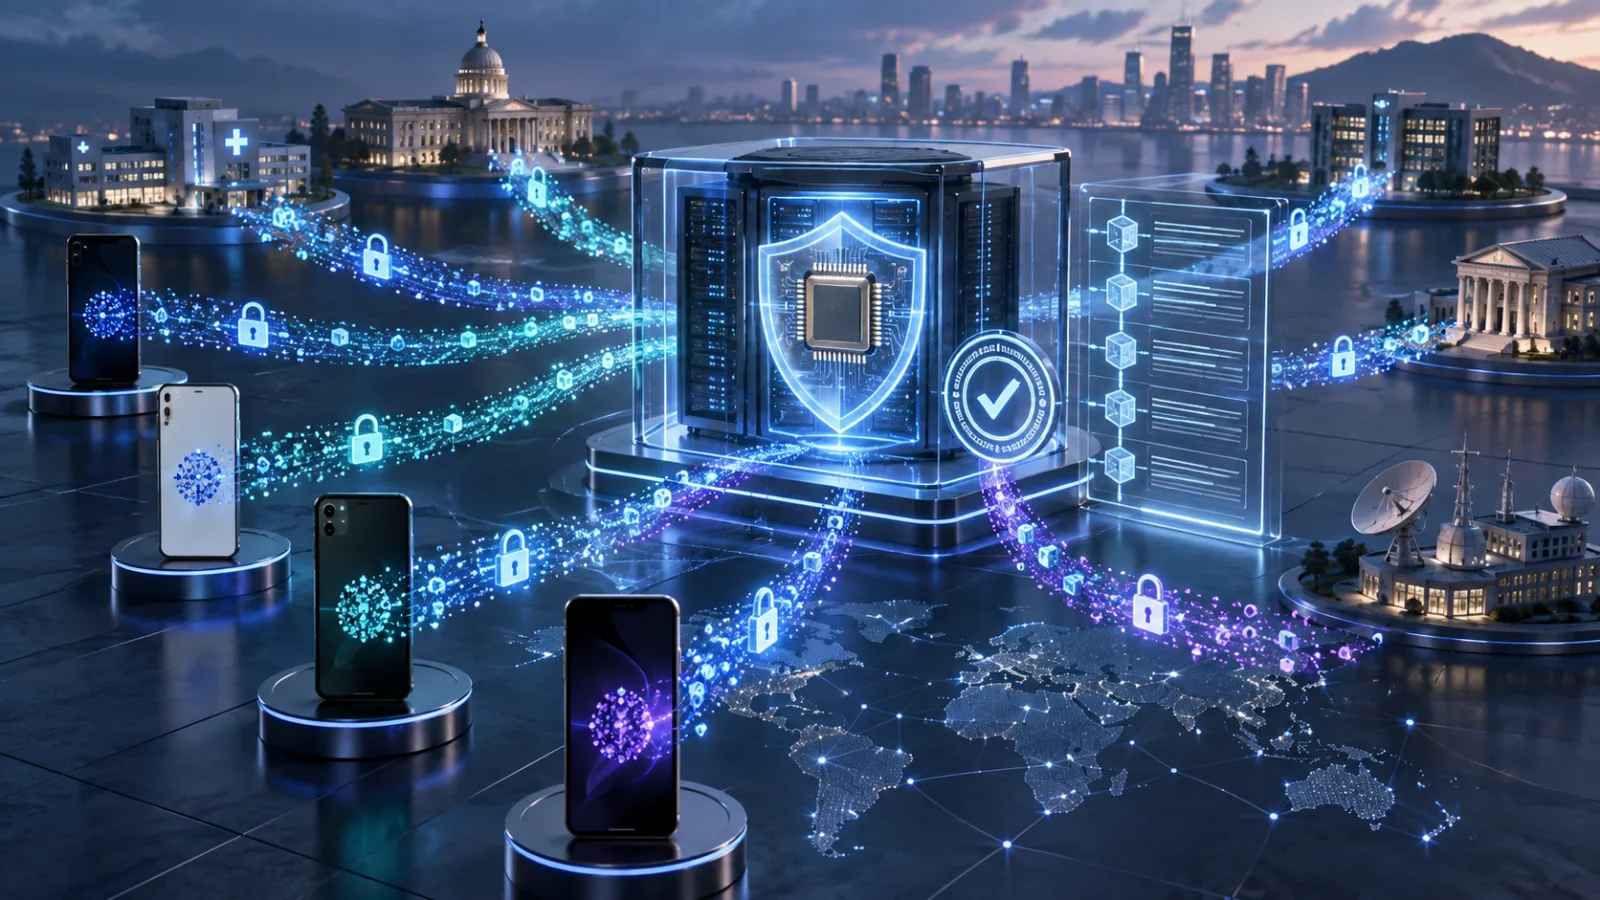
Le 2 octobre, Google Research a annoncé un nouveau système d’apprentissage fédéré fondé sur des environnements d’exécution de confiance (TEE), des journaux publics de transparence, des téléversements chiffrés et la confidentialité différentielle. Google affirme que le système est déjà utilisé pour les modèles de prédiction du mot suivant de Gboard en anglais et en japonais, avec un entraînement plus rapide et un meilleur compromis entre confidentialité et utilité que dans son dispositif précédent. L’article associé décrit l’architecture et son déploiement en production.
Cela ne signifie pas que l’apprentissage fédéré soit soudain devenu une réponse universelle pour l’IA privée. En revanche, la discussion d’achat passe d’une promesse familière — « les données brutes restent là où elles se trouvent » — à une question plus difficile : l’organisation peut-elle prouver ce que le service d’entraînement était autorisé à faire des données après leur arrivée ?
Pour les entreprises qui envisagent d’utiliser l’IA sur des textes sensibles, des informations de santé, des dossiers financiers, des données télémétriques industrielles ou des données partagées entre institutions, cette distinction est utile. Un système peut éviter un entrepôt central de données brutes tout en révélant des informations par l’intermédiaire des mises à jour, des journaux, des habitudes de participation, du comportement du modèle ou de contrôles opérationnels insuffisants. La confidentialité est une propriété de l’ensemble du flux de travail, pas la conséquence du nom donné à l’architecture.
Ce que Google a réellement annoncé
L’apprentissage fédéré répartit certaines étapes de l’entraînement d’un modèle entre plusieurs clients. Dans une conception courante fondée sur les appareils, les téléphones ou autres terminaux calculent des mises à jour locales à partir de leurs données, envoient des mises à jour protégées à un coordinateur, puis reçoivent un modèle révisé. Le fournisseur du service n’a pas besoin de rassembler les exemples originaux dans une base d’entraînement classique. Google a présenté cette approche en 2017 et l’a utilisée pour des fonctions comme la prédiction du mot suivant de Gboard, Smart Compose, les suggestions de réponse et Smart Text Selection, selon son annonce de recherche.
La nouvelle conception modifie l’endroit où s’effectue une partie du travail coûteux. Les appareils clients téléversent des exemples d’entraînement chiffrés, tandis que des TEE côté serveur exécutent le programme d’apprentissage. Un TEE est un environnement isolé, protégé par le matériel, conçu pour assurer la confidentialité et l’intégrité du code et des données pendant le calcul. Il peut aussi prendre en charge l’attestation à distance : un vérificateur peut contrôler qu’une charge de travail approuvée est en cours d’exécution avant de libérer des clés ou des données.
Le système de Google associe cette propriété à une politique d’accès. Celle-ci définit quelles charges de travail côté serveur peuvent traiter un téléversement. L’appareil autorise la politique avant d’envoyer les données chiffrées, et un service de gestion des clés ne libère les clés de déchiffrement qu’à une charge de travail correspondant à cette politique. Google indique que ces politiques sont publiées dans Rekor, un journal public de transparence, afin que les auditeurs puissent observer quelles charges de travail côté serveur étaient accessibles aux appareils participants.
Le système utilise également un service de gestion des clés hébergé dans un TEE, un TEE racine de traitement, des TEE de travail pour les tâches parallèles et un état de récupération chiffré pour assurer la tolérance aux pannes. La logique d’entraînement est exprimée avec Federated Language, un langage d’orchestration open source dérivé de TensorFlow Federated. Les opérateurs de la charge de travail ne sont censés recevoir que des métriques et des poids de modèle protégés par confidentialité différentielle, et non des exemples d’entraînement individuels.
Il s’agit d’une surface de contrôle plus concrète qu’une déclaration de confidentialité dans une brochure produit. La question n’est plus seulement de savoir si un fournisseur affirme qu’il ne consultera pas les données. Il faut déterminer si les données ne peuvent être déchiffrées que par une charge de travail attestée, si la charge autorisée est enregistrée, si la compilation peut être reproduite et si le mécanisme de sortie limite ce qui quitte l’environnement protégé.
Pourquoi « les données ne sortent jamais » n’a jamais suffi
On résume souvent l’apprentissage fédéré par l’expression « amener le modèle aux données ». Ce raccourci aide à expliquer l’idée de base, mais il masque plusieurs modes de défaillance.
Une mise à jour d’entraînement peut contenir des informations sur les exemples qui l’ont produite. Un service d’agrégation peut être capable d’examiner les mises à jour avant de les combiner. Un coordinateur malveillant ou compromis peut modifier le code d’entraînement. Les journaux peuvent révéler qui a participé, quand et à quelle fréquence une population donnée a contribué. Un modèle publié sans garantie suffisante de confidentialité peut permettre à un attaquant d’inférer des éléments sur son ensemble d’entraînement. Même une structure intermédiaire apparemment privée peut divulguer des informations lorsqu’elle est interrogée à répétition ou combinée avec des connaissances externes.
C’est pourquoi l’apprentissage fédéré préservant la confidentialité combine généralement plusieurs techniques au lieu de s’appuyer sur une seule. L’agrégation sécurisée peut empêcher le coordinateur de voir les mises à jour individuelles, mais elle ne garantit pas à elle seule que le modèle final ne révélera aucune information. La confidentialité différentielle ajoute une limite formelle à l’effet des données d’un individu ou d’un groupe sur un résultat publié, mais le coût en utilité dépend de la charge de travail, du volume de données, de la méthode d’échantillonnage et du budget de confidentialité. Les TEE peuvent protéger le code et les données à l’intérieur d’une enclave, mais ils ne font pas disparaître les vulnérabilités matérielles, les canaux auxiliaires, les erreurs d’implémentation, les défaillances de gestion des clés ni une charge de travail trop permissive.
L’annonce de Google est importante parce qu’elle tente de relier ces différentes couches. Le TEE contrôle l’exécution et la libération des clés. La politique et le journal de transparence fournissent une trace d’audit. La confidentialité différentielle limite les poids de modèle publiés. Les compilations reproductibles offrent un moyen de comparer le code source aux binaires déployés. L’architecture cherche à réduire la confiance placée dans l’opérateur tout en rendant visibles les hypothèses restantes.
La réserve est importante. Google décrit lui-même les garanties des TEE comme soumises aux limites de la génération actuelle. L’entreprise précise également que la logique liée à la confidentialité doit rester codée en dur dans le programme d’entraînement Python lorsque les architectures de modèle propriétaires ou les détails de prétraitement sont chargés dynamiquement. Cela crée une frontière que les auditeurs doivent comprendre : tous les paramètres ou composants d’une charge de travail en production n’offrent pas nécessairement le même niveau d’examen que le mécanisme de confidentialité lui-même.
Le passage utile de la confiance dans le serveur à la vérification de la charge de travail
Les achats traditionnels d’IA hébergée portent souvent sur l’emplacement de stockage des données, la durée de conservation des requêtes, l’utilisation éventuelle du contenu client pour l’entraînement et les administrateurs autorisés à accéder à l’environnement. Ces questions restent nécessaires. Elles ne suffisent pas lorsqu’un service calcule sur des données chiffrées ou distribuées.
Un examen plus exigeant demande ce que le service est techniquement empêché de faire. Par exemple :
- Quels programmes précis sont autorisés à déchiffrer et à traiter les données ?
- Le client ou un auditeur indépendant peut-il vérifier l’identité de la charge de travail avant la libération des clés ?
- La politique d’autorisation est-elle immuable pendant un entraînement, ou un opérateur privilégié peut-il la modifier ensuite ?
- Les changements de politique sont-ils inscrits dans un journal public ou visible par le client ?
- Les binaires d’entraînement sont-ils compilés de manière reproductible à partir d’un code source que les examinateurs peuvent inspecter ?
- Quelles informations sont publiées à chaque étape : mises à jour individuelles, mises à jour agrégées, métriques, points de contrôle, représentations vectorielles ou seulement modèle final ?
- Quel calcul de confidentialité différentielle est utilisé, et couvre-t-il les publications répétées dans le temps ?
- Que se passe-t-il lorsqu’un travailleur tombe en panne, qu’un instantané de récupération est restauré ou qu’un modèle est rétabli ?
Ce sont des questions opérationnelles, pas des détails théoriques. Un système qui y répond avec précision est plus facile à gouverner, car ses affirmations peuvent être confrontées à des éléments concrets : binaires signés, enregistrements d’attestation, journaux de libération des clés, registres de confidentialité, dépôts de code source et procédures de gestion des incidents. Un système qui répond seulement par une assurance générale de confidentialité laisse le client dépendant du processus interne du fournisseur.
La conception de Google utilise Rekor pour le journal de transparence et indique que le KMS ainsi que les binaires de traitement des données peuvent être compilés de façon reproductible à partir de code open source du dépôt Confidential Federated Compute. Cela ne constitue pas un audit indépendant de chaque déploiement, mais cela donne aux examinateurs quelque chose de plus utile qu’un paragraphe de politique : un chemin pour inspecter les charges de travail autorisées et comparer l’implémentation à la conception annoncée.
La distinction ressemble à celle qui existe entre une base de données chiffrée et une politique d’accès aux données vérifiable. Le chiffrement protège le contenu dans certains états. Une politique explique qui peut y accéder et dans quel but. La vérification donne à une autre partie un moyen de tester si le système respecte cette politique. Une ingénierie mature de la confidentialité a besoin des trois.
L’intérêt pratique de déplacer le calcul vers le serveur
La partie la plus contre-intuitive de l’annonce de Google est que des garanties de confidentialité plus fortes peuvent aller de pair avec davantage de calcul côté serveur. Les premiers systèmes fédérés dépendaient fortement de la disponibilité des appareils, de leurs capacités de calcul, des conditions réseau et de la concurrence avec d’autres tâches. Si un groupe utile d’appareils était indisponible, les cycles d’entraînement pouvaient durer plus longtemps ou produire de moins bons résultats.
Google indique que certains modèles fédérés antérieurs de Gboard demandaient un à deux mois d’entraînement. Dans sa nouvelle architecture, le système collecte d’abord des téléversements chiffrés, puis choisit un calendrier de participation côté serveur à l’intérieur de la charge de travail protégée. Il peut ainsi optimiser la sélection des appareils et les paramètres de confidentialité différentielle après avoir observé leur disponibilité, au lieu de laisser le rythme de l’entraînement dépendre entièrement des téléphones connectés à un moment donné. Google rapporte que le goulot d’étranglement actuel est la disponibilité des ressources TEE plutôt que le calcul sur les appareils.
Il s’agit d’un compromis d’ingénierie réel. Garder le calcul sur les terminaux peut réduire ce qu’observe un service central, mais cela limite aussi la taille des modèles, le choix des algorithmes, la consommation d’énergie et la planification. Déplacer le calcul dans un environnement serveur protégé peut rendre l’entraînement plus prévisible et permettre potentiellement des modèles plus grands. La justification en matière de confidentialité dépend alors des protections de cet environnement : attestation, libération des clés, application de la politique, contrôle des sorties et modèle de menace propre au matériel.
Pour une entreprise, cela signifie que « fédéré » ne doit pas être considéré comme synonyme de « sur l’appareil ». Un système de production peut comporter une phase distribuée de collecte des données, une phase de transfert chiffré, une phase de calcul confidentiel côté serveur et une phase de publication protégée par confidentialité différentielle. Chaque phase possède ses propres modes de défaillance et son propre profil de coût.
Ce que la confidentialité différentielle apporte — et ce qu’elle ne fait pas
La confidentialité différentielle est un cadre mathématique permettant de quantifier la perte de confidentialité. Le SP 800-226 du NIST la décrit comme une manière de raisonner sur l’effet de la présence ou de l’absence des données d’une entité sur un résultat, tout en avertissant que les implémentations réelles comportent de nombreux risques et choix de conception.
En pratique, un système d’entraînement différentiel privé limite l’influence des données d’un participant sur un résultat publié. Les mécanismes courants plafonnent l’influence des mises à jour individuelles et ajoutent un bruit calibré. Un budget de confidentialité plus faible implique généralement une garantie formelle plus forte, mais trop de bruit peut réduire la précision. Le compromis dépend du nombre de participants, de la réutilisation des données, de l’unité de confidentialité — enregistrement, utilisateur, appareil ou organisation — et du nombre de résultats publiés.
Ce dernier point est facile à manquer. Un modèle peut disposer d’une garantie de confidentialité pour un entraînement donné, tandis qu’une suite de points de contrôle, de tableaux analytiques, d’expériences ou de variantes du modèle consomme un budget supplémentaire. L’organisation a besoin d’un registre et d’une politique de publication, pas seulement d’une valeur epsilon indiquée une fois dans un article de recherche. Elle doit aussi préciser quelle vie privée est protégée. La confidentialité au niveau de l’utilisateur est une affirmation différente de la confidentialité au niveau de l’événement ; protéger une seule frappe n’est pas la même chose que limiter l’influence de tout ce qu’une personne a fourni pendant des mois.
La confidentialité différentielle ne résout pas non plus la gouvernance des données avant l’entraînement. Elle ne décide pas si l’organisation disposait d’une base légale pour collecter les données, si les personnes ont été informées de leur utilisation, si les étiquettes sont équitables ou si le modèle obtenu peut être déployé en sécurité. Elle n’empêche pas automatiquement une charge de travail autorisée d’apprendre la mauvaise cible. Elle limite les fuites d’information dans les sorties ; elle ne remplace ni la limitation de la finalité, ni le contrôle d’accès, ni les règles de conservation, ni un processus clair de suppression.
La bonne question pour un acheteur n’est donc pas : « Ce système utilise-t-il la confidentialité différentielle ? » Il faut demander : « Quelle est l’unité de confidentialité, quel est le budget, quelles publications le consomment, qui vérifie les calculs et quelle perte d’utilité a été mesurée sur notre tâche ? »
Là où les TEE aident, et là où la confiance demeure
Un TEE peut réduire la nécessité de faire confiance aux opérateurs du cloud avec des données en clair pendant leur traitement. C’est utile pour les charges de travail où le fournisseur doit calculer, mais où le client ne veut pas que les administrateurs ordinaires de l’hôte, les locataires voisins ou l’opérateur du service consultent les données. L’attestation à distance peut relier la décision de libérer une clé à une identité logicielle mesurée.
Mais un TEE n’est pas une boîte magique de confidentialité. Les acheteurs devraient poser au moins cinq questions complémentaires.
Premièrement, quels matériels et micrologiciels sont concernés ? Les TEE dépendent des fonctions du processeur, du micrologiciel, des clés cryptographiques et des mises à jour de sécurité du fournisseur. Le modèle de menace peut exclure certains acteurs privilégiés ou supposer que certains canaux auxiliaires ne sont pas exploitables.
Deuxièmement, quel code est mesuré et attesté ? La réponse devrait inclure l’environnement d’exécution, la logique de gestion des clés, le programme d’entraînement, les bibliothèques pertinentes et tous les composants chargés dynamiquement. Si seul un petit lanceur est mesuré tandis qu’une logique importante de confidentialité est récupérée plus tard, l’affirmation d’attestation peut être plus étroite qu’elle n’en a l’air.
Troisièmement, comment les secrets sont-ils libérés ? La gestion des clés devrait être liée à une charge de travail approuvée et à une politique explicite. Un administrateur humain qui peut contourner cette décision fait partie du modèle de menace, même si le chemin normal est contraint cryptographiquement.
Quatrièmement, que peut-on déduire des métadonnées ? Le calendrier, l’appartenance à un groupe, la taille des requêtes, les motifs d’échec et les calendriers de publication peuvent contenir des informations même lorsque les charges utiles sont chiffrées. Un examen de confidentialité doit couvrir le trafic et les métadonnées opérationnelles visibles par chaque participant.
Cinquièmement, que se passe-t-il pendant la réponse à un incident ? Un hôte compromis, une mesure révoquée, une enclave vulnérable ou une chaîne de compilation défaillante nécessitent une réponse pratique : interrompre la libération des clés, renouveler les clés, invalider les charges de travail, conserver les éléments de preuve et déterminer si les résultats déjà publiés restent fiables. Un système qui n’est privé que lorsque rien ne va mal n’est pas prêt pour une utilisation sensible en production.
Les recommandations antérieures du NIST sur l’apprentissage fédéré préservant la confidentialité illustrent le même principe sous un autre angle. Dans sa discussion de l’intersection privée et des filtres de Bloom, le NIST note que des techniques destinées à rapprocher des données peuvent malgré tout révéler des informations sur les correspondances et que des protections plus fortes entraînent souvent des coûts de performance. Il ne recommande pas de rejeter ces techniques ; il recommande d’inclure leurs fuites dans le modèle de menace et de prendre une décision explicite sur leur acceptabilité.
Les frictions de mise en place sont importantes
Une entreprise ne peut pas adopter cette architecture en activant une option de confidentialité dans une API d’IA ordinaire. Le travail difficile commence avant l’entraînement du modèle.
L’équipe doit définir le propriétaire des données, l’unité de confidentialité, la finalité autorisée, les limites de conservation et les sorties qui peuvent quitter l’environnement protégé. Elle doit décider si les clients téléversent des exemples, des gradients, des caractéristiques ou une autre représentation. Elle doit construire ou adopter un chemin d’attestation, un service de gestion des clés, un format de politique, un journal de transparence, une chaîne de compilation reproductible et un outil de calcul de la confidentialité. Elle doit tester la récupération et la révocation. Elle doit documenter la relation entre le calcul confidentiel et les obligations légales ou contractuelles.
La surface d’ingénierie est également plus large qu’un script d’entraînement. Un déploiement de production a besoin de bibliothèques clientes, de mécanismes d’inscription et de mise à jour, d’identités cryptographiques, d’une planification des charges de travail, d’une observabilité qui ne collecte pas trop de métadonnées sensibles, de contrôles de chaîne d’approvisionnement logicielle et d’un moyen de comparer le déploiement mesuré au code source examiné. Les organisations qui exploitent déjà une infrastructure mobile, des flottes d’appareils, des grappes de calcul confidentiel ou des pipelines de données réglementés sont mieux placées que les équipes qui partent d’un simple carnet de notes.
Les coûts apparaîtront à plusieurs endroits. Les TEE exigent du matériel compatible, peuvent réduire la capacité disponible et compliquer l’accès aux accélérateurs. Les services d’attestation et de gestion des clés ajoutent des dépendances opérationnelles. La journalisation publique et les compilations reproductibles exigent une discipline de publication. La confidentialité différentielle peut demander davantage de participants, de cycles ou de données pour atteindre une précision acceptable. Les audits et les exercices d’équipe rouge deviennent un coût récurrent plutôt qu’un travail effectué seulement au lancement.
L’architecture peut malgré tout coûter moins cher qu’une centralisation lorsque celle-ci créerait une exposition juridique, de sécurité ou contractuelle inacceptable. Elle n’est toutefois pas automatiquement moins coûteuse qu’un entraînement classique. La bonne comparaison porte sur le coût total d’un modèle réussi et conforme : infrastructure, ingénierie, audits, perte de performance, préparation aux incidents et valeur du maintien de l’accès à des données qui ne peuvent pas être regroupées sous leur forme ordinaire.
Qui devrait essayer cette approche
Ce modèle est particulièrement prometteur lorsque les données sont distribuées pour une raison précise et que la tâche d’apprentissage bénéficie de la combinaison de signaux provenant de plusieurs participants. Les exemples comprennent la personnalisation sur appareil, la détection de fraude entre organisations, la recherche clinique lorsque les établissements ne peuvent pas partager leurs dossiers bruts et les données industrielles ou de terrain qui restent sous contrôle local.
Il constitue un bon candidat lorsque l’objection principale de l’organisation à l’entraînement centralisé n’est pas une simple préférence de fournisseur, mais une exposition concrète : interdiction contractuelle, population sensible, contrainte réglementaire ou menace crédible provenant d’initiés et d’infrastructures compromises. Dans ces situations, l’autorisation vérifiable de la charge de travail peut modifier sensiblement l’évaluation des risques.
Il mérite également d’être étudié lorsqu’un acheteur doit fournir une réponse défendable à des auditeurs ou à des partenaires. Un journal de transparence, une compilation reproductible, un enregistrement d’attestation et un registre de confidentialité créent des preuves qui pourront être examinées plus tard. Ces éléments ne règlent pas toutes les questions, mais ils améliorent la qualité du dialogue entre l’ingénierie, la sécurité, les services juridiques et les propriétaires des données.
Un petit projet pilote devrait commencer par une tâche dont l’unité de confidentialité et la métrique de réussite sont claires. La prédiction du mot suivant est un exemple pratique, car le système peut mesurer la précision, la vitesse d’entraînement, la participation et le calcul de la confidentialité sur plusieurs cycles. Une entreprise devrait choisir un flux de travail tout aussi délimité : un problème de classification étroit, un nombre limité d’organisations participantes et une cadence de publication définie. Le pilote devrait comparer la conception protégée à une référence classique et rendre compte de l’utilité, de la latence, du coût, des fuites et de la charge opérationnelle.
Qui devrait encore s’en abstenir
Une équipe ne devrait probablement pas commencer par cette architecture si elle n’a aucun problème de données distribuées. Si toutes les données pertinentes sont déjà autorisées pour un usage centralisé, un cloud privé bien contrôlé ou un environnement d’entraînement isolé peut être plus simple à sécuriser et à expliquer. L’apprentissage fédéré ajoute une coordination et une mécanique cryptographique ; ce n’est pas automatiquement une amélioration de la confidentialité.
Il convient également mal lorsque les données sont trop rares ou trop inégalement réparties pour permettre un entraînement utile. La confidentialité différentielle exige une participation suffisante et des calculs rigoureux. Un système comptant une poignée de contributeurs peut offrir une garantie formelle tout en produisant un modèle trop bruité, biaisé ou instable pour être déployé.
Les organisations incapables d’exploiter une chaîne d’approvisionnement logicielle, un système de gestion des clés ou un processus de réponse aux incidents devraient éviter de considérer une conception fondée sur les TEE comme un raccourci. Le calcul confidentiel déplace la responsabilité ; il ne la supprime pas. Si l’équipe ne peut pas examiner les changements de charge de travail, révoquer les clés, suivre le budget de confidentialité ou enquêter sur les fuites de métadonnées, l’architecture risque de créer une défaillance plus complexe et plus difficile à gouverner.
Enfin, les équipes doivent être prudentes lorsque la sortie souhaitée est une décision à fort impact concernant des personnes. La protection de la confidentialité ne traite ni la discrimination, ni la possibilité de contester une décision, ni la qualité des données, ni le besoin d’un contrôle humain. Un modèle privé peut toujours prendre une décision injuste.
La liste de contrôle de l’acheteur pour un entraînement privé vérifiable
Avant de souscrire à un service d’apprentissage fédéré, demandez au fournisseur de répondre par écrit aux questions suivantes et de joindre des preuves lorsque c’est possible :
-
Qu’est-ce qui est exactement privé ? La garantie concerne-t-elle les entrées brutes, les mises à jour individuelles, les contributions au niveau de l’utilisateur, le modèle final ou tous ces éléments ?
-
Quel est le modèle de menace ? Inclut-il l’opérateur du service, les administrateurs du cloud, les clients compromis, les participants malveillants, les parties qui colludent et les attaques matérielles ? Quelles attaques sont explicitement hors périmètre ?
-
Qu’est-ce qui est imposé par la cryptographie ou le matériel ? Séparez les promesses contractuelles des contrôles qui empêchent réellement un opérateur de lire les données ou de modifier une charge de travail.
-
Comment fonctionne l’attestation ? Demandez les composants mesurés, la procédure de vérification, les conditions de libération des clés et le processus de révocation.
-
La logique de confidentialité peut-elle être auditée ? Vérifiez si le code source, les dépendances, le processus de compilation, les fichiers de politique et les mesures du déploiement peuvent être inspectés.
-
Comment le budget de confidentialité est-il calculé ? Confirmez l’unité de confidentialité, la méthode de calcul, la composition entre publications, les hypothèses d’échantillonnage et le traitement des nouvelles tentatives et des récupérations.
-
Que quitte l’environnement protégé ? Incluez les métriques, les points de contrôle, les représentations vectorielles, les erreurs, les journaux, les données temporelles, les statistiques de groupe et les éléments transmis au support.
-
Que révèle la participation ? Déterminez si un coordinateur ou un autre participant peut déduire qu’un appareil, un salarié, une organisation ou un groupe de patients donné a contribué.
-
Que se passe-t-il lorsque le modèle se trompe ? Les tests de confidentialité et d’utilité devraient inclure les performances par sous-groupe, la dérive, la résistance à l’empoisonnement et un plan de retour en arrière.
-
Quel est le coût à l’échelle visée ? Chiffrez la capacité TEE, le stockage, la gestion des clés, la journalisation, les audits, les mises à jour clientes, les nouvelles tentatives et le coût en précision d’une confidentialité plus forte.
Si un fournisseur ne peut pas répondre à ces questions, le service peut rester utile pour des expérimentations à faible risque. Il ne devrait pas être considéré comme un contrôle éprouvé pour des données sensibles en production.
La leçon plus large pour les achats d’IA
L’annonce de Google ne proclame pas que le matériel de confiance a résolu l’apprentissage automatique privé. Elle montre que la frontière de confidentialité devient plus opérationnelle. La valeur du système tient au lien entre plusieurs mécanismes : entrée chiffrée, libération des clés contrainte, exécution attestée, politiques auditables, logiciel reproductible, confidentialité différentielle et publication contrôlée. Retirez-en un et l’affirmation devient plus limitée.
Cette évolution change aussi ce que les entreprises devraient mesurer. Un projet d’IA préservant la confidentialité devrait rendre compte de bien plus que la précision du modèle et du coût de l’infrastructure. Il devrait préciser qui pouvait voir quoi, quelles charges de travail étaient autorisées, quelle quantité d’information a été publiée, comment le budget de confidentialité a évolué, comment le système s’est comporté en cas de panne et quelles preuves un examinateur indépendant peut vérifier.
C’est une exigence plus stricte que « nous n’entraînons pas nos modèles sur vos données », mais aussi une exigence plus utile. La promesse de l’apprentissage distribué devient crédible lorsque le propriétaire des données peut inspecter le calcul autorisé, que l’opérateur ne peut pas remplacer discrètement la charge de travail et que la sortie finale s’accompagne d’un coût de confidentialité documenté.
Pour les acheteurs d’IA, le conseil immédiat est simple : considérez l’apprentissage fédéré comme une décision de conception système et d’achat, pas comme une fonction du modèle. Commencez par définir les informations qui doivent rester protégées, les parties auxquelles il ne faut pas faire confiance et les preuves dont un auditeur aura besoin. Vérifiez ensuite si l’architecture proposée impose réellement ces limites. Le nouveau déploiement de Gboard par Google montre que cette approche peut être conçue à l’échelle de la production. La question la plus difficile pour les autres est de savoir si le gain de confidentialité justifie cette mécanique — et si l’organisation est prête à l’exploiter honnêtement.
Sources
- Toward provably private learning from federated data — Google Research, source factuelle et annonce du système.
- Toward provably private learning from federated data — article associé, source factuelle.
- SP 800-226: Guidelines for Evaluating Differential Privacy Guarantees — National Institute of Standards and Technology, contexte sur la confidentialité différentielle.
- Protecting Model Updates in Privacy-Preserving Federated Learning: Part Two — National Institute of Standards and Technology, contexte sur les risques et compromis.
Related articles
L’AI ne remplace pas l’expertise: elle en fait le levier
Les débats sur LLMs, dette cognitive et productivité montrent une règle pratique: AI crée de la valeur quand des experts cadrent, vérifient et intègrent le travail.
L’agent de recherche automatisé est arrivé. Le goulot d’étranglement, désormais, c’est la preuve
OpenAI affirme que ses équipes de recherche mobilisent déjà, au total, davantage d’efforts d’agents que de travail humain. La leçon concrète n’est pas d’abandonner la découverte à la machine, mais de revoir la manière dont les idées sont testées, consignées et écartées.
Les agents de code IA sont utiles. C’est pourquoi les équipes ont besoin d’une politique d’expertise
Le risque n’est pas d’utiliser l’IA, mais de mesurer la vitesse pendant que revue, formation et compréhension prennent du retard.
Une formulation guidée par l’IA maintient des particules de vaccins à ARNm stables à la chaleur — la chaîne du froid pourrait donc devenir moins fragile
Des chercheurs du MIT ont utilisé un algorithme d’apprentissage automatique économe en données pour stabiliser des nanoparticules lipidiques contenant de l’ARNm. Chez la souris, une formulation séchée sous vide est restée active après un an à température ambiante, mais le résultat reste préclinique.
Comments
Sign in to comment.
No comments yet.