El aprendizaje federado verificable de Google cambia la pregunta sobre privacidad para quienes compran IA
El nuevo sistema de aprendizaje federado de Google, basado en TEEs, vuelve más auditables las promesas de privacidad del servidor. Para los equipos que evalúan IA con datos sensibles, la pregunta es qué se aplica técnicamente, qué se promete y qué sigue quedando expuesto.
El trabajo más reciente de Google sobre aprendizaje federado podría archivarse fácilmente como investigación de infraestructura. Eso dejaría fuera lo importante. El cambio no consiste solo en que un modelo pueda aprender de datos conservados en teléfonos o en organizaciones separadas. La novedad práctica es que el entrenamiento del lado del servidor se está diseñando para que terceros puedan inspeccionar qué cargas de trabajo están autorizadas, verificar la identidad del software y comprobar que solo se publican resultados anonimizados.
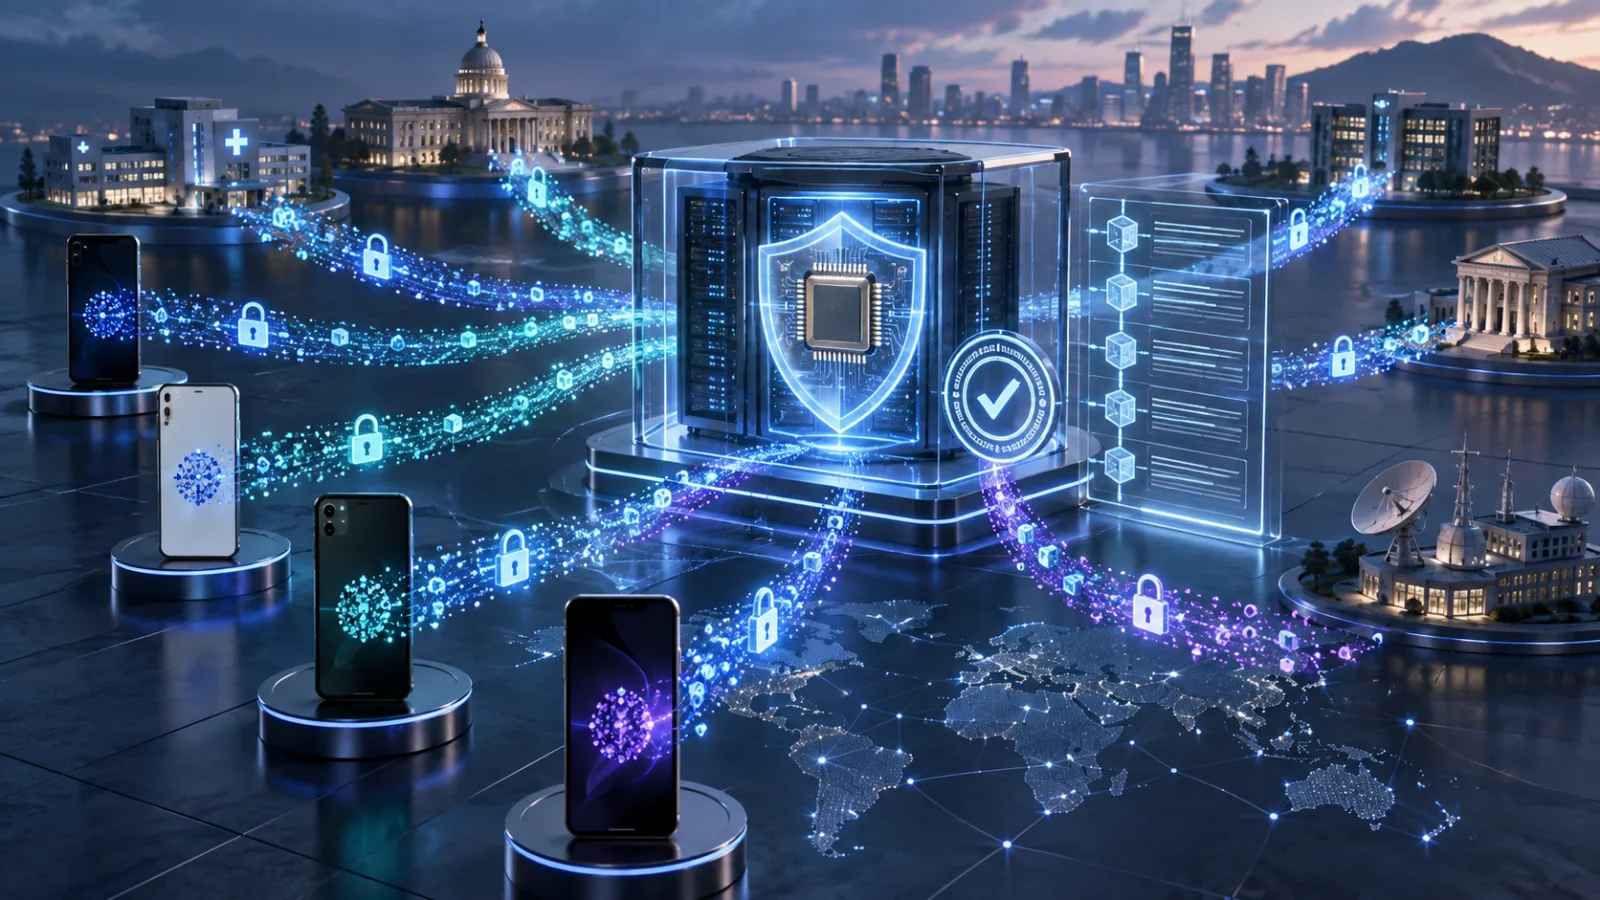
El 2 de octubre, Google Research anunció un nuevo sistema de aprendizaje federado basado en entornos de ejecución confiable (TEE), registros públicos de transparencia, cargas cifradas y privacidad diferencial. Google afirma que el sistema ya se utiliza para los modelos de predicción de la siguiente palabra en inglés y japonés de Gboard, con un entrenamiento más rápido y mejores equilibrios entre privacidad y utilidad que su configuración anterior. El artículo que acompaña el anuncio describe la arquitectura y su despliegue en producción.
Eso no significa que el aprendizaje federado se haya convertido de pronto en una respuesta universal para la IA privada. Sí significa que la conversación de compra está pasando de una promesa conocida —«los datos sin procesar permanecen donde están»— a una pregunta más exigente: ¿puede la organización demostrar qué estaba autorizado a hacer el servicio de entrenamiento con los datos una vez que llegaron?
Para las empresas que consideran usar IA sobre texto sensible, información sanitaria, registros financieros, telemetría industrial o datos compartidos entre instituciones, la distinción resulta útil. Un sistema puede evitar un almacén central de datos sin procesar y aun así revelar información mediante actualizaciones, registros, patrones de participación, comportamiento del modelo o controles operativos débiles. La privacidad es una propiedad de todo el flujo de trabajo, no una consecuencia de ponerle un nombre de moda a la arquitectura.
Qué anunció realmente Google
El aprendizaje federado distribuye partes del entrenamiento de un modelo entre varios clientes. En un diseño conocido basado en dispositivos, los teléfonos u otros extremos calculan actualizaciones locales a partir de sus propios datos, envían actualizaciones protegidas a un coordinador y reciben un modelo revisado. El proveedor del servicio no necesita reunir los ejemplos originales en una base de datos convencional de entrenamiento. Google presentó este enfoque en 2017 y lo ha utilizado en funciones como la predicción de la siguiente palabra de Gboard, Smart Compose, las sugerencias de respuesta y Smart Text Selection, según su anuncio de investigación.
El nuevo diseño cambia el lugar donde se realiza parte del trabajo costoso. Los dispositivos cliente cargan ejemplos de entrenamiento cifrados, mientras que los TEE del servidor ejecutan el programa de entrenamiento. Un TEE es un entorno aislado respaldado por hardware, pensado para proporcionar confidencialidad e integridad al código y a los datos mientras se ejecuta el cálculo. También puede admitir la atestación remota: un verificador puede comprobar que se está ejecutando una carga de trabajo aprobada antes de liberar claves o datos.
El sistema de Google combina esa propiedad con una política de acceso. La política define qué cargas de trabajo del servidor pueden procesar una carga. El dispositivo autoriza la política antes de enviar los datos cifrados, y un servicio de gestión de claves libera las claves de descifrado solo a una carga de trabajo que coincida con ella. Google afirma que esas políticas se publican en Rekor, un registro público de transparencia, para que los auditores puedan observar en qué cargas de trabajo del servidor podían participar los dispositivos.
El sistema también utiliza un servicio de gestión de claves alojado en un TEE, un TEE raíz de procesamiento, TEE trabajadores para tareas paralelas y un estado de recuperación cifrado para tolerar fallos. La lógica de entrenamiento se expresa mediante Federated Language, un lenguaje de orquestación de código abierto derivado de TensorFlow Federated. La salida disponible para los operadores de la carga de trabajo pretende limitarse a métricas y pesos de modelo con privacidad diferencial, en lugar de ejemplos individuales de entrenamiento.
Este es un punto de control más concreto que una declaración de privacidad en un folleto comercial. La pregunta ya no es únicamente si un proveedor dice que no inspeccionará los datos. Pasa a ser si los datos solo pueden descifrarse mediante una carga atestada, si la carga permitida queda registrada, si la compilación puede reproducirse y si el mecanismo de publicación limita lo que sale del entorno protegido.
Por qué «los datos nunca salen» nunca fue suficiente
El aprendizaje federado suele resumirse como «llevar el modelo a los datos». Esa fórmula sirve para explicar la idea básica, pero oculta varios modos de fallo.
Una actualización de entrenamiento puede contener información sobre los ejemplos que la produjeron. Un servicio de agregación podría inspeccionar las actualizaciones antes de combinarlas. Un coordinador malicioso o comprometido podría alterar el código de entrenamiento. Los registros pueden revelar quién participó, cuándo lo hizo o con qué frecuencia contribuyó una población concreta. Un modelo publicado sin una garantía de privacidad suficiente podría permitir que un atacante infiera algo sobre su conjunto de entrenamiento. Incluso una estructura intermedia aparentemente privada puede filtrar información si se consulta repetidamente o se combina con conocimiento externo.
Por eso, el aprendizaje federado con preservación de privacidad suele combinar varias técnicas, en lugar de depender de una sola. La agregación segura puede impedir que el coordinador vea las actualizaciones individuales, pero por sí sola no garantiza que el modelo final no revele información. La privacidad diferencial añade un límite formal al efecto que los datos de una persona o de un grupo pueden tener sobre un resultado publicado, pero el coste en utilidad depende de la carga de trabajo, el volumen de datos, el diseño del muestreo y el presupuesto de privacidad. Los TEE pueden proteger el código y los datos mientras están dentro de un enclave, pero no hacen desaparecer las vulnerabilidades del hardware, los canales laterales, los errores de implementación, los fallos de gestión de claves ni una carga de trabajo demasiado permisiva.
El anuncio de Google es significativo porque intenta conectar esas capas. El TEE controla la ejecución y la liberación de claves. La política y el registro de transparencia proporcionan un rastro auditable. La privacidad diferencial limita los pesos del modelo que se publican. Las compilaciones reproducibles ofrecen una vía para comparar el código fuente con los binarios desplegados. El diseño busca reducir la confianza depositada en el operador y, al mismo tiempo, hacer visibles las suposiciones que permanecen.
La salvedad importa. Google describe las garantías de los TEE como sujetas a las limitaciones de la generación actual. La empresa también dice que la lógica relevante para la privacidad debe permanecer codificada de forma fija en el programa de entrenamiento de Python cuando las arquitecturas propietarias del modelo o los detalles de preprocesamiento se cargan dinámicamente. Eso crea un límite que los auditores deben entender: no todos los parámetros o componentes de una carga de producción tienen necesariamente el mismo nivel de revisión que el mecanismo de privacidad.
El cambio útil: de confiar en el servidor a verificar la carga de trabajo
La contratación tradicional de IA alojada suele preguntar dónde almacena los datos el proveedor, cuánto tiempo conserva los mensajes, si utiliza el contenido del cliente para entrenar modelos y qué administradores pueden acceder al entorno. Esas preguntas siguen siendo necesarias. No bastan cuando un servicio calcula sobre datos cifrados o distribuidos.
Una revisión más exigente pregunta qué cosas el servicio tiene técnicamente prohibido hacer. Por ejemplo:
- ¿Qué programas exactos están autorizados para descifrar y procesar los datos?
- ¿Puede el cliente o un auditor independiente verificar la identidad de la carga antes de que se libere la clave?
- ¿La política de autorización es inmutable durante una ejecución de entrenamiento o un operador privilegiado puede cambiarla después?
- ¿Los cambios de política se escriben en un registro público o visible para el cliente?
- ¿Los binarios de entrenamiento se compilan de forma reproducible a partir de código fuente que los revisores puedan inspeccionar?
- ¿Qué información se publica en cada etapa: actualizaciones individuales, actualizaciones agregadas, métricas, puntos de control, embeddings o solo un modelo final?
- ¿Qué contabilidad de privacidad diferencial se utiliza y cubre las publicaciones repetidas a lo largo del tiempo?
- ¿Qué ocurre cuando falla un trabajador, se restaura una instantánea de recuperación o se revierte el modelo?
Son preguntas operativas, no adornos teóricos. Un sistema que las responde con precisión resulta más fácil de gobernar porque sus afirmaciones pueden contrastarse con artefactos: binarios firmados, registros de atestación, registros de liberación de claves, libros contables de privacidad, repositorios de código fuente y procedimientos de incidentes. Un sistema que solo ofrece una garantía general de confidencialidad deja al cliente dependiendo del proceso interno del proveedor.
El diseño de Google utiliza Rekor para el registro de transparencia y afirma que el KMS y los binarios de procesamiento de datos pueden compilarse de forma reproducible a partir de código abierto del repositorio Confidential Federated Compute. Eso no equivale a una auditoría independiente de cada despliegue, pero ofrece a los revisores algo más útil que un párrafo de política: una vía para inspeccionar las cargas permitidas y comparar la implementación con el diseño declarado.
La distinción se parece a la diferencia entre una base de datos cifrada y una política verificable de acceso a los datos. El cifrado protege el contenido en determinados estados. Una política explica quién puede acceder a él y con qué finalidad. La verificación permite que otra parte compruebe si el sistema respeta esa política. La ingeniería de privacidad madura necesita las tres cosas.
El beneficio práctico de devolver el cálculo al servidor
La parte más contraintuitiva del anuncio de Google es que unas garantías de privacidad más fuertes pueden llegar junto con un mayor cálculo del lado del servidor. Los sistemas federados anteriores dependían mucho de la disponibilidad de los dispositivos, la capacidad local, las condiciones de red y la competencia con otras cargas de trabajo. Si un conjunto útil de dispositivos no estaba disponible, las rondas de entrenamiento podían tardar más o producir resultados más débiles.
Google afirma que algunos modelos federados anteriores de Gboard tardaban entre uno y dos meses en entrenarse. Su nueva arquitectura primero recopila cargas cifradas y después elige un calendario de participación del lado del servidor dentro de la carga protegida. Así, el sistema puede optimizar la selección de dispositivos y los parámetros de privacidad diferencial después de observar la disponibilidad, en lugar de dejar que el ritmo del entrenamiento lo determine por completo qué teléfonos están conectados en cada momento. Google informa de que el cuello de botella actual es la disponibilidad de recursos de los TEE y no el cálculo en los dispositivos.
Es una compensación de ingeniería relevante. Mantener el cálculo en los extremos puede reducir lo que ve un servicio central, pero también limita el tamaño del modelo, la elección del algoritmo, el consumo energético y la planificación. Trasladar el cálculo a un entorno de servidor protegido puede hacer que el entrenamiento sea más predecible y permitir potencialmente modelos mayores. El argumento de privacidad depende de la protección que rodea ese entorno: atestación, liberación de claves, aplicación de políticas, controles de salida y modelo de amenazas del hardware.
Para una empresa, esto significa que «federado» no debe tratarse como sinónimo de «en el dispositivo». Un sistema de producción puede tener una fase distribuida de recopilación de datos, una fase de transferencia cifrada, una fase de cálculo confidencial en el servidor y una fase de publicación con privacidad diferencial. Cada fase tiene sus propios modos de fallo y su propio perfil de costes.
Qué aporta la privacidad diferencial y qué no
La privacidad diferencial es un marco matemático para cuantificar la pérdida de privacidad. La SP 800-226 de NIST la describe como una forma de razonar sobre cómo afecta a una salida la presencia o ausencia de los datos de una entidad, y advierte también de que las implementaciones reales implican múltiples riesgos y decisiones de diseño.
En términos prácticos, un sistema de entrenamiento con privacidad diferencial limita cuánto pueden influir los datos de un participante en un resultado publicado. Los mecanismos habituales recortan la influencia de las actualizaciones individuales y añaden ruido calibrado. Un presupuesto de privacidad menor suele implicar una garantía formal más fuerte, pero demasiado ruido puede reducir la precisión. La compensación está determinada por el número de participantes, la frecuencia con que se reutilizan los datos, la unidad de privacidad —registro, usuario, dispositivo u organización— y el número de salidas publicadas.
Este último punto es fácil de pasar por alto. Un modelo puede tener una garantía de privacidad para una ejecución de entrenamiento, mientras que una secuencia de puntos de control, paneles analíticos, experimentos o variantes del modelo consume presupuesto adicional. La organización necesita un libro contable y una política de publicación, no solo un valor de épsilon aislado en un artículo de investigación. También debe indicar de quién se protege la privacidad. La privacidad a nivel de usuario es una afirmación distinta de la privacidad a nivel de evento; proteger una sola pulsación de tecla no equivale a limitar la influencia de todo lo que una persona aportó durante meses.
La privacidad diferencial tampoco resuelve la gobernanza de los datos antes del entrenamiento. No decide si la organización tenía una base legal para recopilar los datos, si informó a las personas sobre su uso, si las etiquetas son justas o si el modelo resultante es seguro para desplegar. No impide automáticamente que una carga autorizada aprenda el objetivo equivocado. Es una restricción sobre la fuga de información en las salidas, no un sustituto de la limitación de finalidad, el control de acceso, las reglas de conservación o un proceso claro de eliminación.
Por tanto, la pregunta correcta para quien compra no es «¿utiliza esto privacidad diferencial?». Es «¿cuál es la unidad de privacidad, cuál es el presupuesto, qué publicaciones lo consumen, quién audita las cuentas y qué pérdida de utilidad se midió en nuestra tarea?».
Dónde ayudan los TEE y dónde permanece la confianza
Un TEE puede reducir la necesidad de confiar en los operadores de la nube con datos en texto claro durante el procesamiento. Eso es valioso en cargas donde el proveedor debe calcular, pero el cliente no quiere que los administradores habituales del host, otros inquilinos o el operador del servicio inspeccionen los datos. La atestación remota puede vincular una decisión de liberación de claves con una identidad de software medida.
Pero un TEE no es una caja mágica de privacidad. Los compradores deberían plantear al menos cinco preguntas de seguimiento.
Primero, ¿qué hardware y firmware entran en el alcance? Los TEE dependen de funciones del procesador, firmware, claves criptográficas y actualizaciones de seguridad del proveedor. El modelo de amenazas puede excluir a ciertos actores privilegiados o asumir que determinados canales laterales no son explotables.
Segundo, ¿qué código se mide y se atestigua? La respuesta debería incluir el entorno operativo, la lógica de gestión de claves, el programa de entrenamiento, las bibliotecas pertinentes y cualquier componente cargado dinámicamente. Si solo se mide un lanzador pequeño mientras la lógica importante de privacidad se obtiene después, la afirmación de atestación puede ser más estrecha de lo que parece.
Tercero, ¿cómo se liberan los secretos? La gestión de claves debe estar vinculada a una carga aprobada y a una política explícita. Un administrador humano que pueda anular esa decisión forma parte del modelo de amenazas, aunque la ruta normal esté limitada criptográficamente.
Cuarto, ¿qué puede inferirse de los metadatos? El momento, la pertenencia a una cohorte, el tamaño de las solicitudes, los patrones de fallo y los calendarios de publicación pueden transmitir información aunque las cargas estén cifradas. Una revisión de privacidad debe cubrir el tráfico y los metadatos operativos visibles para cada participante.
Quinto, ¿qué ocurre durante la respuesta a incidentes? Un host comprometido, una medición revocada, un enclave vulnerable o una cadena de compilación rota requieren una respuesta práctica: detener la liberación de claves, rotarlas, invalidar las cargas, conservar las pruebas y determinar si las salidas publicadas anteriormente siguen siendo confiables. Un sistema que solo es privado cuando nada sale mal no está preparado para usar datos sensibles en producción.
Las orientaciones anteriores de NIST sobre aprendizaje federado con preservación de privacidad muestran el mismo principio desde otro ángulo. En su análisis de la intersección privada de conjuntos y los filtros de Bloom, NIST señala que las técnicas destinadas a alinear datos todavía pueden filtrar información sobre coincidencias, y que unas protecciones más fuertes suelen imponer costes de rendimiento. La recomendación no es rechazar esas técnicas, sino incluir sus filtraciones en el modelo de amenazas y tomar una decisión política explícita sobre si son aceptables.
La fricción de configuración es considerable
Una empresa no puede adoptar esta arquitectura activando un interruptor de privacidad en una API de IA convencional. El trabajo difícil empieza antes de entrenar el modelo.
El equipo debe definir quién es el propietario de los datos, cuál es la unidad de privacidad, cuál es la finalidad permitida, cuáles son los límites de conservación y qué salidas pueden abandonar el entorno protegido. Debe decidir si los clientes cargan ejemplos, gradientes, características u otra representación. Tiene que crear o adoptar una ruta de atestación, un servicio de gestión de claves, un formato de políticas, un registro de transparencia, una cadena de compilación reproducible y un contador de privacidad. También debe probar la recuperación y la revocación, y documentar la relación entre el cálculo confidencial y las obligaciones legales o contractuales.
La superficie de ingeniería es más amplia que un script de entrenamiento. Un despliegue de producción necesita bibliotecas cliente, mecanismos de inscripción y actualización, identidad criptográfica, planificación de cargas, observabilidad que no recopile metadatos sensibles en exceso, controles de la cadena de suministro de software y una forma de comparar el despliegue medido con el código revisado. Las organizaciones que ya operan infraestructura móvil, flotas de dispositivos, clústeres de cálculo confidencial o canalizaciones de datos regulados parten mejor que los equipos que empiezan desde un único cuaderno.
Los costes aparecerán en varios puntos. Los TEE requieren hardware compatible y pueden reducir la capacidad disponible o complicar el acceso a aceleradores. Los servicios de atestación y gestión de claves añaden dependencias operativas. Los registros públicos y las compilaciones reproducibles exigen disciplina de publicación. La privacidad diferencial puede requerir más participantes, más rondas o más datos para alcanzar una precisión aceptable. La auditoría y el trabajo de equipos de ataque pasan a formar parte del coste continuo, no solo del ejercicio previo al lanzamiento.
La arquitectura todavía puede ser más barata que centralizar los datos cuando la centralización crearía una exposición legal, de seguridad o contractual inaceptable. Pero no es automáticamente más barata que el entrenamiento convencional. La comparación correcta es el coste total de un modelo exitoso y conforme: infraestructura, ingeniería, auditorías, pérdida de rendimiento, preparación ante incidentes y valor de conservar acceso a datos que no pueden agruparse en su forma ordinaria.
Quién debería probar este enfoque
Este patrón resulta más prometedor cuando los datos están distribuidos por una razón y la tarea de aprendizaje se beneficia de combinar señales entre participantes. Los ejemplos incluyen personalización en dispositivos, detección de fraude entre organizaciones, investigación clínica en la que las instituciones no pueden compartir registros sin procesar y datos industriales o de campo que permanecen bajo control local.
Es un candidato sólido cuando la principal objeción de la organización al entrenamiento centralizado no es una preferencia del proveedor, sino una exposición concreta: una prohibición contractual, una población sensible, una restricción normativa o una amenaza creíble de actores internos y de infraestructura comprometida. En esas situaciones, la autorización verificable de la carga puede cambiar materialmente la evaluación del riesgo.
También merece consideración cuando el comprador necesita una respuesta defendible para auditores o socios. Un registro de transparencia, una compilación reproducible, un registro de atestación y un libro contable de privacidad crean pruebas que pueden revisarse más adelante. Esas pruebas quizá no resuelvan todas las preguntas, pero mejoran la calidad de la conversación entre ingeniería, seguridad, asuntos legales y propietarios de los datos.
Un piloto pequeño debería comenzar con una tarea cuya unidad de privacidad y métrica de éxito estén claras. La predicción de la siguiente palabra es un ejemplo conveniente porque el sistema puede medir precisión, velocidad de entrenamiento, participación y contabilidad de privacidad en rondas repetidas. Una empresa debería elegir un flujo de trabajo igualmente acotado: un problema de clasificación limitado, un conjunto definido de organizaciones participantes y una cadencia de publicación concreta. El piloto debería comparar el diseño protegido con una referencia convencional e informar sobre utilidad, latencia, coste, filtraciones y carga operativa.
Quién debería esperar
Probablemente un equipo no debería comenzar con esta arquitectura si no tiene un problema de datos distribuidos. Si todos los datos relevantes ya están autorizados para un uso centralizado, una nube privada bien controlada o un entorno de entrenamiento aislado puede ser más sencillo de proteger y explicar. El aprendizaje federado añade coordinación y mecanismos criptográficos; no es una mejora de privacidad por defecto.
Tampoco encaja bien cuando los datos son demasiado escasos o están demasiado desequilibrados para permitir un entrenamiento útil. La privacidad diferencial necesita participación y una contabilidad cuidadosa. Un sistema con pocos colaboradores puede ofrecer una garantía formal y, aun así, producir un modelo demasiado ruidoso, sesgado o inestable para desplegarlo.
Las organizaciones que no pueden operar una cadena de suministro de software, un sistema de gestión de claves o un proceso de respuesta a incidentes deberían evitar tratar un diseño basado en TEE como un atajo. El cálculo confidencial desplaza la responsabilidad; no la elimina. Si el equipo no puede inspeccionar cambios en las cargas, revocar claves, seguir el presupuesto de privacidad o investigar las filtraciones de metadatos, la arquitectura puede crear un fallo más complicado y difícil de gobernar.
Por último, los equipos deben actuar con cautela cuando la salida deseada sea una decisión de alto impacto sobre personas. La protección de la privacidad no aborda la discriminación, la posibilidad de impugnar la decisión, la calidad de los datos ni la necesidad de revisión humana. Un modelo privado todavía puede tomar una decisión injusta.
Lista de comprobación para comprar entrenamiento privado verificable
Antes de contratar cualquier servicio de aprendizaje federado, pide al proveedor que responda por escrito a estas preguntas y que adjunte pruebas siempre que sea posible:
-
¿Qué es exactamente privado? ¿La garantía se refiere a las entradas sin procesar, a las actualizaciones individuales, a las contribuciones a nivel de usuario, al modelo final o a todo lo anterior?
-
¿Cuál es el modelo de amenazas? ¿Incluye al operador del servicio, a los administradores de la nube, a clientes comprometidos, participantes maliciosos, partes que coluden y ataques contra el hardware? ¿Qué ataques quedan explícitamente fuera de alcance?
-
¿Qué se aplica mediante criptografía o hardware? Separa las promesas contractuales de los controles que impiden que un operador lea los datos o cambie una carga de trabajo.
-
¿Cómo funciona la atestación? Solicita los componentes medidos, el procedimiento de verificación, las condiciones de liberación de claves y el proceso de revocación.
-
¿Puede auditarse la lógica de privacidad? Pregunta si pueden inspeccionarse el código fuente, las dependencias, el proceso de compilación, los archivos de política y las mediciones desplegadas.
-
¿Cómo se calcula el presupuesto de privacidad? Confirma la unidad de privacidad, el método de contabilidad, la composición entre publicaciones, las suposiciones de muestreo y el tratamiento de reintentos y recuperaciones.
-
¿Qué sale del entorno protegido? Incluye métricas, puntos de control, embeddings, errores, registros, datos temporales, estadísticas de cohortes y artefactos de soporte.
-
¿Qué revela la participación? Determina si un coordinador u otro participante puede inferir que contribuyó un dispositivo, empleado, organización o grupo de pacientes concreto.
-
¿Qué ocurre cuando el modelo se equivoca? Las pruebas de privacidad y utilidad deberían incluir rendimiento por subgrupo, deriva, resistencia al envenenamiento y un plan de reversión.
-
¿Cuál es el coste a la escala prevista? Calcula la capacidad de TEE, el almacenamiento, la gestión de claves, el registro, el trabajo de auditoría, las actualizaciones de clientes, los reintentos y el coste en precisión de una privacidad más fuerte.
Si un proveedor no puede responder a estas preguntas, el servicio todavía puede servir para experimentar con poco riesgo. No debería tratarse como un control probado para datos sensibles en producción.
La lección más amplia para comprar IA
El anuncio de Google no declara que el hardware confiable haya resuelto el aprendizaje automático privado. Es una señal de que el límite de privacidad se está volviendo más operativo. El valor del sistema está en conectar varios mecanismos: entrada cifrada, liberación restringida de claves, ejecución atestada, políticas auditables, software reproducible, privacidad diferencial y publicación controlada. Si se elimina cualquiera de ellos, la afirmación se vuelve más limitada.
El cambio también modifica lo que deberían medir las empresas. Un proyecto de IA con preservación de privacidad debería informar de algo más que la precisión del modelo y el coste de infraestructura. Debería indicar quién pudo ver qué, qué cargas estaban autorizadas, cuánta información se publicó, cómo cambió el presupuesto de privacidad, cómo se comportó el sistema durante un fallo y qué pruebas puede verificar un revisor independiente.
Es un estándar más exigente que «no entrenamos con tus datos», pero también es más útil. La promesa del aprendizaje distribuido se vuelve creíble cuando el propietario de los datos puede inspeccionar el cálculo permitido, el operador no puede sustituir silenciosamente la carga de trabajo y la salida final lleva documentado un coste de privacidad.
Para quienes compran IA, el consejo inmediato es sencillo: trata el aprendizaje federado como una decisión de diseño de sistemas y de contratación, no como una función del modelo. Empieza por definir la información que debe permanecer protegida, las partes en las que no se debe confiar y las pruebas que necesitará un auditor. Después comprueba si la arquitectura propuesta aplica realmente esos límites. El nuevo despliegue de Gboard de Google muestra que el enfoque puede llevarse a escala de producción. La pregunta más difícil para los demás es si la ganancia de privacidad justifica toda la maquinaria y si la organización está preparada para operarla con honestidad.
Fuentes
- Google Research, «Toward provably private learning from federated data»: https://research.google/blog/toward-provably-private-learning-from-federated-data/
- arXiv, «Toward provably private learning from federated data»: https://arxiv.org/abs/2609.31494
- National Institute of Standards and Technology, «SP 800-226: Guidelines for Evaluating Differential Privacy Guarantees»: https://csrc.nist.gov/pubs/sp/800/226/final
- National Institute of Standards and Technology, «Protecting Model Updates in Privacy-Preserving Federated Learning: Part Two»: https://www.nist.gov/blogs/cybersecurity-insights/protecting-model-updates-privacy-preserving-federated-learning-part-two
Related articles
El becario de investigación automatizado ya llegó. Ahora el cuello de botella es la evidencia
Los agentes de IA ya pueden ejecutar buena parte del trabajo repetitivo de investigación. El desafío decisivo es diseñar procesos que separen la generación de ideas de su validación, registren los fallos y mantengan la decisión final en manos humanas.
AI no reemplaza la experiencia: la convierte en palanca
Los debates sobre LLMs, deuda cognitiva y brecha de productividad muestran una regla práctica: AI crea valor cuando expertos formulan, verifican e integran el trabajo.
Cuando el tiempo de pantalla educativo no es aprendizaje: auditoría para padres de 5 a 12 años
Una guía práctica para valorar aplicaciones y vídeos de aprendizaje por lo que ayudan a hacer después, no por sus insignias, sus minutos registrados ni por la palabra «educativo» en la etiqueta.
Una formulación guiada por IA mantiene estables las partículas de vacunas de ARNm con el calor: la cadena de frío podría volverse menos frágil
Investigadores del MIT emplearon aprendizaje automático con pocos datos para ajustar los aditivos de nanopartículas lipídicas que transportan ARNm. En ratones, una formulación secada al vacío conservó su actividad durante un año a temperatura ambiente o dos meses a 37 °C, pero el resultado aún es preclínico.
Comments
Sign in to comment.
No comments yet.