Detector SynthID Google’a pomaga ustalać pochodzenie, ale nie potwierdza, że materiał jest prawdziwy
Google udostępnił SynthID Detector wszystkim użytkownikom. Narzędzie wykrywa znak wodny z obsługiwanych systemów AI, lecz czysty wynik nie dowodzi, że materiał stworzył człowiek ani że przedstawia autentyczne wydarzenie.
Przekonujące zdjęcie, nagranie wideo lub plik audio niesie dziś ze sobą prosty problem redakcyjny: co dokładnie można o nim udowodnić? Ludzka ocena bywa zawodna. Metadane łatwo znikają. Detector AI może przypisać prawdopodobieństwo, nie wyjaśniając, jakie dowody za nim stoją. Wyszukiwanie obrazem znajdzie kopie, ale nie ustali, kto przygotował pierwszy egzemplarz.
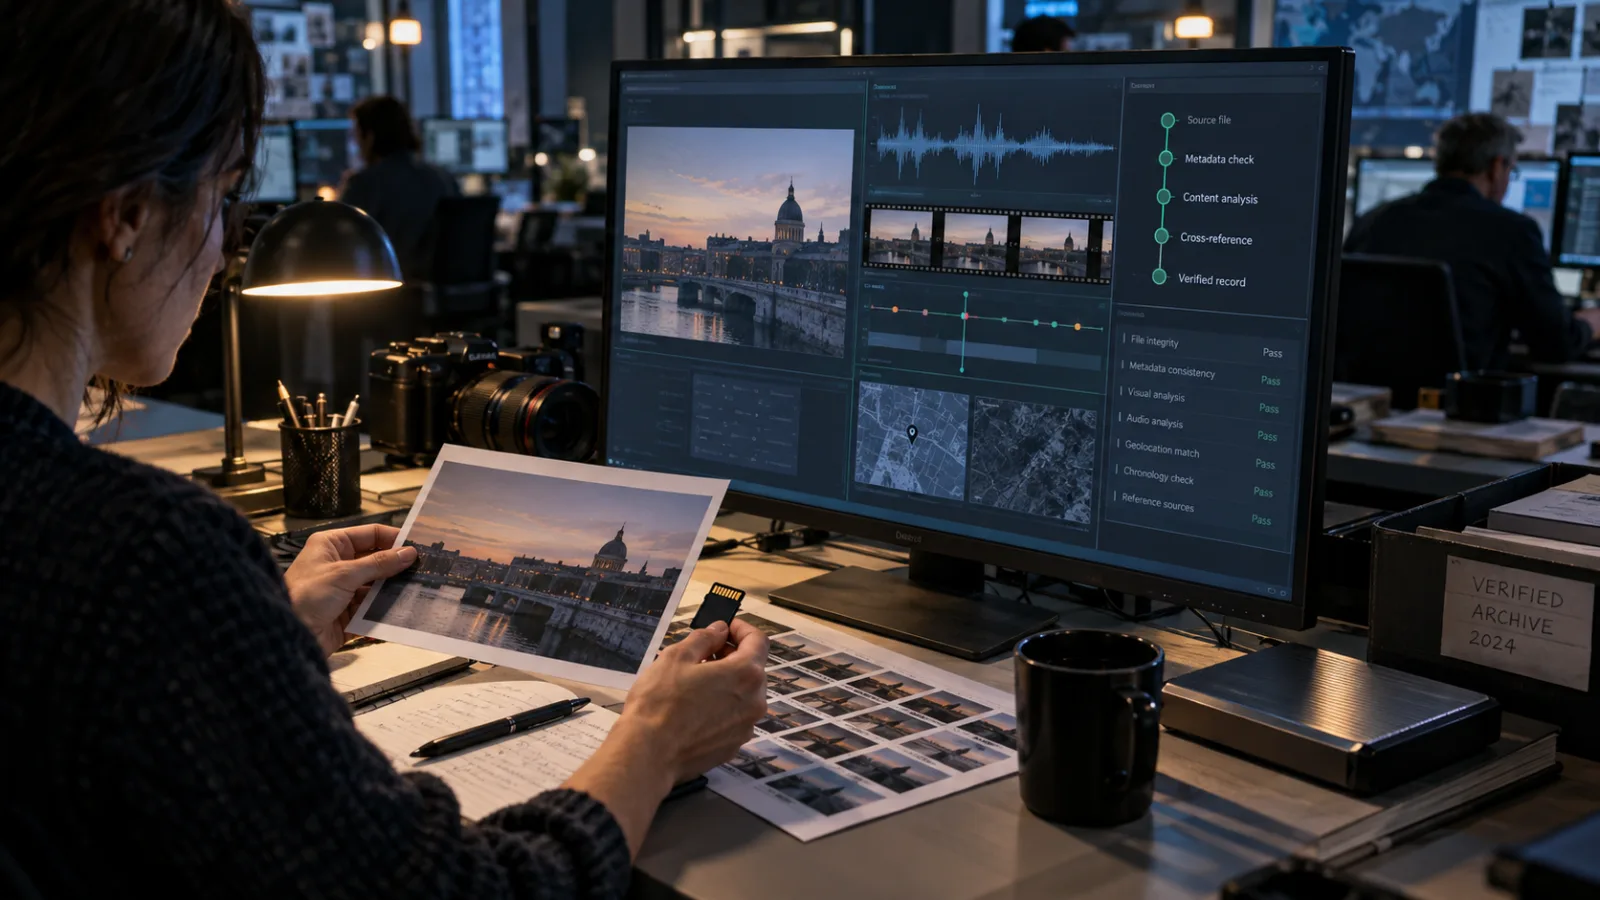
Publiczne udostępnienie SynthID Detector przez Google daje do ręki bardziej konkretny instrument. Każdy może przesłać obraz, wideo lub plik audio i sprawdzić, czy zawiera znak wodny SynthID powiązany z Google albo uczestniczącymi partnerami. Google informuje, że detector jest teraz dostępny globalnie w języku angielskim, po wcześniejszym okresie skierowanym do dziennikarzy, badaczy i specjalistów od mediów. Firma twierdzi także, że sygnały SynthID są wykorzystywane w obsługiwanych materiałach generowanych przez Google, a szerszy ekosystem obejmuje partnerów takich jak OpenAI, NVIDIA i Kakao; wsparcie Apple jest planowane.
To użyteczne, ale nazwa produktu może prowadzić do błędnego wniosku. SynthID Detector nie jest uniwersalnym detektorem AI ani certyfikatem autentyczności. Sprawdza obecność konkretnego sygnału pochodzenia. Wynik pozytywny może ustalić, że obsługiwane systemy AI uczestniczyły w stworzeniu lub edycji całości bądź części pliku. Wynik negatywny może oznaczać tylko, że nie znaleziono obsługiwanego sygnału. Nie dowodzi, że plik stworzył człowiek, że przedstawione wydarzenie rzeczywiście się odbyło, że publikujący jest wiarygodny ani że materiał nie był edytowany poza obsługiwanym łańcuchem.
Dla redakcji, zespołów marketingowych, moderatorów platform i zwykłych użytkowników praktyczna lekcja jest prosta: traktujcie to narzędzie jako jeden punkt kontroli w procesie ustalania pochodzenia. Zachowajcie oryginalny plik, sprawdźcie jego dane uwierzytelniające, zweryfikujcie otaczające go twierdzenie i zapiszcie dokładnie, co detector znalazł. Ważniejszy od zielonej lub czerwonej etykiety jest cały proces.
Co właściwie udostępnił Google
Google opisuje SynthID jako system znakowania wodnego obrazów, dźwięku, tekstu i wideo generowanych przez AI. Znak ma być niewidoczny dla ludzi, ale możliwy do wykrycia przez systemy Google. W przypadku obrazów i wideo Google podaje, że sygnał projektowano tak, aby przetrwał typowe zmiany, między innymi kadrowanie, filtry, zmianę liczby klatek i kompresję stratną. Dla dźwięku firma wymienia odporność na takie operacje jak szum, kompresja MP3 i zmiana prędkości.
Publiczny detector koncentruje się obecnie na przesłanych obrazach, nagraniach wideo i plikach audio. Z opisu Google wynika, że potrafi rozpoznać materiały utworzone przy użyciu Google AI lub systemów partnerów wykorzystujących SynthID. To węższa kwestia niż codzienne pytanie: „Czy ten materiał powstał z użyciem AI?”. Osoba zadająca takie pytanie może mieć na myśli dowolny system generatywny, w tym modele otwarte, prywatne narzędzia albo proces, w którym nigdy nie umieszczono znaku wodnego. SynthID odpowiada na bardziej precyzyjne pytanie: „Czy ten plik zawiera rozpoznawalny sygnał SynthID?”.
To nie jest techniczny przypis bez znaczenia. Rozróżnienie zmienia sposób, w jaki wynik należy opisać w raporcie albo przedstawić klientowi.
Wynik pozytywny uzasadnia sformułowanie: „Plik zawiera znak wodny SynthID powiązany z obsługiwanym procesem generowania lub edycji AI”. Nie uzasadnia natomiast stwierdzeń: „Wydarzenie na nagraniu jest fałszywe”, „Google dowodzi, że to dezinformacja” ani „Cały plik został wygenerowany od zera”. System AI mógł edytować prawdziwe zdjęcie, rozszerzyć nagranie, podmienić tło albo wygenerować wyłącznie warstwę dźwiękową. Sygnał może potwierdzić udział modelu, ale nie rozstrzyga prawdziwości sceny.
Wynik negatywny uzasadnia zdanie: „SynthID Detector nie znalazł obsługiwanego znaku wodnego SynthID w przesłanym pliku”. Nie uzasadnia stwierdzeń: „To materiał stworzony przez człowieka”, „To jest autentyczne” ani nawet „Nie użyto AI”. Znak wodny mógł nigdy nie zostać osadzony. Mógł należeć do systemu, którego detector nie obsługuje. Mógł zostać usunięty lub uszkodzony podczas obróbki. Plik może też być zrzutem ekranu, nagraniem ekranu, eksportem albo pochodną, która nie przenosi już pierwotnego sygnału.
Dokumentacja Google jasno wskazuje tę samą podstawową granicę: weryfikacja działa, gdy odpowiedni znak wodny jest obecny. Brak znaku nie jest uniwersalnym wynikiem negatywnym.
Dwie warstwy pochodzenia, które trzeba rozdzielać
W obecnej debacie często miesza się dwie technologie: znaki wodne i Content Credentials. Rozwiązują powiązane problemy, ale nie dostarczają tego samego rodzaju dowodów.
SynthID jest ukrytym sygnałem osadzonym w treści. Ma pozostać możliwy do wykrycia po wielu zwykłych przekształceniach. Jego główną wartością jest trwałość. Jeśli zwykłe metadane znikną podczas pobierania, zmiany rozmiaru albo przesyłania na platformę, osadzony sygnał może nadal nadawać się do sprawdzenia.
Content Credentials opierają się na otwartym standardzie C2PA. Wykorzystują podpisane informacje o pochodzeniu, aby rejestrować fakty dotyczące źródła zasobu i kolejnych działań wykonanych na pliku. Credential może opisywać użyte oprogramowanie lub urządzenie, edycje oraz relację między bieżącym zasobem a wcześniejszymi wersjami. C2PA określa te zapisy jako kryptograficznie weryfikowalne manifesty powiązane z zasobem.
Różnicę można ująć krótko:
- Znak wodny jest trwałą wskazówką umieszczoną wewnątrz materiału.
- Credential jest podpisanym zapisem historii materiału.
- Weryfikator to narzędzie, które odczytuje jeden z tych sygnałów albo oba.
Żadna z tych warstw nie jest maszyną do ustalania prawdy. Ważny podpis może pokazać, że rozpoznany podpisujący złożył oświadczenie dotyczące zasobu i że oświadczenie nie zostało w odpowiedni sposób zmienione. Nie gwarantuje jednak, że opis wydarzenia podany przez podpisującego jest pełny lub uczciwy. Znak wodny może pokazać, że uczestniczący system generowania dotknął zasobu. Nie powie, czy podpis dołączony do zasobu jest poprawny.
Publiczne wyjaśnienia OpenAI dotyczące prac nad pochodzeniem są tu pomocne, ponieważ wprost opisują podejście warstwowe. OpenAI podaje, że używa metadanych C2PA dla kontekstu i informacji o pochodzeniu, a w obsługiwanych obrazach i plikach audio dodaje SynthID jako trwalszy sygnał, który może pozostać dostępny po usunięciu metadanych. Firma ostrzega także, że żadna metoda wykrywania nie jest niezawodna, a nieznalezienie sygnału nie powinno prowadzić do definitywnego wniosku.
Taki model myślenia jest lepszy niż określenie „detector AI”. Weryfikacja nie jest pojedynczym krokiem klasyfikacji. To zbieranie dowodów przez cały cykl życia pliku.
Praktyczny proces weryfikacji dla wydawców
Zespoły nie potrzebują dużego laboratorium kryminalistycznego, aby korzystać z tych systemów odpowiedzialnie. Potrzebują jednak powtarzalnej procedury przyjęcia materiału. Poniższy proces jest celowo ostrożny, ponieważ koszt błędnego twierdzenia często przewyższa koszt opóźnienia publikacji o kilka minut.
1. Zachowaj przesłany oryginał
W miarę możliwości poproś o oryginalny plik, a nie o zrzut ekranu lub repost pobrany z platformy społecznościowej. Zachowaj nazwę pliku, skrót, czas przesłania, nadawcę i dokładny otrzymany plik. Przygotuj kopię roboczą do zmiany rozmiaru, transkodowania, transkrypcji lub analizy.
Ten krok łatwo pominąć, a później trudno go odtworzyć. Każda konwersja może usunąć metadane albo zmienić plik w sposób wpływający na kolejne kontrole. Jeśli platforma już ponownie skompresowała materiał, odnotuj ten fakt, zamiast przedstawiać pochodną wersję jako źródło.
W wewnętrznej procedurze minimalny użyteczny zapis może wyglądać tak:
asset_id: identyfikator nadany wewnętrznie
received_at: znacznik czasu UTC
received_from: identyfikator osoby lub konta
original_filename: dokładna nazwa pliku
sha256: skrót zachowanego pliku
processing: każda zmiana rozmiaru, kadrowanie, transkodowanie lub eksport
verification_time: znacznik czasu UTC
verification_result: dokładne brzmienie wyniku narzędzia
Nie chodzi o ceremonialną dokumentację. Chodzi o możliwość odtworzenia wyniku, gdy klient, redaktor, regulator albo współpracownik zapyta, co właściwie sprawdzono.
2. Sprawdź Content Credentials przed zmianą pliku
Jeśli oryginał zawiera Content Credentials, sprawdź je przed otwarciem w edytorze, który może je przepisać lub usunąć. Zapisz deklarowanego twórcę, oprogramowanie, urządzenie rejestrujące, edycje i status podpisu. Zwróć uwagę na różnicę między „utworzone przez” a „edytowane przez”. Credential może opisywać łańcuch rozpoczynający się od ujęcia z aparatu, a następnie obejmujący generatywne wypełnianie.
Credential wymaga również decyzji dotyczącej zaufania. Podpis może być kryptograficznie prawidłowy, choć tożsamość lub proces pozostają nieznane. Nazwana aplikacja nie jest tym samym co niezależne potwierdzenie przedstawionego wydarzenia. Pochodzenie mówi, co twierdzi dany łańcuch; dziennikarstwo nadal musi sprawdzić, czy twierdzenie pasuje do historii.
Specyfikacja C2PA ma sprawiać, że takie deklaracje będą widocznie naruszalne i przenośne między narzędziami. Nie zamienia jednak każdego zdania z manifestu w niezależnie potwierdzony fakt. To rozróżnienie powinno znaleźć się zarówno w wytycznych redakcyjnych, jak i w tekstach widocznych dla użytkownika.
3. Uruchom SynthID Detector dla zachowanego materiału
Prześlij oryginał albo najmniej zmienioną dostępną kopię. Wybierz właściwy typ: obraz, wideo lub audio. Zapisz wynik i odnotuj, który plik został przesłany. W przypadku wideo pamiętaj, że znak wodny może być związany tylko z niektórymi klatkami lub fragmentami, podczas gdy publiczny interfejs może podsumować wynik na wyższym poziomie.
Nie uruchamiaj po cichu detektora dopiero po wykadrowaniu logo, konwersji filmu lub usunięciu metadanych, a następnie nie traktuj wyniku tak, jakby pochodził z pliku źródłowego. Zmieniona kopia nadal może być przydatna, ale odpowiada na inne pytanie.
Jeśli wynik wskazuje znak wodny SynthID, zapisz dostawcę lub obsługiwany system wskazany przez narzędzie oraz użyte sformułowanie. Jeśli niczego nie znaleziono, zanotuj: „nie wykryto obsługiwanego sygnału SynthID”, a nie: „to nie jest AI”. Dokładne brzmienie chroni organizację przed stopniowym przekształceniem ograniczonego testu w nieuzasadniony wniosek podczas dalszego obiegu redakcyjnego.
4. Niezależnie sprawdź twierdzenie
Pochodzenie nie jest kontekstem. Syntetyczny obraz może być prawidłowo oznaczony, a mimo to wykorzystany do fałszywego twierdzenia. Prawdziwa fotografia może otrzymać błędną datę, lokalizację lub podpis. Nagranie edytowane przez AI może przedstawiać prawdziwe zdarzenie, ale zawierać mylące zmiany.
Sprawdź historię konta źródłowego, najwcześniejsze dostępne opublikowanie, wskazówki dotyczące lokalizacji i pogody, charakterystyczne punkty oraz lokalne relacje. Poszukaj innych niezależnych nagrań. W audio porównuj głosy i dźwięki tła ze znanym materiałem, ale nie traktuj podobieństwa głosu jako dowodu. W wideo zwracaj uwagę na ciągłość, odbicia, cienie i cięcia, nie przedstawiając samych anomalii wizualnych jako rozstrzygających.
Prawidłowe pytanie brzmi nie tylko: „Czy AI brało udział?”. Trzeba też zapytać: „Co ten plik ma przedstawiać i jakie niezależne dowody wspierają to twierdzenie?”.
5. Nadaj wnioskowi poziom pewności
Zespół może stosować prostą skalę wewnętrzną:
- Znaleziony sygnał pochodzenia: dowód wskazujący, że uczestniczący system AI stworzył lub edytował całość albo część pliku.
- Brak sygnału pochodzenia: w przesłanym pliku nie znaleziono obsługiwanego sygnału; pochodzenie pozostaje nierozstrzygnięte.
- Zweryfikowany kontekst: niezależne dowody potwierdzają deklarowaną datę, miejsce, osoby lub wydarzenie.
- Nierozstrzygnięty kontekst: plik może być prawidłowo przypisany, ale otaczające go twierdzenie nie zostało zweryfikowane.
- Dowody sprzeczne: inne wiarygodne materiały kolidują z podpisem lub zapisem pochodzenia.
Takie rozdzielenie pozwala oddzielić cztery pytania, które często znikają w jednym nagłówku: jakie narzędzie dotknęło materiału, co zawiera plik, co twierdzi podpis i czy wydarzenie rzeczywiście się odbyło.
Co wynik pozytywny może, a czego nie może dowieść
Najmocniejszym zastosowaniem SynthID Detector jest przypisanie udziału obsługiwanego narzędzia. Załóżmy, że zespół marketingowy otrzymuje zdjęcie produktu, które wygląda jak fotografia nowego urządzenia w fizycznym otoczeniu. Wynik pozytywny może uzasadnić ujawnienie, że obraz wygenerował lub edytował Google albo uczestniczący system. Może pomóc zespołowi uniknąć przedstawiania syntetycznej sceny jako zdjęcia. Może też skierować materiał na platformie do innej etykiety lub kolejki kontroli.
Wynik nie odpowiada jednak na kilka ważnych pytań:
- Czy wygenerowano cały obraz, czy edytowano tylko jeden obszar?
- Czy polecenie opierało się na prawdziwym produkcie, czy fikcyjnej koncepcji?
- Czy po wygenerowaniu człowiek wykonał istotne dalsze modyfikacje?
- Czy data lub lokalizacja w podpisie są poprawne?
- Czy obraz narusza prywatność, prawa autorskie albo prawa do wizerunku?
- Czy plik można bezpiecznie wykorzystać w reklamie podlegającej regulacjom?
To samo dotyczy audio i wideo. Znak wodny może wskazać wygenerowaną warstwę głosu lub fragment edytowany przez AI, ale nie ustala, czy mówca wyraził zgodę, czy transkrypcja jest dokładna ani czy nagranie nie było manipulowane w innym miejscu.
Dlatego etykiety powinny precyzyjnie opisywać dowód. „Wygenerowane przez AI” może być zbyt szerokie, jeśli narzędzie potrafi ustalić tylko udział obsługiwanego oprogramowania. Sformułowanie „zawiera znak wodny SynthID powiązany z Google AI” jest mniej efektowne, ale łatwiej go bronić.
Co wynik negatywny może, a czego nie może dowieść
Wyniki negatywne są użyteczne operacyjnie, ale ryzykowne retorycznie. Mogą powiedzieć zespołowi moderacji lub publikacji, że jeden kanał pochodzenia nie przyniósł dopasowania. Może to obniżyć pilność jednego rodzaju kontroli, lecz nie powinno kończyć dochodzenia, gdy treść ma istotne konsekwencje.
Czysty wynik może mieć wiele przyczyn:
- Materiał utworzył system, który nie korzysta z SynthID.
- System używa innego znaku wodnego lub standardu pochodzenia.
- Plik powstał, zanim pojawiła się odpowiednia funkcja znakowania.
- Eksport przez inne oprogramowanie usunął sygnał.
- Platforma dostarczyła pochodną zamiast oryginału.
- Sygnał istnieje, ale nie można go odzyskać z tej wersji.
- Plik jest dziełem człowieka, ale opatrzono go fałszywym podpisem lub wyrwano z kontekstu.
Zespół, który po czystym wyniku SynthID opublikuje „nie wykryto AI”, formułuje twierdzenie znacznie szersze niż zakres testu. Bezpieczniejszy język produktu brzmi: „nie znaleziono obsługiwanego znaku wodnego SynthID”. Jest wystarczająco jasny dla użytkowników i wystarczająco wąski, aby pozostać prawdziwy, nawet gdy zmieni się obsługiwany ekosystem.
Dlaczego zrzuty ekranu i reposty tworzą lukę dowodową
Internet jest pełen materiałów drugiej generacji. Ktoś pobiera wygenerowany obraz, dodaje tekst w narzędziu projektowym, robi zrzut ekranu, przesyła go przez komunikator i publikuje wynik na platformie, która tworzy kolejną pochodną. Na końcu łańcucha widoczna treść może niemal nie różnić się od oryginału, podczas gdy jej odczytywalna maszynowo historia zniknęła.
Znaki wodne projektuje się tak, aby były trwalsze niż zwykłe metadane, ale trwałość nie oznacza nieśmiertelności. Kadrowanie, kompresja, przechwycenie ekranu, kompozycja i wielokrotne przekształcenia mogą wpływać na wykrywanie. Credential C2PA ma inny tryb awarii: może zostać usunięty lub zagubiony, nawet gdy piksele wyglądają tak samo.
Odpowiedzią operacyjną jest zbieranie dowodów możliwie wcześnie. Platformy przyjmujące materiały użytkowników powinny, jeśli to możliwe, sprawdzać przesyłkę przed automatycznymi przekształceniami i zachowywać zarówno oryginał, jak i dostarczoną pochodną. Dla dziennikarzy oznacza to proszenie o pliki źródłowe i dokumentowanie łańcucha przekazania. Dla firm oznacza przechowywanie historii zasobu w systemie zarządzania treścią, zamiast polegania na końcowym pliku JPEG pobranym z folderu kampanii.
Proces pochodzenia powinien zatem zapisywać niepewność, a nie ją usuwać. „Nadawca przekazał skompresowaną kopię; credential nie był dostępny; SynthID nie znalazł obsługiwanego sygnału” jest użytecznym zapisem. „Autentyczne” nim nie jest.
Jak włączyć narzędzie do codziennej pracy
Najlepszym zastosowaniem jest zwykle warstwa wstępnej selekcji, a nie automatyczna bramka publikacji. Wynik detektora może określać, które przypadki wymagają pogłębionej kontroli, ale pojedynczy rezultat rzadko powinien samodzielnie decydować o działaniu o dużym wpływie.
W redakcji proces może wyglądać tak:
- Zachowaj oryginał i poproś o łańcuch źródłowy.
- Sprawdź Content Credentials i uruchom SynthID.
- Porównaj wynik z opisem nadawcy.
- Zweryfikuj wydarzenie poprzez niezależne źródła.
- Dodaj przejrzystą informację o udziale AI, gdy jest to istotne.
- Zachowaj zapis weryfikacji wraz z opublikowanym materiałem.
Zespół marketingowy lub komunikacyjny może rozpocząć wcześniej. Wymagaj od dostawców i pracowników oznaczenia, czy zasób został uchwycony, edytowany, wygenerowany czy złożony z kilku elementów. Gdy ma to znaczenie dla kampanii, przechowuj opis polecenia albo edycji. Sprawdzaj materiały przed skierowaniem ich do płatnej dystrybucji. Nie zakładaj, że wewnętrzna akceptacja marki zastępuje obowiązki informacyjne obowiązujące na konkretnym rynku.
Na platformie detector może wspierać kolejki, a nie pełnić funkcję niewidocznego wyroku. Pozytywny sygnał może uruchomić widoczną etykietę, prośbę o kontekst albo ograniczenie dystrybucji wysokiego ryzyka. Brak sygnału nie powinien automatycznie promować treści ani unieważniać zgłoszeń użytkowników. Polityka platformy nadal potrzebuje odrębnych zasad dotyczących podszywania się, oszustw, zmanipulowanych treści politycznych i intymnych materiałów rozpowszechnianych bez zgody.
Koszt jest głównie proceduralny. Technicznie potrzebne są przede wszystkim miejsce na pliki, haszowanie, kontrola credentiali, dostęp do API lub usługi, jeśli jest dostępny, oraz czas na przegląd. Głównym kosztem organizacyjnym jest uzgodnienie języka przed pojawieniem się spornego przypadku. Takie uzgodnienie jest warte więcej niż zakup kolejnego czarnego pudełka, jeśli pracownicy nadal formułują wnioski, których dowody nie wspierają.
Prywatność i przechowywanie danych
Przesłanie materiału do usługi weryfikacyjnej może ujawnić dane osobowe. Zdjęcie może zawierać twarze, wskazówki lokalizacyjne, dokumenty, prywatne rozmowy albo poufne projekty handlowe. Audio może zawierać głosy i przypadkowe wypowiedzi. Wideo może ujawnić osoby postronne lub aktywność w miejscu pracy.
Zanim detector stanie się częścią rutynowego procesu, ustal, co usługa przechowuje, czy przesłane pliki są wykorzystywane do ulepszania systemu, jak długo dostępne są wyniki, jakie konto jest wymagane i czy wariant dla przedsiębiorstw lub API zmienia te warunki. Przy kontrolach niskiego ryzyka ograniczaj zakres przesyłanych danych, ale nie przycinaj cech potrzebnych do weryfikacji. Dla wrażliwych plików przygotuj zatwierdzoną ścieżkę obsługi i rejestr dostępu.
Nie przesyłaj poufnego materiału źródłowego do niezatwierdzonego zewnętrznego detektora tylko dlatego, że jest bezpłatny. Kontrola pochodzenia jest transferem informacji. Powinna przejść taki sam przegląd prywatności jak każda inna usługa zewnętrznego przetwarzania.
Sam wynik również może być wrażliwy. Twierdzenie, że dziennikarz, pracownik, klient lub organizacja polityczna użyła generatywnej AI, może wpłynąć na reputację albo zatrudnienie. Przechowuj dowód i interpretację razem, ogranicz dostęp i nie ujawniaj surowych danych weryfikacyjnych, jeśli wystarczy węższa informacja publiczna.
Alternatywy i kontrole uzupełniające
SynthID jest najbardziej użyteczny w przypadku materiałów utworzonych przez systemy należące do obsługiwanej sieci. Powinien działać obok innych kontroli, a nie je zastępować.
Przeglądarki zgodne z C2PA i narzędzia Content Credentials mogą ujawnić podpisaną historię tworzenia i edycji. Są szczególnie przydatne, gdy zasób zawiera szczegółowy manifest opisujący działania, a nie tylko zwracający dopasowanie znaku wodnego. OpenAI prowadzi własne prace nad pochodzeniem i weryfikacją obsługiwanych wyników, a jego dokumentacja wyjaśnia związek między credentialami C2PA a sygnałami SynthID.
Wyszukiwanie obrazem nadal pomaga odnaleźć wcześniejsze publikacje i sprzeczne podpisy. Nie dowodzi, że najwcześniejsza zindeksowana kopia jest oryginałem, ale może ujawnić ponownie użyte zdjęcie albo fałszywą lokalizację. Weryfikacja źródła, geolokalizacja, sprawdzanie znaczników czasu oraz bezpośredni kontakt z fotografem lub właścicielem praw pozostają ważne przy istotnych materiałach.
Na ogólne detektory AI należy patrzeć ostrożnie, szczególnie w odniesieniu do tekstu i mocno edytowanych materiałów. Klasyfikator probabilistyczny może być wskazówką, ale jego wynik nie jest zapisem atrybucji. Nie używaj samego wyniku detektora, aby oskarżyć kogoś o oszustwo, odrzucić podanie o pracę, usunąć wpis albo sformułować zarzut prawny.
Im poważniejsze konsekwencje, tym bardziej proces powinien odchodzić od automatycznej klasyfikacji w stronę oceny człowieka i niezależnych dowodów.
Wartością biznesową jest lepsze pochodzenie, nie doskonałe wykrywanie
Udostępnienie SynthID Detector ma znaczenie, ponieważ pochodzenie staje się funkcją widoczną dla użytkownika, a nie niewidocznym standardem omawianym wyłącznie przez zespoły infrastruktury. Google informuje, że zintegrowane funkcje weryfikacji w Search, Gemini i Chrome obsługują obecnie ponad milion zapytań dziennie, a jego systemy oznaczyły znakiem wodnym ponad 180 miliardów obrazów i filmów oraz dużą liczbę plików audio. Są to liczby podane przez firmę, a nie niezależny pomiar dokładności, ale wskazują skalę wdrażania sygnałów pochodzenia.
Możliwość biznesowa nie polega na obietnicy, że każdy syntetyczny plik zostanie wykryty. Taka obietnica jest niemożliwa w otwartym ekosystemie mediów. Użyteczny rezultat jest węższy: ułatwić zachowywanie, sprawdzanie, wyjaśnianie i uwzględnianie obsługiwanego pochodzenia w decyzjach.
Wydawca może ograniczyć błędne oznaczenia. Marka może bardziej konsekwentnie ujawniać generatywne edycje. Platforma może dać moderatorom lepszy dowód. Klient może zrozumieć, dlaczego zasób otrzymał etykietę. Żaden z tych rezultatów nie wymaga udawania, że detector wie, czy scena jest prawdziwa.
Fałszywa pewność również ma koszt. Jeśli użytkownicy nauczą się, że „nie wykryto” oznacza „prawdziwe”, atakujący mogą celować właśnie w materiały pozbawione znaku wodnego. Jeśli wynik pozytywny będzie traktowany jako dowód oszustwa, legalna praca twórcza może zostać błędnie przedstawiona. Systemy pochodzenia budują zaufanie wtedy, gdy jasno określają swoje granice.
Krótka polityka, którą zespoły mogą przyjąć od razu
Wewnętrzna polityka może zmieścić się na jednej stronie:
- Zachowuj oryginalne materiały przed rozpoczęciem obróbki.
- Zapisuj skrót pliku i każdą transformację.
- Sprawdzaj Content Credentials, gdy są dostępne.
- Uruchamiaj SynthID tylko dla określonej wersji pliku.
- Opisuj pozytywne dopasowanie jako obsługiwane pochodzenie AI, a nie dowód fałszywego wydarzenia.
- Opisuj czysty wynik jako brak obsługiwanego sygnału, a nie dowód autorstwa człowieka.
- Niezależnie weryfikuj otaczające twierdzenie.
- Przekazuj sprawy o dużym wpływie wykwalifikowanemu recenzentowi.
- Ograniczaj przesyłanie wrażliwych materiałów i dokumentuj warunki przechowywania.
- Przechowuj zapis weryfikacji razem z opublikowanym lub rozpowszechnianym zasobem.
Ta polityka jest celowo skromna. Nie wymaga, aby każdy redaktor został specjalistą od cyfrowej kryminalistyki. Wymaga zachowania dowodów, używania narzędzi do pytań, na które mogą odpowiedzieć, oraz oddzielenia atrybucji od prawdy.
Co warto wypróbować, a czego lepiej nie robić
Wypróbuj SynthID Detector, gdy masz obraz, film lub plik audio, który mógł powstać w obsługiwanym procesie AI i potrzebujesz szybkiej kontroli pochodzenia. Szczególnie przydatny może być w punktach przyjmowania materiałów, bibliotekach treści, zespołach społecznościowych i redakcjach, które regularnie otrzymują pliki bez jasnej historii powstania. Połącz go ze sprawdzaniem Content Credentials, jeśli plik zawiera podpisany manifest.
Nie traktuj go jako samodzielnego werdyktu autentyczności. Nie używaj czystego wyniku do certyfikowania fotografii, oczyszczania klipu politycznego z podejrzeń, potwierdzania autorstwa człowieka ani rozstrzygania sporu o to, co wydarzyło się w świecie rzeczywistym. Nie przesyłaj wrażliwego materiału bez poznania warunków obsługi usługi. Nie czyn z tego narzędzia jedynej kontroli w procesie, w którym błędny wniosek mógłby zaszkodzić osobie lub organizacji.
Praktyczna zmiana jest prosta: zanim zapytasz „Czy to jest prawdziwe?”, zapytaj „Jaki sygnał pochodzenia jest obecny?”. Publiczny detector Google’a może pomóc odpowiedzieć na pierwsze z tych pytań. Drugie nadal należy do dowodów, kontekstu i ludzkiej oceny.
Źródła i kontekst
W artykule zachowano atrybucję do materiałów Google DeepMind dotyczących SynthID, komunikatów Google o globalnym udostępnieniu identyfikacji treści generowanych przez AI, publikacji OpenAI o pochodzeniu treści, specyfikacji Content Credentials C2PA oraz omówienia TechCrunch dotyczącego publicznego serwisu SynthID. Dane liczbowe dotyczące skali wykorzystania znaków wodnych i zapytań są przedstawione jako informacje podane przez Google, a nie jako niezależnie zweryfikowane pomiary dokładności.
Related articles
Voice is no longer a password: how AI voice fraud changes trust rules
AI voice cloning turns familiar calls into a verification problem for families, finance teams, banks and voice-AI providers.
La voz ya no es una contraseña: cómo el fraude de voz con IA cambia la confianza
La clonación de voz con IA convierte las llamadas familiares en un problema de verificación para hogares, finanzas, bancos y proveedores de voz.
VolAnti lleva la detección acústica de código abierto a los drones FPV de fibra óptica
VolAnti es un detector compacto basado en ESP32-S3 que escucha los armónicos de los rotores en lugar de las emisiones de radio. Su primera prueba resulta prometedora, pero sigue siendo un sistema de alerta transparente, no una solución antidrón terminada.
VolAnti Brings Open-Source Acoustic Detection to Fibre-Optic FPV Drones
VolAnti is a compact ESP32-S3 detector that listens for rotor harmonics instead of radio emissions. Its early test is promising, but the project is best understood as a transparent warning device—not a finished counter-drone system.
Comments
Sign in to comment.
No comments yet.