La remédiation automatique de Cloudflare CASB transforme les constats SaaS en changements de production
Cloudflare CASB peut désormais révoquer automatiquement des partages risqués dans Microsoft 365 et Google Workspace, puis envoyer des webhooks. L’enjeu est de gouverner ce nouveau chemin d’écriture vers les données SaaS.

Cloudflare fait évoluer son CASB : d’un tableau de bord de posture, il devient un système de contrôle automatisé. Le 11 septembre 2026, l’entreprise a détaillé les politiques de remédiation automatique de Cloudflare CASB, une fonctionnalité de Cloudflare One capable d’agir lorsqu’un nouveau constat de sécurité SaaS apparaît. Le premier cas d’usage est familier pour de nombreuses équipes IT et sécurité : un fichier ou un dossier Microsoft 365 ou Google Workspace est partagé trop largement, et la file de sécurité se remplit plus vite que les équipes ne peuvent la traiter.
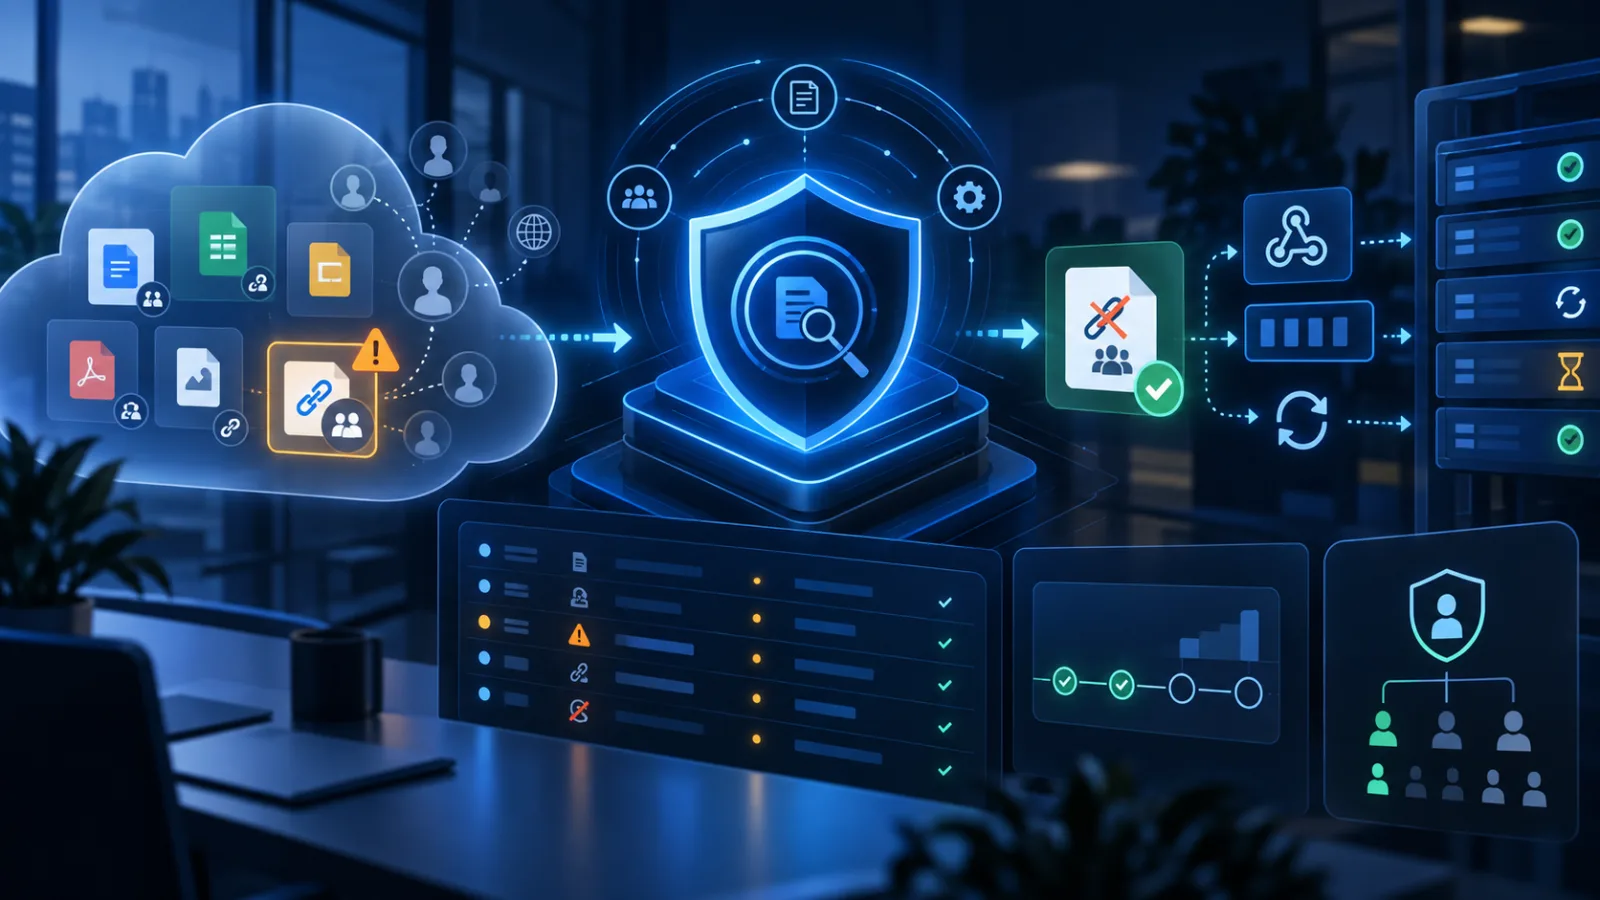
Cette évolution compte parce que la gestion de la posture SaaS est longtemps restée dans une zone inconfortable. Les outils découvrent les fichiers surpartagés, les autorisations OAuth risquées, les clés d’administration dormantes et d’autres problèmes de configuration, mais la correction exige souvent qu’une personne ouvre une autre console, vérifie le propriétaire, détermine si l’exposition est intentionnelle, puis modifie le réglage manuellement. Les politiques Cloudflare CASB raccourcissent ce parcours. Une règle peut correspondre à un constat, révoquer un partage risqué via l’API du fournisseur SaaS et envoyer un webhook vers Slack, Teams, Jira, ServiceNow, Tines ou un point de terminaison personnalisé.
On pourrait y voir une simple histoire d’efficacité. C’est en partie vrai. Pour les responsables IT, l’angle le plus important est toutefois celui de la gouvernance. La remédiation automatique donne à une plateforme de sécurité un accès en écriture à des suites collaboratives qui contiennent des contrats, des feuilles financières, des plans produit, des documents proches du code source et des données clients. Bien conçue, elle réduit la durée d’exposition et transforme le nettoyage répétitif en service contrôlé. Mal encadrée, elle crée un nouveau chemin de changement en production, capable de casser une collaboration légitime ou de dissimuler une erreur de politique derrière une automatisation réussie.
Ce que Cloudflare a annoncé
Cloudflare indique que les politiques CASB sont désormais disponibles dans la zone Cloud and SaaS findings du tableau de bord Cloudflare One. Une politique définit le fournisseur et l’intégration concernés, le type de constat qui la déclenche et l’action à exécuter. L’action peut être une remédiation native, l’envoi d’un webhook, ou les deux.
Le périmètre de la remédiation assurée directement par Cloudflare reste volontairement limité au lancement. Cloudflare précise que l’automatisation couvre actuellement les types de constats liés aux fichiers et aux dossiers de Microsoft 365 et de Google Workspace. En pratique, le système peut utiliser l’API du fournisseur SaaS pour inverser une configuration de partage risquée, par exemple l’accès public à un fichier. La livraison par webhook est plus large : la documentation Cloudflare indique que des webhooks peuvent être envoyés pour les données de constats de posture provenant des intégrations CASB, même lorsqu’une remédiation native n’est pas disponible pour le type concerné.
L’architecture d’exécution intéresse aussi les opérateurs. Cloudflare décrit un pipeline dans lequel le moteur de constats place un message d’orchestration sur Cloudflare Queues. Un Worker vérifie si une politique correspond au constat. Si c’est le cas, une tâche est transmise à un pipeline de remédiation exécuté avec Cloudflare Workflows. Selon Cloudflare, cette conception fournit une exécution durable, la gestion des nouvelles tentatives et un mécanisme de temporisation face aux limites de débit lorsqu’une API tierce ralentit ou rejette les appels. L’entreprise annonce un objectif de cinq minutes ou moins entre la détection et la remédiation terminée.
La fonctionnalité n’est pas rétroactive. La documentation Cloudflare précise que les politiques s’appliquent aux nouvelles instances de constats correspondantes découvertes après la création ou la mise à jour de la politique. Les constats existants doivent être traités séparément. C’est un détail opérationnel important : activer une politique ne videra pas automatiquement un ancien stock, et une absence d’activité dans les journaux de la politique ne prouve pas que le locataire actuel est déjà propre.
Pourquoi il ne s’agit pas d’une simple case CASB supplémentaire
Le changement intéressant n’est pas l’ajout d’un réglage de sécurité SaaS. C’est le rapprochement de la réponse aux mauvaises configurations SaaS avec l’isolement des terminaux, l’application des règles d’identité et l’automatisation de l’infrastructure. Un partage de fichier n’est plus seulement une ligne dans un rapport. Il peut devenir un workflow piloté par événement, avec des privilèges, des journaux, des tentatives répétées et des états d’échec.
Dans beaucoup d’environnements, cette évolution arrive à point nommé. Microsoft 365 et Google Workspace ne sont plus des outils périphériques : ce sont des magasins de données de travail. Une feuille partagée publiquement pour faciliter un échange peut contenir une prévision commerciale. Un dossier fournisseur peut inclure des identifiants clients. Une feuille de route produit peut être copiée dans une présentation, puis diffusée par un lien qui survit au projet. Le nettoyage par tickets fonctionne lorsque les constats sont rares. Il s’effondre lorsque les plateformes collaboratives produisent des milliers d’événements de partage presque sans friction.
L’exemple donné par Cloudflare est courant : la plupart des employés peuvent être empêchés de partager des fichiers publiquement, tandis que les équipes marketing ou partenaires sont autorisées à travailler avec l’extérieur. Un système SSPM passif peut alors produire une longue file mêlant exceptions acceptables, partages oubliés et véritables expositions. L’automatisation est séduisante parce que certaines catégories de constats sont suffisamment déterministes pour être corrigées rapidement. Si l’organisation a déjà décidé qu’un état de partage public est toujours interdit en dehors d’un groupe ou d’un locataire approuvé, faire répéter cette décision par une personne n’apporte pas beaucoup de valeur.
Le risque est que les politiques de nombreux environnements soient moins nettes. Le partage de fichiers regorge de cas particuliers : espaces de transaction, auditeurs externes, agences, prestataires, documents destinés au conseil d’administration, exports de support, preuves d’incident, ressources publiques et documents temporaires de lancement. Un moteur de remédiation voit le type de constat et le périmètre configuré. Il ne connaît pas automatiquement le contexte métier, sauf si l’organisation l’encode dans la conception des politiques, les exclusions, le routage des workflows et les mécanismes de revue.
Qui est concerné
Le public directement concerné est celui des clients Cloudflare One qui utilisent Cloudflare CASB avec des intégrations Microsoft 365 ou Google Workspace. Les équipes de sécurité qui s’appuient déjà sur CASB pour leurs constats de posture peuvent désormais décider lesquels méritent une action automatique plutôt qu’une remédiation manuelle. Les administrateurs IT entrent eux aussi dans la décision, car l’activation de la remédiation demande des permissions plus larges qu’une analyse passive.
Pour Microsoft 365, la documentation d’intégration Cloudflare distingue les permissions de lecture nécessaires à la visibilité CASB normale et un ensemble distinct de permissions en lecture-écriture pour la remédiation. Elles comprennent des étendues Microsoft Graph à fort impact comme Files.ReadWrite.All, User.ReadWrite.All, Group.ReadWrite.All, Directory.ReadWrite.All, ainsi que d’autres permissions capables d’écrire selon les fonctions de l’intégration. Ces étendues ne sont pas surprenantes : un outil ne peut pas modifier un réglage SaaS sans en avoir le droit. Le point essentiel est que la remédiation doit être traitée comme une intégration privilégiée, et non comme une extension anodine de la supervision.
Pour Google Workspace, la documentation Cloudflare décrit une couverture CASB de Gmail, Google Admin, Calendar, Drive et Gemini for Google Workspace, avec comme prérequis les privilèges d’administration appropriés dans Workspace et Google Cloud. Pour les équipes qui se concentrent sur l’exposition de Google Drive, la question opérationnelle est de savoir si l’intégration possède uniquement les permissions nécessaires à la visibilité ou si elle a été élevée au niveau lecture-écriture requis pour les corrections automatiques.
Le public plus large est constitué de toutes les organisations qui cherchent à réduire le travail répétitif lié à la sécurité SaaS. Même sans utiliser Cloudflare, cette annonce reflète une évolution du marché. Les frontières entre SSPM, CASB, DLP et SOAR deviennent moins nettes. De plus en plus d’outils ne se contenteront pas de détecter la dérive de configuration : ils tenteront de la corriger. Les équipes chargées des achats, de l’architecture sécurité et des opérations IT doivent donc revoir les questions posées avant de connecter un outil à un locataire de production.
Le modèle d’implémentation le plus raisonnable
Le meilleur point de départ n’est pas d’automatiser tous les constats de gravité élevée. Il faut commencer par des constats dont la règle métier est déjà explicite, étroite et peu ambiguë. L’accès public en modification sur des fichiers appartenant à des utilisateurs non exemptés constitue un meilleur premier candidat qu’un scénario nuancé de collaboration externe. Un dossier partagé hors du locataire depuis un service réglementé peut aussi donner lieu à une politique plus propre que tous les partages externes de l’entreprise.
Une première politique solide possède cinq caractéristiques. Elle s’applique à une intégration délimitée. Elle cible un type de constat peu ambigu. Elle a un responsable métier identifié. Elle envoie un webhook vers le même endroit que celui où l’équipe suit ses opérations de sécurité. Elle dispose d’un chemin de retour arrière ou d’exception pour les collaborations légitimes interrompues.
Cloudflare permet d’associer la remédiation à l’envoi d’un webhook. Pour les débuts, cette combinaison devrait être la norme. La remédiation silencieuse est tentante parce qu’elle garde les tableaux de bord propres, mais les opérateurs ont besoin d’une trace visible pendant qu’ils évaluent le taux de faux positifs et l’impact métier. Un webhook vers Jira, ServiceNow ou un outil SOAR peut conserver le contexte : le constat déclencheur, le fichier concerné, la réussite ou l’échec de l’action et la politique exécutée.
Cloudflare expose aussi deux catégories de journaux pour cette fonctionnalité. Les journaux Admin Activity enregistrent les changements de politique, notamment la création, les modifications et la désactivation. Les journaux de politique Cloud and SaaS Security enregistrent les résultats d’exécution, avec le constat, le fichier concerné, la réussite ou l’échec et les détails d’erreur comme les réponses non autorisées ou les limites de débit de l’API du fournisseur. Cette séparation est utile. L’audit de configuration répond à la question de savoir qui a modifié la règle. L’audit d’exécution répond à celle de savoir ce que la règle a fait. Un déploiement mature a besoin des deux.
Le compromis des permissions
La remédiation automatique pose une question directe : est-il plus sûr de donner à un outil de sécurité le droit d’écrire pour corriger des expositions SaaS courantes, ou de laisser les constats attendre dans une file humaine pendant des heures ou des jours ? Il n’existe pas de réponse universelle. La décision dépend de la sensibilité des données, des habitudes de collaboration, des effectifs, de l’historique des incidents et de la confiance accordée à la qualité de la détection.
Une intégration en lecture seule a un rayon d’action réduit. Elle peut alerter, produire des rapports et acheminer les constats, mais elle ne peut pas directement casser un partage ou modifier l’état du locataire. Une intégration de remédiation en lecture-écriture a un rayon d’action plus important et un bénéfice de sécurité plus fort. Elle peut réduire le temps pendant lequel des fichiers sensibles restent exposés. Elle peut aussi appliquer des changements incorrects à vitesse machine si une politique est mal délimitée.
Ce compromis doit apparaître dans la gestion des changements. L’activation des permissions CASB en lecture-écriture doit passer par le même niveau de revue que les autres intégrations SaaS privilégiées. Quel administrateur a approuvé les étendues supplémentaires ? Quel locataire ou quelle unité métier est concerné ? Quels types de constats peuvent être remédiés ? Que se passe-t-il si le jeton d’intégration est révoqué, expiré ou limité par le fournisseur ? Comment les utilisateurs concernés apprendront-ils ce qui s’est produit si l’accès disparaît d’un fichier qu’ils utilisaient ?
La pire forme d’automatisation est suffisamment puissante pour modifier l’état SaaS de production, mais pas assez importante aux yeux de l’organisation pour être documentée. La remédiation CASB doit avoir un responsable, un enregistrement de changement et une revue périodique. Sinon, la file d’attente a simplement été déplacée des personnes vers un ensemble de règles que personne ne consulte jusqu’au jour où elles surprennent quelqu’un.
La place des webhooks
Le volet webhook de l’annonce peut être aussi utile que la remédiation native pour de nombreuses équipes. La documentation Cloudflare indique que CASB envoie une charge JSON contenant les métadonnées de l’événement, les détails du constat, les détails de l’actif et les métadonnées propres au constat. Les équipes peuvent ainsi acheminer les événements de posture vers leurs systèmes existants sans donner directement à Cloudflare l’autorisation de corriger toutes les catégories.
Par exemple, un constat très fiable concernant un fichier public peut déclencher une remédiation native et l’ouverture d’un ticket. Un constat moins certain lié à OAuth ou à une configuration d’administration peut uniquement envoyer un webhook vers une file de triage. Un service sensible peut acheminer tous les constats correspondants vers un workflow SOAR qui enrichit l’événement avec le propriétaire du fichier, les appartenances aux groupes, les étiquettes de données et les accès récents avant de décider d’agir.
Ce modèle par niveaux est plus sain qu’une approche tout ou rien. Utilisez la remédiation native lorsque la règle est claire. Utilisez les webhooks lorsqu’elle demande davantage de contexte. Préférez la revue manuelle lorsque le coût d’une mauvaise correction est élevé. Au fil du temps, les constats qui se résolvent toujours de la même manière pourront passer de la revue à l’automatisation.
Les vérifications à effectuer avant l’activation
Commencez par l’inventaire. Confirmez quelles intégrations Microsoft 365 et Google Workspace existent dans Cloudflare CASB, si elles sont en lecture seule ou en lecture-écriture, et quelles unités métier elles couvrent. Ne supposez pas que le périmètre de l’intégration correspond à celui de l’entreprise. Les grandes organisations ont souvent plusieurs locataires, des domaines issus d’acquisitions, des espaces de travail régionaux et des habitudes d’administration héritées.
Examinez ensuite la taxonomie des constats. La documentation des politiques de remédiation Cloudflare répertorie les constats pris en charge pour Google Workspace et Microsoft 365. Comparez ces types avec le vocabulaire de vos politiques internes. Si la règle interne dit que les fichiers financiers confidentiels ne doivent pas être publics, alors que le constat CASB indique seulement qu’un fichier est accessible publiquement, il faut encore distinguer les documents financiers des ressources marketing publiques. Le chemin du dossier, le groupe du propriétaire, les étiquettes DLP, l’emplacement du lecteur et les métadonnées du fichier peuvent être nécessaires.
Décidez ensuite du style d’action. Pendant la première ou les deux premières semaines, de nombreuses équipes auront intérêt à privilégier le mode webhook seul, ou la remédiation accompagnée d’un webhook, pour des règles étroites. Observez le nombre de déclenchements, les propriétaires des fichiers concernés et la fréquence des demandes de rétablissement d’accès. Si une règle se déclenche constamment sur des comportements légitimes, le problème vient peut-être du processus métier plutôt que de l’automatisation.
Enfin, rédigez la procédure d’exception avant d’activer la première politique. Les utilisateurs doivent disposer d’un chemin clair lorsqu’un partage légitime est révoqué. Les équipes de sécurité doivent pouvoir distinguer un défaut de politique d’une erreur utilisateur. Les équipes IT doivent conserver la trace du caractère temporaire ou permanent de l’exception, ou du fait qu’elle révèle la nécessité de modifier la règle de fond.
Les modes d’échec à prévoir
Le mode d’échec le plus évident est la sur-remédiation : une politique révoque un accès qui aurait dû rester ouvert. Cela peut perturber une revue avec un partenaire, une procédure d’achat ou un livrable client. La réponse n’est pas de renoncer définitivement à l’automatisation. Il faut limiter étroitement les premières politiques et surveiller leurs résultats.
Le mode d’échec plus discret est la sous-remédiation. Une équipe active une politique et suppose que le problème est résolu, alors que les anciens constats restent présents puisque les politiques ne s’appliquent qu’aux nouveaux constats découverts. Une autre variante est la dérive des permissions : l’administrateur SaaS révoque ou modifie les droits de l’intégration, et les remédiations commencent à échouer. La documentation Cloudflare consacrée au dépannage CASB oriente déjà les administrateurs vers la validation des permissions lorsque la remédiation échoue. Cette vérification doit figurer dans les procédures d’exploitation.
Les limites de débit constituent une autre difficulté concrète. Cloudflare indique que Workflows peut mettre une tâche en pause puis la relancer lorsque l’API du fournisseur limite la requête. Cela aide à préserver les tâches, mais ne dispense pas de comprendre le délai réel de correction lors d’un événement important. Si une mauvaise configuration à l’échelle du locataire produit des milliers de constats, l’équipe doit savoir si le nettoyage prendra des minutes, des heures ou plusieurs lots successifs.
Il existe aussi un risque d’échec de l’audit. Si la remédiation réussit mais que les preuves sont dispersées, les équipes conformité peuvent toujours avoir du mal à démontrer ce qui s’est passé. Associez les journaux d’exécution de la politique au ticket ou au dossier d’incident. Un tableau de bord propre n’est pas équivalent à une preuve.
Pourquoi le sujet relève aussi des opérations IT
L’exposition SaaS est souvent présentée comme un problème de sécurité, mais la responsabilité opérationnelle est partagée. Les administrateurs IT gèrent le locataire, les groupes d’identité, les valeurs par défaut de partage et la file de support. Les équipes de sécurité définissent les expositions inacceptables et surveillent le risque. Les équipes métier créent la pression de collaboration qui produit les exceptions. L’automatisation touche les trois.
Les noms et les responsables des politiques ont donc leur importance. Une politique nommée public-share-fix est moins informative qu’une politique qui indique sa cible et son intention, par exemple revoke-public-edit-access-drive-non-exempt-users. Le nom doit rendre l’action compréhensible avant même l’ouverture des détails. La description devrait préciser la règle métier, le responsable, le canal de notification attendu et le contact chargé du retour arrière.
Le déploiement progressif suit la même logique. Activez une politique étroite pour une intégration ou une classe de constats, puis élargissez-la. Comparez les constats déclenchés avec les tickets du support et les plaintes des utilisateurs. Repérez les services où la règle entre en conflit avec le travail réel. Ajustez la politique source, pas seulement la règle CASB. Un moteur de remédiation peut appliquer une décision ; il ne peut pas rendre propre une décision confuse.
Le signal envoyé au marché
Cloudflare n’est pas seul à pousser les produits de sécurité vers l’action automatique. Toute la catégorie subit une pression pour réduire la fatigue liée aux alertes et démontrer une amélioration du délai de remédiation. Ce qui est notable ici, c’est le lien entre les constats de posture SaaS et les changements directs de partage dans les suites bureautiques dominantes. Le sujet concerne la surface de travail quotidienne des employés, et non une couche d’infrastructure spécialisée.
L’annonce s’inscrit aussi dans la stratégie plus large de Cloudflare, qui consiste à bâtir des contrôles de sécurité sur ses propres primitives de plateforme développeur. L’entreprise utilise Queues, Workers et Workflows pour un pipeline d’automatisation de sécurité destiné aux clients. Pour les acheteurs, cette affirmation architecturale compte moins que le contrat opérationnel qu’elle implique : tâches durables, nouvelles tentatives, journaux d’audit et comportement prévisible lorsque les API tierces refusent ou ralentissent les appels. Ce sont ces propriétés que les équipes de sécurité devraient demander à tout fournisseur de remédiation d’expliquer.
Il existe également une conséquence concurrentielle. Un CASB qui se contente de signaler le risque paraît de plus en plus incomplet. Mais un CASB qui remédie sans conception rigoureuse des permissions peut devenir difficile à accepter pour les responsables IT. Les fournisseurs devront rendre l’automatisation compréhensible, réversible et vérifiable. Les clients ont intérêt à privilégier une clarté sobre plutôt que des démonstrations spectaculaires.
Les prochaines étapes concrètes
Pour les clients Cloudflare CASB, la première action doit être une revue, pas l’activation d’un bouton. Identifiez les trois constats SaaS récurrents qui créent une exposition réelle et consomment le plus de temps humain. Pour chacun, demandez-vous si la réponse correcte est toujours la même. Si oui, il peut devenir candidat à la remédiation. Si la réponse dépend du contexte, commencez par le routage et l’enrichissement via webhook.
Créez une politique étroite et associez-la à une notification. Vérifiez que l’intégration possède les permissions lecture-écriture requises et consignez l’identité de la personne qui les a approuvées. Utilisez les journaux de politique pour confirmer que les actions se déroulent comme prévu. Lorsque c’est possible, comparez les résultats avec les journaux d’audit natifs du SaaS. Après une courte période d’observation, décidez s’il faut étendre le périmètre, ajouter un autre type de constat ou conserver la règle telle quelle.
Pour les organisations qui n’utilisent pas Cloudflare, cette annonce peut servir de liste de contrôle pour leurs propres outils. Leur SSPM ou leur CASB peut-il passer du constat à la correction ? Si oui, l’action peut-elle être limitée par locataire, intégration, type de constat et unité métier ? Les événements peuvent-ils rejoindre le système de workflow existant ? Les changements de politique et les actions d’exécution disposent-ils de journaux séparés ? Le fournisseur explique-t-il la gestion des limites de débit et des nouvelles tentatives ? Les changements de permissions sont-ils visibles avant leur approbation ?
La conclusion n’est pas que chaque constat SaaS doit être corrigé automatiquement. La gestion de la posture devient une composante des opérations de production. Dès qu’un outil de sécurité peut modifier l’état d’une collaboration, il doit adopter les mêmes pratiques que celles appliquées depuis longtemps à l’automatisation de l’infrastructure : privilège minimal, déploiement progressif, observabilité, responsabilité, retour arrière et revue périodique.
La nouvelle politique CASB de Cloudflare s’attaque à une difficulté réelle : l’écart entre le moment où l’on sait qu’un fichier est exposé et celui où l’exposition est effectivement fermée. Les équipes qui en tireront le plus de valeur seront celles qui la traiteront comme un service de remédiation contrôlé, et non comme un balai magique chargé de faire disparaître une gouvernance SaaS désordonnée.
Sources
- Introducing automatic remediation policies with Cloudflare CASB — Cloudflare Blog, 11 septembre 2026.
- Automatically remediate Microsoft 365 and Google Workspace findings with API-based CASB remediation policies — Cloudflare Developers Changelog.
- Remediation Policies — documentation Cloudflare One.
- Webhooks — documentation Cloudflare One.
- Microsoft 365 CASB integration — documentation Cloudflare One.
- Google Workspace CASB integration — documentation Cloudflare One.
- See risk, fix risk: introducing Remediation in Cloudflare CASB — Cloudflare Blog, 3 mars 2026.
- Troubleshoot CASB integrations — documentation Cloudflare One.
Related articles
Les factures cloud sont désormais des systèmes de production
Les estimations impossibles d’AWS n’étaient pas des frais réels, mais elles montrent que les alertes de coût appartiennent à la réponse à incident.
AWS corrige des contournements du mode lecture seule dans des serveurs MCP de bases de données : ce que les opérateurs doivent vérifier
Deux avis de sécurité d’AWS montrent une faiblesse récurrente des outils MCP reliés aux bases de données : un filtre sur le texte SQL ne remplace pas une vraie frontière d’autorisation.
L’Agents API d’OpenAI : ce qui change pour les équipes qui construisent des workflows IA de longue durée
L’Agents API d’OpenAI, en bêta publique, réunit le harness de Codex, les sessions persistantes, l’orchestration d’outils, les sous-agents et des environnements gérés ou auto-hébergés. La vraie question concerne leurs limites, votre budget et vos contrôles de données.
Le nouveau cadre californien des audits d’IA change ce que les entreprises doivent documenter dès maintenant
La Californie prépare un écosystème d’évaluation indépendante et un registre des auditeurs d’IA. Pour les entreprises, l’urgence n’est pas de commander un audit demain, mais de rendre leurs systèmes, leurs promesses, leurs données et leurs actions correctives traçables.
Comments
Sign in to comment.
No comments yet.