Cloudflare CASB 自动修复:把 SaaS 安全态势发现转化为生产变更
Cloudflare CASB 现在可以自动撤销 Microsoft 365 和 Google Workspace 中的高风险共享,并发送 Webhook。真正需要讨论的不是要不要开启,而是如何避免这套自动化变成未经审查、能够直接写入 SaaS 数据的生产通道。

Cloudflare 正在把 CASB 从一个态势看板推向自动化控制系统。2026 年 9 月 11 日,该公司公布了 Cloudflare CASB 自动修复策略的细节。Cloudflare CASB 是 Cloudflare One 的一项功能,当新的 SaaS 安全发现出现时,它可以执行预先配置的动作。首个实际用例对许多 IT 和安全团队都很熟悉:Microsoft 365 或 Google Workspace 中的文件、文件夹被分享得过于宽泛,而安全队列产生告警的速度超过了人工清理的速度。
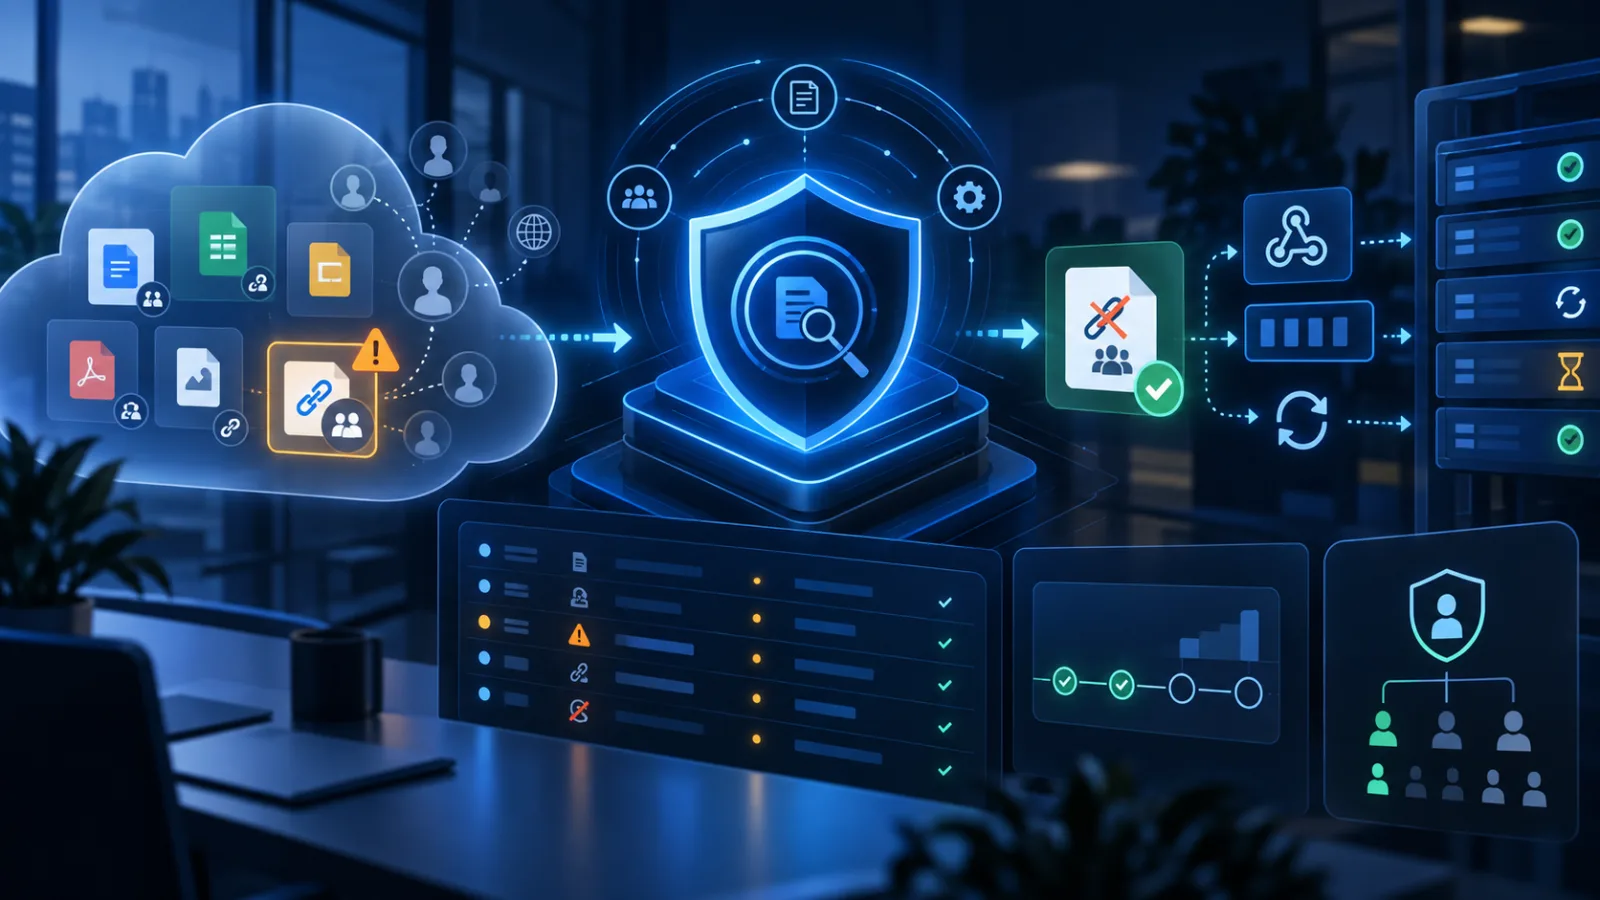
这项变化之所以重要,是因为 SaaS 态势管理一直处在一个尴尬的中间地带。发现工具可以找出过度共享的文件、高风险 OAuth 授权、闲置的管理员密钥以及其他配置问题,但修复往往依赖某个人打开另一个控制台,确认所有者,判断暴露是否有意为之,再手动修改设置。Cloudflare CASB 策略压缩了这条流程:规则可以匹配某项发现,通过 SaaS 提供商 API 撤销高风险共享,并把 Webhook 发送到 Slack、Teams、Jira、ServiceNow、Tines 或自定义端点。
这听起来像是效率提升,确实有这一面。但对 IT 运维人员而言,更重要的角度是治理。自动修复会让安全平台获得对协作套件的写入能力,而这些套件里存放着合同、财务工作簿、产品计划、接近源代码的文档以及客户数据。做得好,它能缩短暴露窗口,把重复性的清理工作变成受控服务;做得松散,则会新增一条生产变更路径,既可能破坏正常协作,也可能让策略错误被“自动化成功”掩盖。
Cloudflare 公布了什么
Cloudflare 表示,CASB 策略现在已经出现在 Cloudflare One 控制台的 Cloud and SaaS findings 区域。策略会定义适用的供应商和集成、触发策略的发现类型,以及应执行的动作。动作可以是原生修复、发送 Webhook,或者同时执行两者。
首发时的第一方修复范围有意保持得比较窄。Cloudflare 表示,自动修复目前覆盖 Microsoft 365 和 Google Workspace 的文件及文件夹发现类型。换句话说,系统可以调用 SaaS 供应商 API,撤销高风险共享配置,例如文件的公开访问权限。Webhook 的覆盖范围更广:Cloudflare 文档说明,即使某种发现类型没有原生修复能力,也可以针对 CASB 集成中的态势发现数据发送 Webhook。
对运维人员来说,后端设计同样值得关注。Cloudflare 描述的流水线是:发现引擎先把编排消息放入 Cloudflare Queues;Worker 判断策略是否匹配该发现;如果匹配,任务就会交给运行在 Cloudflare Workflows 上的修复流水线。Cloudflare 表示,这种设计为任务提供持久执行、重试处理,以及第三方 API 变慢或拒绝请求时的限流退避。公司给出的目标是从发现到完成修复不超过五分钟。
这项功能不是追溯式的。Cloudflare 文档说明,策略只适用于策略创建或更新之后新发现的、符合条件的发现实例。已有发现仍需要单独处理。这是一个很小、却很关键的运维细节:启用策略不会自行清理旧队列,团队也不能把安静的策略日志理解为当前租户已经干净。
为什么它不只是又一个 CASB 复选框
真正有意思的变化,不是 Cloudflare 又增加了一项 SaaS 安全设置,而是 SaaS 错误配置的响应方式正被拉近到端点隔离、身份强制和基础设施自动化的同一套工作方式。文件共享策略不再只是报表上的一行,它可以成为一个由事件驱动、带有权限、日志、重试和失败状态的工作流。
在许多环境中,这种变化已经迟到了。Microsoft 365 和 Google Workspace 早已不是边缘工具,而是工作的数据存储。为了方便而公开分享的电子表格,可能包含销售管线预测;供应商文件夹可能包含客户标识符;产品路线图可能被复制到演示文稿,再通过一个在项目结束后仍然有效的链接分享出去。发现很少时,传统的工单式清理是合理的;当协作平台持续产生大量低摩擦的共享事件时,这种做法就会失效。
Cloudflare 自己举的例子很常见:公司大多数人可能被禁止公开分享文件,但市场团队或合作伙伴团队被允许对外工作。被动式 SSPM 系统会生成很长的队列,其中混杂着可接受的例外、已经过时的共享和真实暴露。自动化有吸引力,是因为某些发现类别足够确定,可以迅速处理。如果组织已经明确规定,某种公开共享状态在获批群组或租户之外一律不允许,那么让人类重复执行这个决定,并不会增加太多价值。
风险在于,许多环境并没有如此干净的策略。文件共享充满边界情况:交易资料室、外部审计、代理机构、承包商、董事会材料、支持导出文件、事件证据、公开资产,以及临时发布文档。修复引擎看到的是发现类型和配置的范围。除非组织通过策略设计、排除规则、工作流路由和复核机制把业务上下文编码进去,否则引擎不会自动知道其中的业务背景。
谁会受到影响
最直接的用户,是使用 Cloudflare CASB 并接入 Microsoft 365 或 Google Workspace 的 Cloudflare One 客户。已经用 CASB 管理态势发现的安全团队,现在可以决定哪些发现值得自动执行,而不是继续手动修复。IT 管理员也会成为决策的一部分,因为启用修复需要的权限比被动扫描更宽。
对于 Microsoft 365,Cloudflare 的集成文档列出了普通 CASB 可见性所需的读取权限,以及修复功能所需的另一组读写权限。其中包括高影响力的 Microsoft Graph 作用域,例如 Files.ReadWrite.All、User.ReadWrite.All、Group.ReadWrite.All、Directory.ReadWrite.All,以及根据集成功能不同而需要的其他可写权限。重点并不是这些作用域出乎意料;工具如果要改变 SaaS 设置,就必须拥有改变设置的权限。重点是,修复型集成应被当作特权集成治理,而不是监控功能的无害延伸。
对于 Google Workspace,Cloudflare 文档描述了覆盖 Gmail、Google Admin、Calendar、Drive 和 Google Workspace Gemini 的 CASB 能力,同时要求具备适当的 Workspace 和 Google Cloud 管理权限。专注于 Google Drive 暴露的团队,需要确认集成是否只拥有可见性所需的权限,还是已经升级到自动修复所需的读写态势权限。
更广泛的受众,是任何试图减少 SaaS 安全重复劳动的组织。即使组织不使用 Cloudflare,这次发布也反映了市场走向。SSPM、CASB、DLP 和 SOAR 之间的边界正在变得模糊。越来越多的工具不只会发现配置漂移,还会尝试纠正它。这会改变采购、安全架构和 IT 运维在把工具接入生产租户前应提出的问题。
一个更稳妥的实施模式
最安全的起点不是把每一条高严重性发现都自动化,而是先选择业务规则已经明确、范围狭窄且不复杂的发现。由非豁免用户拥有的文件如果具有公开编辑权限,是比复杂的外部协作模式更好的首个候选。受监管部门的文件夹如果被分享到了租户之外,也可能比“公司内所有外部共享”更容易制定清晰策略。
一条好的首批策略通常有五个特征:它只适用于边界明确的集成;针对歧义较低的发现类型;有书面记录的业务负责人;把 Webhook 发送到团队现有的安全运营跟踪位置;并且为被意外中断的正常协作提供回滚或例外路径。
Cloudflare 支持把修复与 Webhook 分发组合起来。早期采用时,这种组合应当成为默认方式。静默修复很诱人,因为它能让看板保持整洁,但运维人员需要一条可见的事件轨迹,以便了解误报率和业务影响。发送到 Jira、ServiceNow 或 SOAR 工具的 Webhook 可以保留完整上下文:哪个发现触发了动作、哪个文件受到了影响、动作是否成功,以及运行的是哪条策略。
Cloudflare 还为这项功能提供两类日志。Admin Activity 日志记录策略变更,例如创建、编辑和禁用。Cloud and SaaS Security policy 日志记录运行时结果,包括触发的发现、受影响的文件、成功或失败,以及未授权响应、供应商 API 限流等错误详情。这种拆分很有用:配置审计回答“谁改了规则”,执行审计回答“规则做了什么”。成熟部署需要两者。
权限之间的取舍
自动修复提出了一个直接的问题:给安全工具写入权限,让它修正常见的 SaaS 暴露更安全,还是把发现留在人类队列中数小时甚至数天更安全?没有适用于所有环境的答案。正确选择取决于数据敏感度、协作模式、人员配置、历史事件,以及团队对检测质量的信心。
只读 CASB 集成的爆炸半径较小。它可以告警、报告和路由发现,却不能直接破坏共享关系或改变租户状态。具备读写能力的修复集成爆炸半径更大,同时也带来更强的安全收益:它可以缩短敏感文件保持暴露的时间;但如果策略范围错误,也会以机器速度做出错误变更。
这种取舍应当在变更管理中明确体现。启用读写 CASB 权限,应当经过与其他特权 SaaS 集成相同级别的审查。谁批准了额外作用域?哪些租户或业务单元在范围内?哪些发现类型可以被修复?如果集成令牌被撤销、过期或受到限流,失败模式是什么?如果某个正在使用文件的用户突然失去访问权限,谁会通知他,通知内容是什么?
最糟糕的自动化,是它有足够能力改变生产 SaaS 状态,却没有重要到需要记录。CASB 修复应当有负责人、变更记录和定期复核。否则,组织只是把队列从人转移到了某组规则,而这组规则可能一直被遗忘,直到某次意外让人措手不及。
Webhook 应该放在哪里
对许多团队而言,这次发布中的 Webhook 部分可能和原生修复一样有用。Cloudflare 的 Webhook 文档说明,CASB 会发送包含事件元数据、发现详情、资产详情和特定发现元数据的 JSON 载荷。这意味着团队可以把态势事件接入现有系统,而不必让 Cloudflare 直接拥有修复每一类问题的权限。
例如,高置信度的公开文件发现可以同时执行原生修复并创建工单;置信度较低的 OAuth 或管理员配置发现,则只发送 Webhook 到分诊队列。对敏感部门,可以把所有匹配发现发送到 SOAR 工作流,在决定是否执行动作前,先用文件所有者、群组成员关系、数据标签和最近访问记录补充事件信息。
这种分层方式比把自动化看成全有或全无更健康。规则清楚的地方使用原生修复;需要更多上下文的地方使用 Webhook;错误修复代价很高的地方保留人工复核。随着时间推移,那些反复以同一种方式解决的发现,可以从人工审查逐步升级为自动化。
开启之前要检查什么
先做资产盘点。确认 Cloudflare CASB 中有哪些 Microsoft 365 和 Google Workspace 集成,它们是只读还是读写,以及覆盖哪些业务单元。不要假设集成边界等同于公司边界。大型组织经常存在多个租户、被收购的域名、区域工作区和遗留管理员模式。
然后复核发现分类。Cloudflare 的修复策略文档列出了 Google Workspace 和 Microsoft 365 支持的修复发现。把这些发现类型与内部策略语言逐一对照。如果内部规则说“机密财务文件不得公开”,而 CASB 发现只说明“文件可公开访问”,团队仍然需要一种办法区分财务文件和公开营销材料。文件夹路径、所有者群组、DLP 标签、云端硬盘位置和文件元数据都可能重要。
接着决定动作方式。最初一到两周,许多团队都应当优先考虑仅 Webhook,或者针对狭窄规则采用“修复加 Webhook”。观察有多少发现被触发、受影响文件由谁负责,以及有多少人要求恢复访问。如果某条规则持续对合法行为触发,问题可能在业务流程,而不在自动化本身。
最后,在启用第一条策略前写好例外流程。合法共享被撤销后,用户需要一条清晰的处理路径;安全团队需要办法区分策略错误和用户误操作;IT 团队需要记录例外是临时的、永久的,还是说明底层规则本身需要调整。
需要预先规划的失败模式
最明显的失败模式是过度修复:策略撤销了本应保持开放的访问。这可能打断合作伙伴审查、采购流程或客户交付。解决办法不是永远拒绝自动化,而是把早期策略的范围收窄,并持续监控结果。
更安静的失败模式是修复不足。团队启用策略后以为问题已经解决,却没有注意到旧发现仍然存在,因为策略只适用于新发现。另一种情况是权限漂移:SaaS 管理员撤销或修改了集成权限,修复动作开始失败。Cloudflare 的 CASB 故障排查文档已经建议,在修复失败时验证权限。这项检查应当写进运行手册。
限流也是实际问题。Cloudflare 表示,当供应商 API 对请求进行限流时,Workflows 可以暂停并重试。这有助于保留任务,但并不意味着团队可以不去了解大规模事件中的修复耗时。如果租户范围内的错误配置生成数千条发现,团队应当知道预计清理需要几分钟、几小时,还是要分批完成。
还有一种审计失败。如果修复成功了,但证据散落在不同位置,合规团队仍然可能难以证明发生过什么。应当把策略执行日志与工单或事件记录关联起来。看板干净,不等于证据完整。
为什么这属于 IT 运维,而不只是安全部门
SaaS 暴露经常被描述为安全问题,但运维责任是共享的。IT 管理员负责租户、身份群组、共享默认值和支持队列;安全团队定义不可接受的暴露并监控风险;业务团队产生协作压力,从而形成例外。自动化会同时触及这三方。
因此,策略命名和负责人都很重要。名为 public-share-fix 的策略不如清楚表达目标和意图的名称有用,例如 revoke-public-edit-access-drive-non-exempt-users。在打开详情页之前,名称就应该让人知道会发生什么。描述中应包括业务规则、负责人、预期通知路径和回滚联系人。
分阶段发布也是同理。先为一个集成或一类发现启用范围狭窄的策略,再逐步扩大。把触发的发现与帮助台工单、用户投诉进行对照,寻找规则与真实工作冲突的部门。调整源头策略,而不只是修改 CASB 规则。修复引擎可以执行一个决定,却不能把混乱的决定自动变得合理。
这个发布透露出的市场信号
Cloudflare 并不是唯一一家把安全产品推向自动动作的厂商。整个品类都在承受减少告警疲劳、证明修复时间改善的压力。这里值得注意的是,SaaS 态势发现已经能够连接到主流办公套件中的直接文件共享变更。它触及的是普通员工每天使用的工作面,而不是某个小众基础设施层。
这次发布也符合 Cloudflare 更广泛的策略:用自有开发者平台的基础组件构建安全控制。公司正在使用 Queues、Workers 和 Workflows,搭建面向客户的安全自动化流水线。对买方而言,这些架构名词不如它们所暗示的运维契约重要:任务具有持久性、可以重试、有审计日志,并且在第三方 API 拒绝请求时保持可预测。安全团队应当要求每一家修复供应商解释这些属性。
这也带来竞争层面的影响。只会报告风险的 CASB 越来越显得不完整;但没有谨慎设计权限就直接修复的 CASB,也会让 IT 负责人感到不安。供应商需要让自动化易于理解、可逆并且可审计。客户应当重视朴素而清晰的说明,而不是戏剧化演示。
实际下一步
对于 Cloudflare CASB 客户,第一步应是复核,而不是直接切换开关。找出三项最常出现、确实造成暴露、同时又消耗人工时间的 SaaS 发现。分别问清楚:正确响应是否始终相同。如果答案是肯定的,它可能适合自动修复;如果答案是“有时相同”,就先从 Webhook 路由和事件补充开始。
创建一条范围狭窄的策略,并配套通知。确认集成拥有所需的读写权限,同时记录批准权限的人。用策略日志确认动作确实按照预期发生。在可能的情况下,把结果与 SaaS 原生审计日志进行比对。经过一段较短的观察期后,再决定是扩大范围、增加发现类型,还是保持原状。
对于非 Cloudflare 客户,可以把这次发布当作检查自有工具的一份清单:你的 SSPM 或 CASB 能否从发现走到修复?如果可以,能否按租户、集成、发现类型和业务单元限制动作?能否把事件发送到现有工作流系统?是否把策略变更与运行时动作分开记录?是否说明限流处理和重试方式?在授予权限前,是否清楚展示权限变更的影响?
这并不意味着每一条 SaaS 发现都应该自动修复。真正的变化是,态势管理正在成为生产运维的一部分。一旦安全工具可以改变协作状态,它就需要采用基础设施团队早已用于自动化的习惯:最小权限、分阶段发布、可观测性、明确归属、回滚和定期复核。
Cloudflare 的 CASB 策略发布之所以有用,是因为它直面一个真实痛点:知道文件暴露,与真正关闭暴露之间存在鸿沟。最能从这项功能中获益的团队,会把它当作受控的修复服务,而不是一把可以扫除混乱 SaaS 治理的魔法扫帚。
来源
本文依据以下资料中的事实、背景和产品说明进行改写:
- Introducing automatic remediation policies with Cloudflare CASB(Cloudflare Blog,事实来源,2026-09-11)
- Automatically remediate Microsoft 365 and Google Workspace findings with API-based CASB remediation policies(Cloudflare Developers Changelog,事实来源,2026-08-21)
- Remediation Policies(Cloudflare One 文档,事实来源)
- Webhooks(Cloudflare One 文档,事实来源)
- Microsoft 365 CASB integration(Cloudflare One 文档,背景资料)
- Google Workspace CASB integration(Cloudflare One 文档,背景资料)
- See risk, fix risk: introducing Remediation in Cloudflare CASB(Cloudflare Blog,背景资料,2026-03-03)
- Troubleshoot CASB integrations(Cloudflare One 文档,背景资料)
Related articles
Cloudflare OS 提出了企业 AI 绕不开的问题
这个 agent workspace 更像企业 AI 工作治理的 blueprint:permissions、sandboxes、Gatekeepers、audit logs,以及 app sprawl 风险。
Cloudflare is turning AI bot access into an infrastructure policy
Cloudflare’s new Search, Agent and Training controls show how the web’s old crawler bargain is becoming programmable, payable and more fragile for publishers, SEO teams and AI agent builders.
Cloudflare превращает доступ AI-ботов в инфраструктурную политику
Новые режимы Search, Agent и Training показывают, как старая сделка веба с crawler’ами становится программируемой, платной и более рискованной для издателей, SEO и AI-агентов.
Cloudflare convierte el acceso de bots de IA en política de infraestructura
Los controles Search, Agent y Training muestran cómo el viejo pacto entre la web y los crawlers se vuelve programable, pagable y más delicado para editores, SEO y agentes de IA.
Comments
Sign in to comment.
No comments yet.