EmbeddingGemma 2 hace práctico el buscador multimodal local, pero no es una mejora RAG lista para usar
El modelo abierto de 740 millones de parámetros de Google reúne texto, código, imágenes, vídeo y audio en un espacio de embeddings. La clave es saber en qué flujo de trabajo real un índice local unificado aporta una ventaja medible.
EmbeddingGemma 2 de Google apunta a una pieza de la infraestructura de IA que rara vez recibe atención fuera de los equipos de ingeniería: el modelo de embeddings que decide qué fragmentos de información ve primero un sistema de búsqueda o recuperación. No es un chatbot, un asistente de propósito general ni un sustituto pequeño de un modelo generativo. Convierte texto, código fuente, imágenes, fotogramas de vídeo y audio en vectores que pueden compararse por similitud semántica.
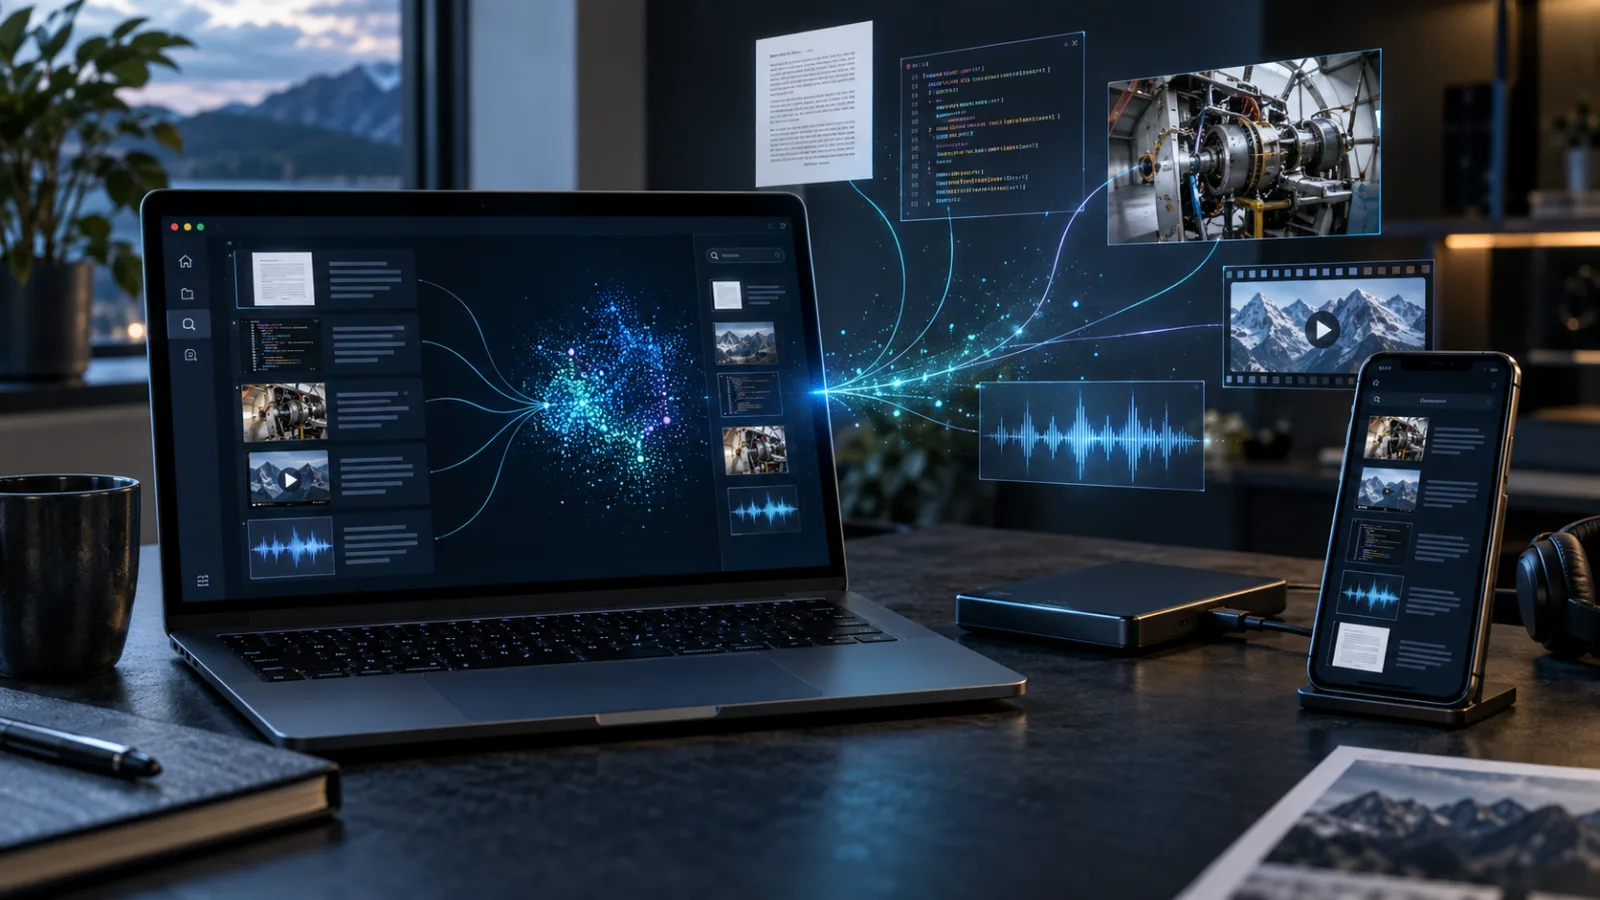
La distinción importa. Un sistema de recuperación solo puede responder bien cuando su búsqueda inicial devuelve el material correcto. Si un equipo tiene documentación, capturas de pantalla, grabaciones, código fuente y clips de producto repartidos entre almacenes distintos, la indexación convencional basada únicamente en texto obliga a pasar cada modalidad por una traducción. Las imágenes deben recibir una descripción, el audio debe transcribirse y el vídeo debe reducirse a fotogramas seleccionados antes de que un modelo de embeddings de texto pueda utilizarlo. EmbeddingGemma 2 intenta eliminar parte de esas traducciones colocando varios tipos de medios en un espacio vectorial compartido de 768 dimensiones.
El modelo fue anunciado el 6 de octubre de 2026 por Google DeepMind y los equipos de Google AI Edge. La documentación oficial lo describe como un modelo abierto de 740 millones de parámetros creado para embeddings multimodales unificados, con variantes modulares que permiten cargar menos que el modelo completo cuando solo se necesitan texto y código. Google afirma que se publica bajo la licencia Apache 2.0 y que puede ejecutarse de forma local y sin conexión en hardware de consumo.
El lanzamiento merece atención porque se dirige a un cuello de botella práctico: la recuperación privada y de baja latencia en dispositivos que no pueden alojar un modelo generativo grande. También conviene abordarlo con cuidado. La tarjeta del modelo, las condiciones de las pruebas, el formato de entrada, las decisiones de cuantización y el diseño del índice determinarán si mejora una aplicación real. Un espacio vectorial compartido es infraestructura útil, no una prueba de que todos los problemas de búsqueda entre modalidades estén resueltos.
Qué cambia en EmbeddingGemma 2
El cambio más importante respecto al primer EmbeddingGemma es el alcance del espacio de entrada. EmbeddingGemma 1 era un modelo ligero de embeddings de texto. EmbeddingGemma 2 extiende la idea a texto, código, imágenes, vídeo y audio, incluidas combinaciones de esas entradas. Una descripción puede compararse con una captura de pantalla, una frase hablada con un fotograma de vídeo o una consulta de código con un archivo fuente relevante sin convertir primero todo a una única representación textual.
La documentación oficial del modelo indica que el sistema produce vectores de 768 dimensiones y admite longitudes de contexto de hasta 8.192 tokens para texto y código fuente. El anuncio de Google describe una arquitectura modular que va desde una configuración de 270 millones de parámetros para texto y código hasta el modelo multimodal completo de 740 millones. Esa diferencia importa más que la cifra principal de parámetros. Un desarrollador que construye una herramienta local de búsqueda de código no necesita necesariamente tener en memoria los componentes de imagen, vídeo y audio. Una biblioteca multimedia tampoco puede suponer que el tamaño del modelo de solo texto describa el tiempo de ejecución multimodal completo.
El modelo también admite Matryoshka Representation Learning, o MRL. En la práctica, la salida puede truncarse a dimensiones menores, como 128, 256 o 512, en lugar de almacenar siempre los 768 valores. Esto puede reducir el almacenamiento de la base vectorial y el coste de calcular distancias, aunque el intercambio de calidad debe medirse con los datos de la propia aplicación. Un vector más pequeño no es automáticamente un vector mejor, y la dimensión óptima depende de los requisitos de recuperación, el tipo de índice y la distribución del corpus.
Google informa de una mejora sustancial frente al primer modelo en el benchmark Code MTEB: pasa de 68,76 a 78,68 según su anuncio. Es una señal útil para la búsqueda de código, pero no debe interpretarse como una clasificación universal de todas las cargas de trabajo de recuperación posibles. Las mejoras en conjuntos de datos seleccionados no indican si el gestor de incidencias, el monorepo, las capturas de pantalla o las grabaciones de soporte de un equipo devolverán las evidencias correctas.
El lanzamiento conserva además el énfasis en el dispositivo del modelo original. Google informa de que los pesos cuantizados de solo texto pueden utilizar unos 191 MB de RAM activa en un Pixel 11 Pro, mientras que el modelo multimodal completo usa unos 567 MB en la misma configuración de referencia. Son cifras atractivas para aplicaciones móviles y de borde, pero corresponden a un dispositivo, un tiempo de ejecución y una configuración de cuantización concretos. Deben tratarse como números para planificar, no como una promesa aplicable a cualquier CPU, GPU, NPU o navegador.
Por qué resulta útil un espacio de embeddings compartido
La mayoría de los sistemas de recuperación todavía se ensamblan como una cadena de componentes especializados. Los documentos pasan por un embedder de texto. Las imágenes se describen o se incorporan por separado. El audio se transcribe. El vídeo se muestrea en fotogramas que después se describen o se convierten en embeddings. La búsqueda se queda dentro de una modalidad o depende de un sistema de segunda etapa que conecte resultados procedentes de índices diferentes. Esta arquitectura puede funcionar bien, pero añade latencia, más puntos de fallo y más decisiones sobre qué información es seguro descartar.
Un espacio de embeddings unificado cambia la primera pregunta: deja de ser «¿cómo traducimos este medio a texto?» y pasa a ser «¿qué está semánticamente cerca de esta consulta, independientemente de su formato original?». Pensemos en una aplicación para servicio técnico de campo. Un técnico puede buscar una descripción hablada de una avería y esperar encontrar un manual de mantenimiento, una fotografía de un componente dañado y un vídeo corto que muestre la reparación. Una canalización solo textual podría hacerlo, pero necesita transcripción, etiquetado de imágenes y una ampliación cuidadosa de la consulta. Un embedder multimodal nativo puede poner esas relaciones a disposición de la canalización antes.
El mismo patrón sirve para los equipos de software. Un repositorio puede contener código fuente, documentación de API, diagramas de arquitectura, grabaciones del terminal y capturas de pantalla de una incidencia. Un desarrollador que pregunta «la pantalla donde aparece el fallo de renovación del token» no está haciendo una pregunta puramente textual. Un modelo que incruste código e imágenes en un espacio común podría permitir que la capa de recuperación encuentre evidencias que un índice textual nunca mostraría.
También existe un argumento de privacidad. Si los embeddings pueden generarse localmente, un dispositivo no necesita subir fotografías personales, conversaciones grabadas o documentos internos a un servicio de indexación alojado solo para hacerlos buscables. La ejecución sin conexión puede reducir la exposición y mejorar la respuesta en entornos con mala conectividad. Eso no vuelve privada a toda la aplicación: los registros, la analítica, la sincronización, las descargas del modelo y el modelo generativo utilizado después de la recuperación requieren revisiones separadas.
Por tanto, el lanzamiento trata menos de «IA en un teléfono» como eslogan que de acercar a los datos una pieza concreta de infraestructura. Un índice local puede sostener interacciones de búsqueda mientras se escribe, recuperación privada de documentos, organización de medios y enrutamiento zero-shot sin un viaje de ida y vuelta a una API de embeddings. Son ganancias concretas cuando el dispositivo, el tiempo de ejecución y el corpus encajan en el margen operativo del modelo.
El modelo es lo bastante pequeño para probarlo, no necesariamente para cualquier producto
Un modelo de 740 millones de parámetros es compacto frente a un modelo generativo moderno, pero no es inmaterial. Los desarrolladores deben contar los archivos del modelo, el tokenizador y el código del procesador, la memoria temporal de activaciones, el índice vectorial, la propia aplicación y cualquier reranker o modelo lingüístico posterior. Las entradas multimodales también tienen costes muy distintos. Una consulta de texto, una imagen de alta resolución, una grabación de audio larga y una secuencia de fotogramas de vídeo no son unidades de trabajo equivalentes.
El diseño modular ayuda. Las aplicaciones de texto y código pueden usar la configuración más pequeña y evitar distribuir codificadores que no utilizan. Una biblioteca fotográfica puede cargar soporte visual sin activar el audio. Una aplicación que indexe vídeo ocasionalmente puede procesar los fotogramas en una tarea de fondo en lugar de mantener todas las modalidades residentes durante la búsqueda interactiva. Son decisiones arquitectónicas, no simples indicadores de una llamada a la API.
Las cifras de memoria comunicadas resultan más convincentes para los desarrolladores que ya tienen un caso de uso local delimitado. Una herramienta de búsqueda para notas en el teléfono, un catálogo multimedia de escritorio o un asistente de soporte sin conexión pueden medir si unos cientos de megabytes y la latencia de inferencia local son aceptables. Un archivo empresarial grande con millones de documentos quizá siga necesitando una capa de indexación en servidor, procesamiento por lotes, un almacén vectorial distribuido y una política separada para conservar medios originales.
La cuantización añade otra capa de juicio. Puede hacer que el modelo funcione en más dispositivos, pero los cambios en la precisión numérica pueden afectar a la clasificación por similitud. Si la aplicación devuelve solo unos pocos resultados, una pequeña pérdida de recuperación puede hacerse visible de inmediato. Si utiliza un conjunto amplio de candidatos seguido de un reranker potente, la misma pérdida puede ser tolerable. La prueba correcta no es si el modelo cuantizado arranca, sino si el producto final recupera la evidencia correcta a un coste aceptable.
La primera prueba práctica debe medir la recuperación, no una demostración
La demostración más sencilla es la búsqueda entre modalidades: escribir una frase y recuperar una imagen coincidente, o mostrar una imagen y recuperar texto relacionado. Sirve para confirmar que la canalización está conectada, pero dice poco sobre la calidad en producción. Antes de cambiar el índice, el equipo debería construir un conjunto de evaluación pequeño.
Hay que empezar por consultas reales del flujo de trabajo previsto. En un código base, conviene recopilar las búsquedas que hacen los desarrolladores y marcar los archivos que contienen la respuesta. En un archivo de soporte, se pueden muestrear grabaciones, capturas y documentos pertenecientes a la misma incidencia. En una biblioteca personal, es mejor utilizar descripciones naturales que etiquetas escritas por el desarrollador. También deben incluirse negativos difíciles: imágenes visualmente parecidas con significados diferentes, archivos de código que comparten vocabulario pero implementan comportamientos distintos y grabaciones cuya transcripción contiene las palabras correctas mientras la evidencia relevante solo aparece en el vídeo.
Hay que medir la recuperación en varios puntos de corte, no solo comprobar si el primer resultado parece bueno. La recuperación en 5 o 10 resultados indica si el reranker posterior tiene una oportunidad de recuperar la respuesta. La latencia debe registrarse por separado para la indexación y para las consultas interactivas. También hay que anotar el uso de memoria, el impacto en la batería y el tamaño del índice en los dispositivos reales que importan. Si la aplicación admite varias modalidades, conviene comparar las búsquedas dentro de una modalidad con las búsquedas entre modalidades; un modelo puede ser fuerte recuperando texto y más débil al relacionar imagen con texto o audio con código.
El formato de entrada merece una atención especial. La guía del modelo describe el uso específico por tarea mediante sentence-transformers e identifica el modelo como google/embeddinggemma-2. Los modelos de embeddings suelen distinguir un documento, una consulta, un título y un pasaje mediante prefijos o indicaciones estructuradas. Si el corpus se indexa con una convención y la consulta se codifica con otra, la calidad puede caer sin que aparezca ningún error evidente durante la ejecución. El equipo debería conservar junto a la versión del índice el preprocesamiento exacto, el tratamiento de cada modalidad, la dimensionalidad y la configuración de normalización.
Un experimento mínimo podría comparar cuatro configuraciones: el embedder textual existente, EmbeddingGemma 2 con vectores completos de 768 dimensiones, el mismo modelo con una dimensión MRL reducida y una compilación local cuantizada. El corpus y el conjunto de consultas deben mantenerse constantes. El resultado será más útil que una demostración pulida porque revelará si la capacidad multimodal resuelve una carencia real de recuperación o simplemente añade otro modelo que mantener.
Dónde deberían probarlo primero los desarrolladores
Los candidatos iniciales más sólidos son las aplicaciones donde la información del usuario ya está mezclada entre formatos y donde no resulta conveniente enviarla a una API alojada. Una base de conocimiento local es un ejemplo. Puede indexar Markdown, PDF, capturas de pantalla y notas de voz, y devolver material relacionado sin subir los archivos originales. El sistema seguirá necesitando análisis de documentos, OCR y quizá reconocimiento de voz, pero la etapa de embeddings puede proporcionar una capa común de recuperación cuando esas entradas ya estén disponibles.
Un organizador multimedia de escritorio es otra posibilidad. El usuario puede buscar una fotografía y encontrar notas de texto relacionadas semántica o visualmente, o buscar una frase y localizar imágenes y clips breves. El modelo local resulta especialmente relevante cuando la biblioteca es personal, grande y no debería sincronizarse con la nube. El producto debe aclarar si los embeddings se almacenan localmente, si las miniaturas o los medios originales salen del dispositivo y si algún servicio en segundo plano realiza procesamiento adicional.
Las herramientas para desarrolladores son un área más exigente técnicamente, pero prometedora. Un IDE o un navegador de código podría combinar fragmentos conscientes de símbolos con capturas de incidencias, referencias de diseño y sesiones de pruebas grabadas. La mejora comunicada en código hace razonable probarlo, aunque la recuperación de código tiene restricciones que la similitud semántica genérica no captura. Los nombres, las importaciones, las relaciones de llamadas, los límites entre versiones y los mensajes de error exactos suelen importar más que la similitud conceptual amplia. Un sistema híbrido que combine búsqueda léxica, índices de símbolos y embeddings probablemente sea más seguro que reemplazar toda la búsqueda existente por un único índice vectorial.
El enrutamiento de intenciones en el dispositivo es otro caso mencionado en el material de lanzamiento de Google. En lugar de entrenar un clasificador para cada aplicación pequeña, un desarrollador puede comparar una entrada con un conjunto de etiquetas o descripciones y seleccionar la intención más cercana. Esto resulta atractivo para comandos sin conexión e interfaces sensibles a la privacidad. También exige umbrales conservadores. Una coincidencia de baja confianza debería derivar a una aclaración o a una ruta determinista, no seleccionar en silencio una acción destructiva.
La búsqueda de vídeo puede beneficiarse del espacio compartido, pero es el ámbito donde las suposiciones de coste pueden fallar con mayor rapidez. Una grabación larga debe muestrearse, y el momento útil puede encontrarse entre los fotogramas seleccionados o depender del habla. Incrustar cada fotograma con máxima fidelidad puede crear un índice enorme y una tarea de ingestión costosa. Un sistema práctico puede combinar fragmentos de transcripción, límites de escenas, fotogramas clave seleccionados y metadatos, y utilizar después el modelo multimodal para generar candidatos.
Qué no conviene suponer a partir del lanzamiento
El primer error sería tratar «abierto» como una descripción completa del lanzamiento. Según la documentación de Google, EmbeddingGemma 2 tiene pesos abiertos y licencia Apache 2.0, un punto de partida favorable para desplegarlo y modificarlo. La aplicación sigue heredando obligaciones de sus otras dependencias, del tiempo de ejecución que sirve el modelo, de los conjuntos de datos y del canal de distribución. El equipo debería conservar la licencia del modelo junto a los pesos exactos que distribuya y revisar cualquier término adicional de Gemma o requisito de uso asociado al artefacto elegido.
El segundo error sería suponer que un espacio vectorial compartido vuelve igual de buscables todas las modalidades. La alineación entre modalidades es un objetivo de optimización, no una garantía de calidad idéntica para texto, imágenes, vídeo y audio. Los benchmarks publicados por Google aportan evidencia sobre tareas seleccionadas. No sustituyen un conjunto de evaluación construido con los usuarios, idiomas, estilos de imagen, condiciones de grabación y vocabulario del dominio de la aplicación.
El tercer error sería utilizar los embeddings como frontera de seguridad. Un índice vectorial puede filtrar información mediante inferencia de pertenencia, resultados de vecinos cercanos o copias de seguridad mal protegidas. El almacenamiento local reduce la exposición de red, pero no protege un portátil frente a un proceso comprometido ni frente a un dispositivo desbloqueado. Las aplicaciones sensibles deberían considerar el cifrado en reposo, los controles de acceso, el comportamiento al borrar datos y si los vectores permanecen después de eliminar el archivo original.
El cuarto error sería confundir recuperación con comprensión. EmbeddingGemma 2 puede ayudar a seleccionar evidencias relevantes; no verifica que esas evidencias estén actualizadas, sean autorizadas o resulten seguras para actuar sobre ellas. Un asistente RAG local todavía necesita atribución de fuentes, reglas de vigencia, filtrado de acceso y un modelo generativo instruido para distinguir los hechos recuperados de las conjeturas. Si se recupera la captura equivocada o una ruta de código obsoleta, una respuesta fluida puede hacer que el fallo sea más difícil de detectar.
Alternativas y cómo elegir entre ellas
La comparación adecuada depende de la tarea. Si una aplicación solo necesita búsqueda de texto multilingüe, el EmbeddingGemma original u otro embedder textual consolidado puede ser más barato y más fácil de validar. No hay motivo para pagar la complejidad del soporte multimodal cuando el corpus y las consultas son solo texto. La documentación de Google presenta EmbeddingGemma 1 como una versión anterior separada, no como una obligación de migración para todos los usuarios.
En la búsqueda del lado del servidor, los modelos de embeddings más grandes todavía pueden ganar en calidad o cobertura lingüística, sobre todo cuando la memoria y el acceso a la red no limitan el diseño. Las API alojadas también pueden ser más sencillas desde el punto de vista operativo, aunque introducen preguntas sobre coste, latencia, gobernanza de datos y dependencia del servicio. El equipo debe comparar el rendimiento total del sistema, no solo los benchmarks del modelo: también importan el rendimiento de indexación, la latencia de consulta, el almacenamiento, el comportamiento ante fallos y el mantenimiento.
Las canalizaciones especializadas siguen teniendo sentido cuando una modalidad presenta requisitos propios del dominio. El reconocimiento óptico de caracteres puede ser mejor para extraer texto exacto de documentos. La transcripción de audio puede exponer palabras y marcas de tiempo buscables. Las herramientas de inteligencia de código pueden utilizar analizadores y servidores de lenguaje para comprender símbolos y referencias. EmbeddingGemma 2 puede convivir con esos sistemas como una capa semántica común en lugar de sustituirlos.
Los modelos multimodales abiertos de otras comunidades pueden ofrecer distintos compromisos de tamaño, soporte lingüístico, compatibilidad de tiempo de ejecución o licencia. La pregunta útil no es qué modelo tiene la afirmación de lanzamiento más contundente. Es si puede ejecutarse en el entorno requerido, si su licencia encaja en el producto, si el equipo puede reproducir el preprocesamiento y si sus errores son aceptables para la tarea del usuario.
Un plan de adopción razonable
Para una primera prueba, hay que fijar la revisión exacta del modelo y el tiempo de ejecución. No conviene construir un índice de producción a partir de un artefacto móvil etiquetado como «latest». La configuración de preprocesamiento, la dimensión de salida, la regla de normalización y los ajustes de cuantización deben guardarse en los metadatos del índice. También hay que crear un conjunto de prueba reservado antes de ajustar el umbral de búsqueda.
Después se debe probar un único flujo de trabajo estrecho de principio a fin. Un piloto útil podría consistir en buscar entre unos miles de documentos y capturas internas, o localizar clips de reparación dentro de un conjunto controlado de grabaciones. Si es posible, conviene dejar fuera de la primera medición la capa de respuesta generativa. Primero hay que demostrar que la recuperación devuelve la evidencia correcta. Solo después tiene sentido medir si un asistente posterior produce respuestas mejores.
Hay que comparar las líneas base local y alojada con las mismas consultas. La prueba debe incluir dispositivos lentos, indexación en segundo plano y trabajos interrumpidos. También debe comprobar qué ocurre cuando se elimina un archivo fuente, cuando una actualización del modelo cambia la geometría de los vectores y cuando un usuario busca en un idioma o formato poco representado en el conjunto de evaluación. La reindexación debe tratarse como una operación prevista, no como un desastre excepcional.
Por último, los límites del producto deben ser visibles. Hay que explicar a los usuarios qué datos permanecen en el dispositivo, qué se sincroniza, cuánto tiempo se conservan los embeddings y si se llama a un modelo en línea después de la recuperación. Debe existir una forma de inspeccionar la fuente que sustenta cada resultado. Si el sistema se utiliza para tomar decisiones, conviene exigir confirmación cuando la confianza sea baja o cuando las evidencias recuperadas entren en conflicto. La inferencia local puede mejorar la privacidad y la capacidad de respuesta, pero la transparencia también debe diseñarse.
La importancia más amplia
EmbeddingGemma 2 es un lanzamiento de código abierto interesante porque se centra en el tejido conectivo del software, no en una experiencia de chatbot llamativa. El valor de un modelo de embeddings multimodal solo aparece cuando un producto contiene información que los usuarios necesitan conectar: una pregunta y una captura de pantalla, una frase y una grabación, una función y un informe de incidencia. En esos flujos, un modelo local compacto podría simplificar la indexación y hacer posible la recuperación privada en dispositivos que antes dependían de un servidor.
El lanzamiento no es una razón para sustituir de la noche a la mañana una pila de búsqueda que ya funciona. Su aportación práctica es una opción que se puede probar: una familia de modelos, varios tipos de entrada, ejecución local, pesos abiertos y una huella de despliegue menor que la de muchos sistemas multimodales generales. Esa combinación justifica un piloto acotado, especialmente para búsquedas privadas de medios, bases de conocimiento con formatos mezclados y aplicaciones de borde.
La recomendación es sencilla. Hay que empezar por un corpus en el que la recuperación entre modalidades resuelva un problema visible. Conviene conservar los índices léxicos, estructurales y especializados cuando aporten exactitud. Hay que medir recuperación, latencia, memoria, almacenamiento y comportamiento al borrar datos en hardware real. La licencia y los términos del modelo deben revisarse junto con el resto del árbol de dependencias. Si EmbeddingGemma 2 mejora la evidencia que llega al usuario sin volver más difícil de entender el sistema, merece un lugar en la pila. Si solo produce una demostración más impresionante, la línea base más pequeña y sencilla seguirá siendo la mejor decisión de ingeniería.
Fuentes
- EmbeddingGemma 2 is a best-in-class open model for natively multimodal embeddings — Google.
- Bring multimodal semantic search to the edge with EmbeddingGemma 2 — Google Developers Blog, 6 de octubre de 2026.
- EmbeddingGemma 2: The Developer Guide — Google Developers Blog, 6 de octubre de 2026.
- EmbeddingGemma documentation — Google AI for Developers.
- google/embeddinggemma-2 model repository and model card — Hugging Face.
- EmbeddingGemma 2 model card — Hugging Face.
- Community discussion of EmbeddingGemma 2 release — Reddit.
- Community discussion of local WebGPU usage and embedding details — Reddit.
- Gemma releases — Google AI for Developers.
Comments
Sign in to comment.
No comments yet.