EmbeddingGemma 2 sprawia, że lokalne wyszukiwanie multimodalne staje się praktyczne, ale nie jest gotowym ulepszeniem RAG
EmbeddingGemma 2 umieszcza tekst, kod, obrazy, wideo i dźwięk we wspólnej przestrzeni embeddingów. Najważniejsze pytanie brzmi nie, czy model jest mały, lecz gdzie taki lokalny indeks rzeczywiście usprawni pracę.
EmbeddingGemma 2 firmy Google trafia w część stosu AI, która rzadko interesuje osoby spoza zespołów inżynieryjnych: model embeddingowy decydujący o tym, jakie fragmenty informacji system wyszukiwania lub retrievalu zobaczy jako pierwsze. Nie jest to chatbot, uniwersalny asystent ani mniejszy zamiennik modelu generatywnego. Model zamienia tekst, kod źródłowy, obrazy, klatki wideo i dźwięk na wektory, które można porównywać pod kątem podobieństwa semantycznego.
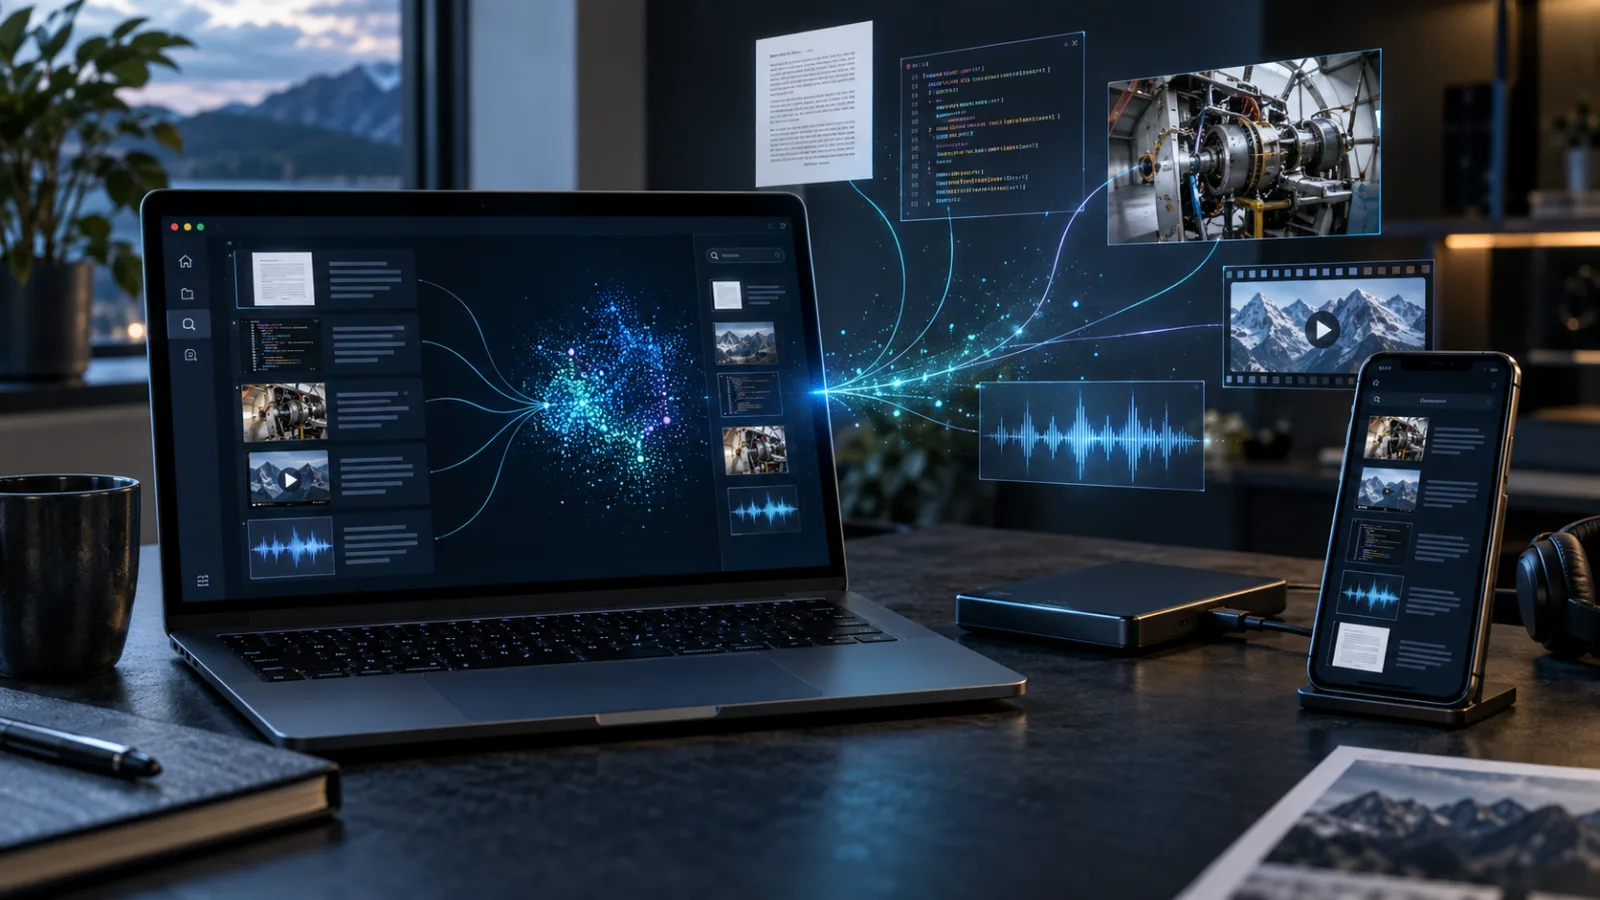
To rozróżnienie ma znaczenie. System retrievalowy może dobrze odpowiadać tylko wtedy, gdy jego wyszukiwanie pierwszego etapu zwróci właściwe materiały. Jeśli dokumentacja, zrzuty ekranu, nagrania, kod źródłowy i klipy produktowe są rozproszone w osobnych magazynach, klasyczne indeksowanie tekstowe zmusza każdą modalność do przejścia przez etap tłumaczenia. Obrazy trzeba opisać, dźwięk transkrybować, a wideo ograniczyć do wybranych klatek, zanim tekstowy model embeddingowy będzie mógł cokolwiek z tym zrobić. EmbeddingGemma 2 ma ograniczyć część tych tłumaczeń, umieszczając wiele typów mediów we wspólnej, 768-wymiarowej przestrzeni wektorowej.
Model został ogłoszony 6 października 2026 roku przez Google DeepMind oraz zespoły Google AI Edge. Oficjalna dokumentacja opisuje go jako otwarty model o 740 milionach parametrów, przeznaczony do tworzenia ujednoliconych embeddingów multimodalnych. Modularne warianty pozwalają ładować mniej niż pełny model, gdy potrzebny jest wyłącznie tekst i kod. Google podaje, że model udostępniono na licencji Apache 2.0 i że może działać lokalnie oraz offline na sprzęcie konsumenckim.
Wydanie zasługuje na uwagę, bo celuje w praktyczne wąskie gardło: prywatny retrieval o małych opóźnieniach na urządzeniach, które nie mogą hostować dużego modelu generatywnego. Trzeba jednak zachować ostrożność. O tym, czy poprawi działanie konkretnej aplikacji, zdecydują karta modelu, warunki benchmarków, formatowanie wejścia, wybór kwantyzacji i projekt indeksu. Wspólna przestrzeń wektorowa jest użyteczną infrastrukturą, ale nie dowodzi, że rozwiązano każdy problem wyszukiwania między modalnościami.
Co zmieniło się w EmbeddingGemma 2
Najważniejsza zmiana względem pierwszego wydania EmbeddingGemma dotyczy zakresu przestrzeni wejściowej. EmbeddingGemma 1 był lekkim modelem embeddingowym dla tekstu. EmbeddingGemma 2 rozszerza tę ideę na tekst, kod, obrazy, wideo i dźwięk, także w kombinacjach tych danych. Opis można porównać ze zrzutem ekranu, wypowiedzianą frazę z klatką wideo, a zapytanie dotyczące kodu z odpowiednim plikiem źródłowym, bez wcześniejszego zamieniania wszystkiego na jedną reprezentację tekstową.
Oficjalna dokumentacja modelu mówi, że system tworzy wektory o 768 wymiarach i obsługuje kontekst do 8192 tokenów dla tekstu oraz kodu źródłowego. W ogłoszeniu Google opisano modularną architekturę obejmującą konfigurację tekstowo-kodową z 270 milionami parametrów oraz pełny, multimodalny model z 740 milionami parametrów. Ta różnica jest ważniejsza niż sama liczba parametrów podana w nagłówku. Deweloper budujący lokalne narzędzie do wyszukiwania kodu nie musi przechowywać w pamięci komponentów obrazu, wideo i dźwięku. Z kolei biblioteka multimediów nie może zakładać, że tekstowy wariant opisze pełne środowisko uruchomieniowe modelu multimodalnego.
Model obsługuje również Matryoshka Representation Learning, czyli MRL. W praktyce wynik można przyciąć do mniejszej liczby wymiarów, na przykład 128, 256 lub 512, zamiast za każdym razem przechowywać wszystkie 768 wartości. Może to ograniczyć koszty przechowywania w bazie wektorowej i obliczania odległości, ale kompromis jakości trzeba zmierzyć na własnych danych aplikacji. Mniejszy wektor nie jest automatycznie lepszym wektorem, a optymalny wymiar zależy od wymaganego recallu, typu indeksu i rozkładu korpusu.
Google podaje znaczną poprawę względem pierwszego modelu w benchmarku Code MTEB: według ogłoszenia wynik wzrósł z 68,76 do 78,68. To użyteczny sygnał dla wyszukiwania kodu, ale nie należy odczytywać go jako uniwersalnego rankingu wszystkich możliwych obciążeń retrievalowych. Wyniki na starannie przygotowanych zbiorach nie mówią zespołowi, czy jego własny tracker zgłoszeń, monorepo, zrzuty ekranu lub nagrania wsparcia technicznego zwrócą właściwe dowody.
Wydanie zachowuje także nacisk na działanie na urządzeniu, obecny w oryginalnym modelu. Google podaje, że skwantyzowane wagi wariantu tekstowego mogą zużywać około 191 MB aktywnej pamięci RAM na Pixelu 11 Pro, a pełny model multimodalny około 567 MB w tej samej konfiguracji referencyjnej. Takie wartości są atrakcyjne dla aplikacji mobilnych i edge, ale są pomiarami wykonanymi na konkretnym urządzeniu, w konkretnym środowisku uruchomieniowym i przy określonej konfiguracji kwantyzacji. Należy traktować je jako liczby pomocne przy planowaniu, a nie obietnicę dla każdego procesora CPU, GPU, NPU czy środowiska przeglądarkowego.
Dlaczego wspólna przestrzeń embeddingów jest użyteczna
Większość systemów retrievalowych nadal składa się z łańcucha wyspecjalizowanych komponentów. Dokumenty przechodzą przez tekstowy model embeddingowy. Obrazy są opisywane albo osadzane osobno. Dźwięk jest transkrybowany. Wideo dzieli się na klatki, które następnie są opisywane lub osadzane. Wyszukiwanie pozostaje wtedy w obrębie jednej modalności albo zależy od drugiego etapu, który łączy wyniki z różnych indeksów. Taka architektura może działać dobrze, ale wprowadza dodatkowe opóźnienia, więcej punktów awarii i więcej decyzji dotyczących tego, jakie informacje wolno odrzucić.
Ujednolicona przestrzeń embeddingów zmienia pierwsze pytanie z „jak przetłumaczyć ten materiał na tekst?” na „co jest semantycznie blisko tego zapytania, niezależnie od pierwotnego formatu?”. Wyobraźmy sobie aplikację dla serwisu terenowego. Technik może wyszukać głosowy opis usterki i oczekiwać znalezienia instrukcji konserwacji, fotografii uszkodzonego komponentu oraz krótkiego filmu pokazującego naprawę. Tekstowy pipeline może to obsłużyć, ale wymaga transkrypcji, etykietowania obrazów i starannego rozszerzania zapytań. Natywny multimodalny embedder może udostępnić te relacje wcześniej w całym pipeline’ie.
Ten sam schemat dotyczy zespołów programistycznych. Repozytorium może zawierać kod źródłowy, dokumentację API, diagramy architektury, nagrania terminala i zrzuty ekranu z błędu. Deweloper pytający „na którym ekranie widać błąd odświeżania tokenu?” nie zadaje pytania czysto tekstowego. Model umieszczający kod i obrazy we wspólnej przestrzeni może pozwolić warstwie retrievalowej znaleźć dowód, którego tekstowy indeks nigdy by nie pokazał.
Istnieje również argument dotyczący prywatności. Jeśli embeddingi można tworzyć lokalnie, urządzenie nie musi wysyłać prywatnych fotografii, nagranych rozmów ani wewnętrznych dokumentów do hostowanej usługi indeksowania tylko po to, aby można było je przeszukiwać. Działanie offline może ograniczyć ekspozycję danych i poprawić responsywność w środowiskach ze słabym połączeniem. Samo w sobie nie czyni jednak całej aplikacji prywatną: logi, analityka, synchronizacja, pobieranie modeli i model generatywny używany po retrievalu wymagają osobnej oceny.
Wydanie nie dotyczy więc przede wszystkim hasła „AI w telefonie”, lecz przesunięcia konkretnego fragmentu infrastruktury bliżej danych. Lokalny indeks może obsługiwać wyszukiwanie podczas pisania, prywatny retrieval dokumentów, organizowanie mediów i routing zero-shot bez wysyłania zapytania do API embeddingowego. Są to konkretne korzyści, gdy urządzenie, środowisko uruchomieniowe i korpus mieszczą się w zakresie działania modelu.
Model jest dość mały, by go testować, ale nie automatycznie dość mały dla każdego produktu
Model z 740 milionami parametrów jest kompaktowy w porównaniu ze współczesnym modelem generatywnym, ale nie jest bezkosztowy. Deweloperzy muszą uwzględnić pliki modelu, tokenizer i kod procesora, tymczasową pamięć aktywacji, indeks wektorowy, samą aplikację oraz ewentualny reranker lub model językowy używany później. Koszt danych multimodalnych również bardzo się różni. Zapytanie tekstowe, obraz w wysokiej rozdzielczości, długie nagranie audio i sekwencja klatek wideo nie są równoważnymi jednostkami pracy.
Modularna konstrukcja pomaga. Aplikacje tekstowe i kodowe mogą korzystać z mniejszej konfiguracji i nie dostarczać nieużywanych enkoderów. Biblioteka zdjęć może załadować obsługę obrazu bez włączania dźwięku. Aplikacja indeksująca sporadyczne nagrania wideo może przetwarzać klatki w zadaniu działającym w tle, zamiast utrzymywać każdą modalność w pamięci podczas interaktywnego wyszukiwania. Są to decyzje architektoniczne, a nie tylko flagi przekazywane w wywołaniu API.
Podawane wartości pamięci są najbardziej przekonujące dla deweloperów, którzy mają już wąski lokalny przypadek użycia. Narzędzie do wyszukiwania notatek w telefonie, katalog multimediów na komputerze albo offline’owy asystent wsparcia mogą zmierzyć, czy kilkaset megabajtów i lokalne opóźnienie inferencji są akceptowalne. Duże archiwum przedsiębiorstwa z milionami dokumentów może nadal wymagać serwerowej warstwy indeksowania, przetwarzania wsadowego, rozproszonego magazynu wektorów i osobnej polityki przechowywania surowych mediów.
Kwantyzacja dodaje kolejną warstwę decyzji. Może sprawić, że model będzie działał na większej liczbie urządzeń, ale zmiana precyzji numerycznej może wpłynąć na ranking podobieństwa. Jeśli aplikacja zwraca tylko kilka wyników, niewielki spadek recallu może być natychmiast widoczny. Jeśli korzysta z szerokiego zbioru kandydatów, a potem z silnego rerankera, ten sam spadek może być do zaakceptowania. Właściwy test nie polega na sprawdzeniu, czy skwantyzowany model się uruchamia. Trzeba sprawdzić, czy końcowy produkt zwraca właściwe dowody przy akceptowalnym koszcie.
Pierwszym testem praktycznym powinna być jakość retrievalu, nie demonstracja
Najłatwiejsza demonstracja to wyszukiwanie między modalnościami: wpisanie zdania i otrzymanie pasującego obrazu albo pokazanie obrazu i znalezienie powiązanego tekstu. Jest to dobry sposób na potwierdzenie, że pipeline został poprawnie połączony, ale niewiele mówi o jakości produkcyjnej. Zespół powinien przygotować mały zbiór ewaluacyjny, zanim zmieni indeks.
Należy zacząć od rzeczywistych zapytań z docelowego procesu pracy. Dla bazy kodu warto zebrać wyszukiwania, które deweloperzy faktycznie wykonują, i oznaczyć pliki zawierające odpowiedź. Dla archiwum wsparcia można wybrać nagrania, zrzuty ekranu i dokumenty należące do tych samych incydentów. Dla prywatnej biblioteki lepiej użyć naturalnych opisów niż etykiet napisanych przez autora testu. Trzeba też uwzględnić trudne negatywy: podobne wizualnie obrazy o innym znaczeniu, pliki kodu dzielące słownictwo, lecz implementujące odmienne zachowanie, oraz nagrania, których transkrypcja zawiera właściwe słowa, podczas gdy istotny dowód widać wyłącznie na wideo.
Recall należy mierzyć przy kilku wartościach cutoffu, a nie tylko sprawdzać, czy pierwszy wynik wygląda dobrze. Recall@5 lub recall@10 pokazuje, czy downstreamowy reranker ma szansę odzyskać odpowiedź. Opóźnienie indeksowania i zapytań interaktywnych trzeba rejestrować osobno. Warto zapisywać zużycie pamięci, wpływ na baterię i rozmiar indeksu na rzeczywistych urządzeniach, które mają znaczenie dla produktu. Jeśli aplikacja obsługuje wiele modalności, należy porównać wyszukiwanie w obrębie jednej modalności z wyszukiwaniem między modalnościami. Model może być dobry w retrievalu tekstu, a słabszy w dopasowaniu obraz–tekst lub audio–kod.
Szczególnej uwagi wymaga formatowanie wejścia. Przewodnik po modelu opisuje użycie zadań za pośrednictwem sentence-transformers i identyfikuje model jako google/embeddinggemma-2. Modele embeddingowe często rozróżniają dokument, zapytanie, tytuł i fragment za pomocą prefiksów albo ustrukturyzowanych promptów. Jeśli korpus zindeksowano według jednej konwencji, a zapytanie zakodowano według innej, jakość może spaść bez żadnego oczywistego błędu w czasie działania. Zespół powinien przechowywać dokładne ustawienia preprocessingu, obsługi modalności, wymiarowości i normalizacji razem z wersją indeksu.
Minimalny eksperyment może porównać cztery konfiguracje: dotychczasowy tekstowy embedder, EmbeddingGemma 2 z pełnymi wektorami 768-wymiarowymi, ten sam model ze zredukowanym wymiarem MRL oraz lokalny build po kwantyzacji. Korpus i zestaw zapytań muszą pozostać takie same. Taki eksperyment daje bardziej użyteczną odpowiedź niż dopracowana demonstracja, bo pokazuje, czy multimodalność rozwiązuje rzeczywistą lukę w retrievalu, czy tylko dodaje kolejny model do utrzymania.
Gdzie deweloperzy powinni wypróbować model w pierwszej kolejności
Najlepszymi kandydatami na początek są aplikacje, w których informacje użytkownika są już wymieszane między formatami, a wysyłanie ich do hostowanego API jest niepożądane. Jednym z przykładów jest lokalna baza wiedzy. Może indeksować Markdown, PDF-y, zrzuty ekranu i notatki głosowe, a następnie zwracać powiązane materiały bez przesyłania plików źródłowych. System nadal potrzebuje parsowania dokumentów, OCR-u i być może rozpoznawania mowy, ale etap embeddingów może zapewnić wspólną warstwę retrievalu, gdy te dane są już dostępne.
Innym przykładem jest katalog multimediów na komputerze. Użytkownik może wyszukać zdjęcie i znaleźć powiązane semantycznie notatki tekstowe albo wyszukać frazę i otrzymać obrazy oraz krótkie klipy. Lokalny model jest szczególnie istotny, gdy biblioteka jest prywatna, duża i nie nadaje się do synchronizacji z chmurą. Produkt powinien jasno informować, czy embeddingi są przechowywane lokalnie, czy miniatury albo oryginalne media opuszczają urządzenie i czy jakakolwiek usługa działająca w tle wykonuje dodatkowe przetwarzanie.
Narzędzia dla deweloperów to obszar bardziej wymagający technicznie, ale obiecujący. IDE albo przeglądarka kodu mogłyby łączyć fragmenty kodu rozpoznawane po symbolach ze zrzutami ekranu zgłoszeń, materiałami projektowymi i nagranymi sesjami testowymi. Podawana przez Google poprawa dla kodu uzasadnia testy, ale wyszukiwanie kodu ma ograniczenia, których nie odzwierciedla ogólne podobieństwo semantyczne. Nazwy, importy, relacje wywołań, granice wersji i dokładne komunikaty błędów często są ważniejsze niż szerokie podobieństwo pojęciowe. Bezpieczniejszy może być system hybrydowy łączący wyszukiwanie leksykalne, indeksy symboli i embeddingi, zamiast zastępowania całego istniejącego wyszukiwania jednym indeksem wektorowym.
Kolejnym przypadkiem użycia jest routing intencji na urządzeniu, wymieniany w materiałach startowych Google. Zamiast trenować klasyfikator dla każdej małej aplikacji, deweloper może porównywać wejście z zestawem etykiet lub opisów i wybierać najbliższą intencję. To atrakcyjne dla poleceń offline i interfejsów wrażliwych na prywatność. Potrzebne są jednak zachowawcze progi. Dopasowanie o niskiej pewności powinno prowadzić do doprecyzowania albo deterministycznej ścieżki, a nie po cichu uruchamiać działanie destrukcyjne.
Wyszukiwanie wideo może skorzystać ze wspólnej przestrzeni, ale właśnie tutaj założenia dotyczące kosztu mogą najszybciej zawieść. Długie nagranie trzeba próbkować, a właściwy moment może znajdować się między wybranymi klatkami albo zależeć od mowy. Osadzanie każdej klatki z pełną jakością może stworzyć duży indeks i kosztowne zadanie ingestu. Praktyczny system może łączyć fragmenty transkrypcji, granice scen, wybrane klatki kluczowe i metadane, a następnie używać modelu multimodalnego do generowania kandydatów.
Czego nie należy zakładać na podstawie premiery
Pierwszy błąd polegałby na traktowaniu słowa „otwarty” jako pełnego opisu wydania. Według dokumentacji Google EmbeddingGemma 2 ma otwarte wagi i licencję Apache 2.0, co jest dobrym punktem wyjścia do wdrażania i modyfikacji. Aplikacja nadal dziedziczy jednak zobowiązania wynikające z pozostałych zależności, środowiska serwowania modelu, zbiorów danych i kanału dystrybucji. Zespół powinien zachować licencję modelu razem z dokładnymi wagami, które dostarcza, oraz przejrzeć dodatkowe warunki Gemma i wymagania dotyczące użycia wybranego artefaktu.
Drugi błąd to założenie, że wspólna przestrzeń wektorowa sprawia, iż wszystkie modalności są równie łatwe do przeszukiwania. Dopasowanie między modalnościami jest celem optymalizacji, a nie gwarancją identycznej jakości dla tekstu, obrazów, wideo i dźwięku. Opublikowane przez Google benchmarki dostarczają dowodów dotyczących wybranych zadań. Nie zastępują zbioru ewaluacyjnego zbudowanego na podstawie użytkowników aplikacji, obsługiwanych języków, stylów obrazów, warunków nagrywania i słownictwa domenowego.
Trzeci błąd polegałby na używaniu embeddingów jako granicy bezpieczeństwa. Indeks wektorowy może ujawniać informacje przez inference członkostwa, wyniki najbliższych sąsiadów albo źle zabezpieczone kopie zapasowe. Lokalne przechowywanie ogranicza ekspozycję sieciową, ale nie chroni laptopa przed przejętym procesem ani odblokowanym urządzeniem. Wrażliwe aplikacje powinny uwzględniać szyfrowanie danych w spoczynku, kontrolę dostępu, zachowanie podczas usuwania oraz to, czy wektory pozostają po skasowaniu pliku źródłowego.
Czwarty błąd to mylenie retrievalu ze zrozumieniem. EmbeddingGemma 2 może pomóc wybrać istotne dowody, ale nie sprawdza, czy są one aktualne, autorytatywne lub bezpieczne do wykorzystania. Lokalny asystent RAG nadal potrzebuje atrybucji źródeł, reguł świeżości, filtrowania dostępu i modelu generatywnego poinstruowanego, aby odróżniał fakty z retrievalu od domysłów. Jeśli zostanie pobrany niewłaściwy zrzut ekranu albo przestarzała ścieżka kodu, płynna odpowiedź może utrudnić zauważenie błędu.
Alternatywy i sposób wyboru
Właściwe porównanie zależy od zadania. Jeśli aplikacja potrzebuje wyłącznie wielojęzycznego wyszukiwania tekstowego, oryginalna EmbeddingGemma albo inny sprawdzony tekstowy embedder może być tańszy i łatwiejszy do zweryfikowania. Nie ma powodu ponosić kosztu złożoności obsługi multimodalności, gdy korpus i zapytania są wyłącznie tekstowe. Dokumentacja Google przedstawia EmbeddingGemma 1 jako osobną, wcześniejszą wersję, a nie rozwiązanie wymagające migracji każdego użytkownika.
W wyszukiwaniu po stronie serwera większe modele embeddingowe mogą nadal wygrywać jakością albo zakresem językowym, zwłaszcza gdy pamięć i dostęp do sieci nie ograniczają projektu. Hostowane API może być prostsze operacyjnie, ale wprowadza pytania o koszty, opóźnienia, zarządzanie danymi i zależność od usługi. Zespół powinien porównywać całkowite działanie systemu, a nie wyłącznie benchmarki modeli: przepustowość indeksowania, opóźnienie zapytań, przechowywanie, zachowanie przy awariach i utrzymanie również mają znaczenie.
Wyspecjalizowane pipeline’y pozostają rozsądnym wyborem, gdy modalność ma wymagania domenowe. OCR może lepiej radzić sobie z dokładnym tekstem w dokumentach. Transkrypcja dźwięku może udostępniać słowa i znaczniki czasu. Narzędzia do analizy kodu mogą korzystać z parserów i serwerów językowych, aby rozumieć symbole oraz odwołania. EmbeddingGemma 2 może działać obok takich systemów jako wspólna warstwa semantyczna, zamiast je zastępować.
Otwarte modele multimodalne rozwijane przez inne społeczności mogą oferować odmienne kompromisy dotyczące rozmiaru, obsługi języków, zgodności ze środowiskiem uruchomieniowym albo licencji. Użyteczne pytanie nie brzmi, który model ma najmocniejsze hasło premierowe. Trzeba sprawdzić, czy da się go uruchomić w wymaganym środowisku, czy licencja pasuje do produktu, czy zespół potrafi odtworzyć preprocessing oraz czy jego błędy są akceptowalne dla zadania użytkownika.
Rozsądny plan wdrożenia
Na początku należy przypiąć dokładną wersję modelu i środowiska uruchomieniowego. Nie warto budować produkcyjnego indeksu na zmieniającym się artefakcie „latest”. Konfigurację preprocessingu, wymiar wyjściowy, regułę normalizacji i ustawienia kwantyzacji trzeba zapisać w metadanych indeksu. Przed dostrajaniem progu wyszukiwania należy przygotować niewielki, odłożony zbiór testowy.
Następnie warto przetestować jeden wąski proces od początku do końca. Dobrym pilotażem może być wyszukiwanie w kilku tysiącach wewnętrznych dokumentów i zrzutów ekranu albo znajdowanie klipów naprawczych w kontrolowanym zbiorze nagrań. Jeśli to możliwe, warstwę generowania odpowiedzi należy wyłączyć z pierwszego pomiaru. Najpierw trzeba udowodnić, że warstwa retrievalu zwraca właściwe dowody. Dopiero potem można oceniać, czy asystent działający po retrievalie tworzy lepsze odpowiedzi.
Lokalne i hostowane baseline’y należy porównywać przy użyciu tych samych zapytań. Trzeba uwzględnić wolne urządzenia, indeksowanie w tle i przerwane zadania. Warto sprawdzić, co dzieje się po usunięciu pliku źródłowego, gdy aktualizacja modelu zmienia geometrię wektorów oraz gdy użytkownik wyszukuje w języku lub formacie słabo reprezentowanym w zbiorze ewaluacyjnym. Reindeksowanie należy traktować jako oczekiwaną operację, a nie wyjątkową katastrofę.
Na końcu trzeba jasno pokazać granice produktu. Użytkownicy powinni wiedzieć, które dane pozostają na urządzeniu, co jest synchronizowane, jak długo utrzymują się embeddingi i czy po retrievalie wywoływany jest model online. Należy zapewnić możliwość sprawdzenia źródła stojącego za wynikiem. Jeśli system służy do podejmowania decyzji, przy niskiej pewności albo sprzeczności między dowodami powinno być wymagane potwierdzenie. Lokalna inferencja może poprawić prywatność i responsywność, ale przejrzystość nadal trzeba zaprojektować.
Szersze znaczenie wydania
EmbeddingGemma 2 jest interesującym otwartym wydaniem, ponieważ skupia się na tkance łącznej oprogramowania, a nie na efektownym doświadczeniu z chatbotem. Wartość multimodalnego modelu embeddingowego pojawia się dopiero wtedy, gdy produkt ma informacje, które użytkownicy muszą ze sobą połączyć: pytanie i zrzut ekranu, frazę i nagranie, funkcję i raport incydentu. W takich procesach kompaktowy lokalny model może uprościć indeksowanie i udostępnić prywatny retrieval na urządzeniach, które wcześniej zależały od serwera.
Wydanie nie jest powodem, by z dnia na dzień zastępować działający stos wyszukiwania. Jego praktyczny wkład to opcja, którą można sprawdzić: jedna rodzina modeli, kilka typów wejścia, działanie lokalne, otwarte wagi i mniejszy ślad wdrożeniowy niż w wielu ogólnych systemach multimodalnych. To połączenie uzasadnia ograniczony pilotaż, szczególnie w prywatnym wyszukiwaniu mediów, bazach wiedzy o mieszanych formatach i aplikacjach edge.
Rekomendacja jest prosta. Należy zacząć od korpusu, w którym retrieval między modalnościami rozwiązuje widoczny problem. Warto zachować indeksy leksykalne, strukturalne i wyspecjalizowane tam, gdzie zapewniają dokładność. Trzeba mierzyć recall, opóźnienie, pamięć, miejsce na dane i zachowanie podczas usuwania na rzeczywistym sprzęcie. Licencję oraz warunki modelu należy przejrzeć razem z resztą drzewa zależności. Jeśli EmbeddingGemma 2 poprawia dowody docierające do użytkownika, nie czyniąc systemu trudniejszym do zrozumienia, zasługuje na miejsce w stosie. Jeśli tworzy tylko bardziej efektowną demonstrację, mniejszy i prostszy baseline nadal będzie lepszą decyzją inżynieryjną.
Źródła
Opracowanie opiera się na materiałach Google dotyczących EmbeddingGemma 2, dokumentacji Google AI for Developers i Gemma, przewodniku deweloperskim, repozytorium oraz karcie modelu google/embeddinggemma-2 w Hugging Face, a także na dyskusjach społecznościowych dotyczących lokalnego uruchamiania i WebGPU. Atrybucja obejmuje również informacje licencyjne z dokumentacji wydań Gemma.
Comments
Sign in to comment.
No comments yet.