Das Verschwinden von ONNX Runtime auf GitHub ist ein Test für die Resilienz von Abhängigkeiten
Als das Quellcode-Repository von ONNX Runtime kurzzeitig mit 404 nicht erreichbar war, zeigte sich ein oft übersehener Unterschied: Installierte Pakete können weiter funktionieren, während Quellcode-Builds, Release-Dateien und CI-Automatisierung ausfallen.
Ein 404-Fehler bei einem bedeutenden Open-Source-Repository lässt sich leicht falsch deuten. Er kann den Eindruck erwecken, ein Projekt sei aufgegeben worden, ein Paket entfernt worden oder ein Sicherheitsvorfall bereits bestätigt. Im Fall von Microsofts ONNX Runtime am 17. und 18. November 2026 ließ die öffentliche Faktenlage jedoch nur eine engere Schlussfolgerung zu: Das zentrale GitHub-Repository und verbundene Repositories waren für Besucher nicht erreichbar, während die Projektdokumentation und die Paketkanäle weiterhin verfügbar blieben. Die Ursache war zum Zeitpunkt der Berichterstattung öffentlich nicht geklärt.
Diese Unterscheidung ist wichtig, weil ONNX Runtime unter vielen Anwendungen steckt, die sich selbst nicht als ONNX-Anwendungen zu erkennen geben. Die Software lädt ONNX-Graphen und führt sie aus, wählt hardwareabhängige Execution Provider aus und verpackt Inferenz für Python-, C#-, C++-, Java-, Android-, iOS-, Node.js- und Web-Umgebungen. Ein Team muss das Repository im normalen Entwicklungsalltag möglicherweise nie klonen und kann dennoch von Release-Dateien, nativen Bibliotheken, generierten Bindings, Container-Layern oder einem Quellcode-Checkout in einem reproduzierbaren Build abhängen.
Der praktische Rat lautet deshalb nicht: „ONNX Runtime sofort ersetzen.“ Entscheidend ist vielmehr, zu erfassen, welchen Teil des Projekts das eigene System tatsächlich benötigt, bewährte Artefakte zu sichern und ein Verfügbarkeitsereignis beim Upstream klar von einem Laufzeitfehler zu trennen.
Was geschah – und was nicht
Berichte vom 18. November beschrieben, dass github.com/microsoft/onnxruntime mit einem 404 antwortete. Das galt auch für mehrere verbundene Repositories und Release-Pfade. Der Vorfall schaffte es auf die Titelseite von Hacker News und führte zu Fragen von Nutzern, deren quellcodebasierte Workflows und automatisierte Abrufe das Repository nicht mehr auflösen konnten. Gleichzeitig blieb die offizielle ONNX-Runtime-Dokumentation verfügbar, und die Installationsanleitungen verwiesen weiterhin auf PyPI, NuGet, Maven, CocoaPods und andere Distributionswege.
Ein GitHub-404 ist von außen bewusst mehrdeutig. Das Repository könnte gelöscht, auf privat gestellt, umbenannt, deaktiviert, vorübergehend eingeschränkt oder von einem serverseitigen Problem betroffen gewesen sein. Ein 404 beweist nicht, dass Microsoft das Projekt beendet hat. Ebenso wenig belegt er, dass eine Sicherheitsbereinigung den Ausfall verursacht hat. Diese Erklärungen kursierten in der Community, waren jedoch Hypothesen und keine von den Maintainerinnen und Maintainer bestätigte Darstellung.
Bei späteren Prüfungen war das Repository wieder erreichbar. Das spricht eher für eine vorübergehende Verfügbarkeits- oder Verwaltungsänderung als für eine bestätigte dauerhafte Abschaltung. Auch das bleibt eine Schlussfolgerung und keine offizielle Erklärung nach dem Vorfall. Für Produktionsteams zählt die Unterbrechung selbst: Ein Build, der davon ausgeht, dass GitHub stets den maßgeblichen Quellcode oder das Release-Archiv ausliefert, kann fehlschlagen, obwohl die bereits installierte Runtime weiterhin normal ausgeführt wird.
Das Quellcode-Repository beschreibt ONNX Runtime als plattformübergreifende Inferenz- und Trainings-Engine für ONNX-Modelle. Die dokumentierte Pipeline lädt ein Modell, optimiert dessen Graphen, teilt die Arbeit auf verschiedene Execution Provider auf und führt den resultierenden Graphen aus. Das Projekt unterstützt CPU- und Beschleunigerpfade auf mehreren Betriebssystemen sowie Bindings für verschiedene Programmiersprachen. Diese Breite ist nützlich, bedeutet aber auch, dass es mehr Artefakte und Integrationspunkte gibt als bei einer kleinen, ausschließlich auf Python ausgerichteten Abhängigkeit.
Warum installierte Anwendungen weiter funktionieren können
Die meisten Paketmanager lösen eine Abhängigkeit nicht bei jedem Start einer Anwendung durch das Klonen des Git-Repositorys auf. Eine Python-Umgebung kann bereits ein onnxruntime-Wheel enthalten. Eine .NET-Anwendung kann Microsoft.ML.OnnxRuntime in einem lokalen oder entfernten Paket-Cache wiederhergestellt haben. Ein Android-Build kann ein AAR von Maven Central heruntergeladen haben. Eine JavaScript-Anwendung kann ihr Web- oder Node-Paket in einer Lockfile festgeschrieben und in einem Registry-Cache gespeichert haben.
Diese Artefakte können weiterhin nutzbar sein, nachdem ein Repository nicht mehr erreichbar ist. Entscheidend ist der Unterschied zwischen der Nutzung eines bereits heruntergeladenen unveränderlichen Artefakts und dem Auflösen, Bauen oder Aktualisieren eines Artefakts aus einer Upstream-Quelle. Ein laufender Dienst, der ein lokales Wheel lädt, ist von einem GitHub-404 nicht automatisch betroffen. Ein Clean-Room-Rebuild, der einen Tag, ein Submodul, eine Release-Datei oder ein generiertes Archiv von GitHub abrufen soll, kann dagegen sofort beeinträchtigt werden.
Deshalb reicht ein schneller Test mit pip install onnxruntime nicht aus. Er beantwortet lediglich die Frage, ob der Paketindex derzeit ein kompatibles Wheel für das anfragende Gerät bereitstellt. Er sagt nicht, ob sich ein Source-Build reproduzieren lässt, ob native Header verfügbar sind, ob ein bestimmter Execution Provider erneut gebaut werden kann oder ob sich die exakt in der Produktion eingesetzte Binärdatei aus einer sauberen Umgebung rekonstruieren lässt.
Teams sollten ihre Abhängigkeit in mindestens vier Ebenen einteilen:
- Laufzeit-Artefakt: das vom Anwendungsprogramm geladene Wheel, NuGet-Paket, JAR, AAR, CocoaPod-, npm-Paket oder die native Bibliothek.
- Modell-Artefakt: das Modell im ONNX- oder ORT-Format, Tokenizer- oder Preprocessing-Code sowie alle für dieses Modell erforderlichen externen Initializer.
- Build-Eingaben: Source-Tags, Submodule, Compiler-Versionen, CMake-Konfiguration, Dependency-Archive, generierte Dateien und Quellen der Execution Provider.
- Betriebsmetadaten: Prüfsummen, Herkunftsnachweise, Lizenzhinweise, SBOM-Einträge, Release Notes und Kompatibilitätsvorgaben.
Ein Ausfall des Repositorys bedroht zunächst vor allem die dritte und vierte Ebene. Später kann auch die erste betroffen sein, wenn ein Paket neu gebaut oder ein Wheel für eine neue Plattform benötigt wird. Die zweite Ebene oder das Verhalten einer bereits in der Produktion getesteten Binärdatei werden dadurch nicht automatisch ungültig.
Das Problem mit Source-Builds ist größer als ein Git-Clone
Die Build-Dokumentation von ONNX Runtime empfiehlt für Produktions-Builds ausdrücklich, einen offiziellen Release-Branch zu verwenden, und rät davon ab, das unveröffentlichte main zu bauen, sofern nicht ein bestimmtes Feature benötigt wird. Der dokumentierte Build-Prozess kann CMake, sprachspezifische Toolchains, Compiler-Laufzeitumgebungen, Plattform-SDKs und optionale Execution Provider umfassen. Abhängigkeiten können über vcpkg bezogen, aus dem Quellcode gebaut oder als bereits installierte Pakete aufgelöst werden.
Damit ist ein Source-Build eine Lieferkette und kein einzelner Download. Selbst wenn das Repository wieder erreichbar ist, kann der Build nicht reproduzierbar sein, wenn der CI-Job auf nicht fixierte Dependency-Versionen, ein nicht gepinntes Submodul, ein externes Archiv ohne Prüfsumme oder einen Paketindex angewiesen ist, der sich seit dem letzten Lauf verändert hat.
Ein sinnvoller Test besteht darin, die aktuell in der Produktion eingesetzte Version ohne Netzwerkzugriff auf das Live-Upstream-Repository erneut zu bauen. Dafür ist keine sofortige Migration nötig. Erforderlich ist eine kontrollierte Übung mit einem Wegwerf-Builder, einem internen Artefakt-Cache und einer dokumentierten Toolchain. Halten Sie fest, ob der Build Folgendes finden kann:
- die exakte ONNX-Runtime-Quellrevision;
- alle Git-Submodule und generierten Eingaben;
- die Versionen von Compiler, CMake, Python, Java, .NET und Plattform-SDK;
- die vom Build erwarteten Versionen von ONNX und protobuf;
- anbieterspezifische Abhängigkeiten wie CUDA-, cuDNN-, TensorRT-, DirectML-, OpenVINO- oder QNN-Komponenten;
- Release-Archive und Header, die nachgelagerte native Integrationen verwenden; sowie
- die Lizenz- und Hinweisdateien, die einer Weiterverteilung beiliegen müssen.
Wenn ein sauberer Rebuild scheitert, sollte der Fehler nicht als Regression von ONNX Runtime bezeichnet werden, bevor die fehlende Eingabe identifiziert ist. Ein Ereignis zur Repository-Verfügbarkeit, ein Ausfall des Paketindexes, ein inkompatibler CUDA-Stack und eine abweichende Compiler-Version können im selben CI-Job jeweils andere Symptome hervorrufen.
Was in einer bestehenden Bereitstellung geprüft werden sollte
Beginnen Sie mit dem Artefakt, das tatsächlich zur Laufzeit geladen wird. Prüfen Sie bei Python die Version der installierten Distribution, den Dateinamen des Wheels, das Plattform-Tag und den Paket-Hash. Bei .NET sollten Sie die aufgelöste Assets-Datei und die für die Zielarchitektur ausgewählte native Laufzeit untersuchen. Für Java und Android sollten Sie die Maven-Koordinaten, die Repository-URL, die Prüfsumme und die nativen Bibliotheken im AAR oder JAR festhalten. Bei Node.js- oder Web-Bereitstellungen muss geklärt werden, ob die Anwendung ein vorgefertigtes Paket, einen lokal gebündelten WebAssembly-Build oder eine native Anbindung verwendet.
Erfassen Sie anschließend die von der Inferenzsitzung ausgewählten Execution Provider. ONNX Runtime kann für CPU, CUDA, TensorRT, DirectML, OpenVINO, CoreML, QNN und weitere Zielsysteme unterschiedliche Provider verwenden. Ein Paket, das sich erfolgreich importieren lässt, kann dennoch scheitern, wenn die Anwendung einen Provider anfordert, dessen Shared Libraries fehlen oder inkompatibel sind. Die offizielle Installationsdokumentation führt für mehrere dieser Pfade separate Pakete und Kompatibilitätsanforderungen auf. Außerdem weist sie darauf hin, dass sich DirectML im Sustained Engineering befindet und neue Windows-Projekte möglicherweise WinML in Betracht ziehen sollten.
Dann testen Sie das Modell – nicht nur den Import. Ein minimaler Gesundheitscheck sollte genau das Modell oder ORT-Format-Modell laden, das der Dienst verwendet, eine Inferenzsitzung mit der vorgesehenen Reihenfolge der Provider erstellen, eine repräsentative Eingabe ausführen und Ausgabeform, Datentyp sowie einige numerisch stabile Werte mit einer gespeicherten Referenz vergleichen. So lassen sich Probleme mit Providern und Graph-Optimierungen erkennen, die ein erfolgreicher Paketimport nicht sichtbar macht.
Testen Sie schließlich den Fehlerpfad. Was passiert, wenn der Paket-Cache leer ist? Was geschieht, wenn das Quellarchiv nicht verfügbar ist? Lädt CI stillschweigend einen Nightly-Build herunter? Fixiert eine Lockdatei zwar die Runtime, lässt aber transitive native Bibliotheken variieren? Baut das Deploymentsystem einen Container aus einem sich verändernden Basis-Image neu? Die Antworten zeigen, ob der GitHub-Vorfall nur lästig war oder einen Release tatsächlich stoppen konnte.
Ein kleiner Eindämmungsplan für Maintainer
Der erste Schritt besteht darin, sich während eines Releases nicht mehr auf Live-URLs zu verlassen. Fixieren Sie eine Version und speichern Sie das exakte Artefakt, die Prüfsumme und die Quellrevision in einer internen Registry oder einem langlebigen Objektspeicher. Bewahren Sie die ursprüngliche Upstream-URL als Herkunftsnachweis auf, lassen Sie den Build im normalen Release-Betrieb aber die verifizierte interne Kopie verwenden.
Archivieren Sie bei Source-Builds den vollständigen Quellbaum oder ein verifiziertes Quellpaket, einschließlich Submodulen und generierter Dateien, soweit die Lizenz- und Vertriebsbedingungen des Projekts dies erlauben. Bewahren Sie das Build-Manifest und die zum Konfigurieren des Builds verwendete Befehlszeile auf. Wenn der offizielle Release-Prozess des Projekts ein Tarball oder signiertes Release-Artefakt erzeugt, sollte dieses einem improvisierten Archiv eines sich verändernden Branches vorgezogen werden.
Aktivieren Sie bei paketbasierten Deployments einen lokalen oder organisationsweiten Proxy-Cache und prüfen Sie, ob darin die von Ihrer Flotte verwendeten Plattformvarianten gespeichert werden. Ein CPU-only-Linux-Wheel ersetzt weder ein CUDA-fähiges Paket noch ein Windows-Provider-Paket, ein Android-AAR oder eine Node-Bindung. Erfassen Sie die gesamte Matrix, statt nur den logischen Namen der Abhängigkeit zu dokumentieren.
Fixieren Sie bei Containern die Image-Digests und bewahren Sie das entsprechende Image in einer privaten Registry auf. Enthält das Image eine native Runtime, dokumentieren Sie die Betriebssystembasis, die glibc- oder musl-Annahmen, GPU-Bibliotheken und die Entrypoint-Konfiguration. Ein erneuter Build aus derselben Dockerfile ist nicht gleichwertig mit dem ursprünglichen Image, wenn Basis-Image und Paketindizes variabel sind.
Sorgen Sie im Release Engineering dafür, dass CI deutlich fehlschlägt, wenn ein benötigtes Upstream-Artefakt fehlt. Gefährlich ist nicht ein roter Build, sondern ein Job, der auf ein fehlendes Release-Artefakt mit der Auswahl von latest, dem Wechsel zu einem Nightly-Paket oder einem Neubau aus main reagiert, ohne dass dafür ein sichtbarer Freigabeschritt erforderlich ist.
Was Sie vorerst nicht tun sollten
Wechseln Sie nicht allein deshalb zu einem Fork, weil ein 404-Fehler aufgetreten ist. Ein Fork kann vorübergehend als Quellspiegel sinnvoll sein, schafft aber eine neue Vertrauensgrenze. Vergleichen Sie vor seiner Verwendung die Commit-Historie mit einer bekannten, funktionierenden Upstream-Revision, prüfen Sie Workflow-Dateien und Release-Skripte, verifizieren Sie Lizenz und Hinweise und klären Sie, wie Sicherheitskorrekturen verfolgt werden.
Betrachten Sie ein Paket, das sich weiterhin installieren lässt, nicht als Beweis dafür, dass das Projekt gesund ist. Paketindizes behalten Artefakte häufig auch nach Änderungen am Quellhosting. Das ist gut für die Kontinuität, bestätigt aber nicht, dass künftige Releases, Sicherheitspatches, neue Architekturen oder Korrekturen auf Quelltextebene planmäßig eintreffen werden.
Gehen Sie nicht davon aus, dass die Wiederherstellung eines Repositorys alle Build-Fragen erledigt. Wenn ein sauberer Build zuvor von veränderlichen URLs oder nicht fixierten Tools abhing, hat der Ausfall eine Prozessschwäche offengelegt, die bei einer anderen Dienstunterbrechung erneut auftreten wird. Die richtige Reaktion besteht darin, die Abhängigkeit zu bewahren und den Weg reproduzierbar zu machen – nicht einfach darauf zu warten, dass die Upstream-Seite zurückkehrt.
Verwenden Sie Nightly-Builds nicht ohne eine neue Risikobewertung als Notlösung. Die offizielle Installationsdokumentation beschreibt Nightly-Pakete als nützlich zum Testen von Änderungen zwischen offiziellen Releases und rät davon ab, sie in der Produktion einzusetzen, da der Support eingeschränkt ist. Diese Warnung ist besonders relevant, wenn ein Team bereits mit Unsicherheit über die Verfügbarkeit der Quellen arbeitet.
Alternativen und Grenzen einer Migration
Es gibt keinen universellen Ersatz für ONNX Runtime, denn der praktische Nutzen des Projekts liegt oft eher in der Abdeckung verschiedener Provider und Plattformen als allein im API-Namen. Für ein bestimmtes Modell und Gerät kann ein Team möglicherweise eine Framework-native Runtime, TensorRT, OpenVINO, Core ML, DirectML, WebAssembly oder eine anbieterspezifische Inference-Engine einsetzen. Jede Alternative verändert jedoch die unterstützte Menge an Operatoren, das Quantisierungsverhalten, das Leistungsprofil, die Anforderungen an die Paketierung oder die Portabilität.
Der richtige Vergleich beginnt beim Modell und bei der Zielhardware. Erfassen Sie die vom Modell verwendeten Operatoren, die benötigte Präzision, das Verhalten bei dynamischen Shapes, benutzerdefinierte Operatoren, Annahmen zur Batch-Verarbeitung, Speichergrenzen und das Latenzbudget. Testen Sie anschließend die infrage kommende Runtime mit denselben Eingaben und derselben Provider-Konfiguration. Ein Benchmark, der nur einen aufgewärmten CPU-Pfad misst, belegt keine Gleichwertigkeit mit einem GPU-Dienst im Kaltstart oder einer Android-Anwendung.
ONNX bleibt als Austauschformat wertvoll, doch der Austausch garantiert keine identische Ausführung. Verschiedene Runtimes können denselben Graphen mit unterschiedlichen Kernels, Graph-Transformationen, Rundungsverfahren und Fallbacks für nicht unterstützte Operatoren implementieren. Bewahren Sie numerische Toleranzen und Akzeptanztests auf Anwendungsebene, bevor Sie eine Migration als bloße Umbenennung eines Pakets behandeln.
Die Open-Source-Lehre betrifft die Grenzen von Artefakten
Die wichtigste Lehre aus dem Vorfall rund um ONNX Runtime lautet nicht, dass GitHub unzuverlässig sei oder ein Microsoft-Projekt aufgegeben werden sollte. Entscheidend ist: „Open Source“ beschreibt den Zugang zum Quellcode und die Rechte nach einer Lizenz. Es garantiert nicht, dass jede Build-Eingabe, jedes Binärartefakt, jeder Mirror, jeder Paketindex oder jeder Hosting-Dienst dauerhaft verfügbar ist.
Das Repository von ONNX Runtime steht unter der MIT-Lizenz, doch das Projekt bindet auch zahlreiche Abhängigkeiten mit eigenen Hinweisen und Lizenzbedingungen ein. Wer das Projekt weiterverbreitet, muss die jeweils geltenden Hinweise erhalten, statt die Lizenz auf oberster Ebene als einzige Grundlage für die Compliance zu behandeln. Das ist relevant, wenn eine Organisation interne Mirrors erstellt, native Bibliotheken neu paketiert oder einen angepassten Build an Kunden ausliefert.
Der Vorfall zeigt außerdem, warum Quellcodeverfügbarkeit und operative Verfügbarkeit getrennt erfasst werden sollten. Ein Projekt kann offen, dokumentiert und paketierbar bleiben, während eine bestimmte Forge, ein Release-Pfad oder eine CI-Integration vorübergehend nicht erreichbar ist. Umgekehrt kann ein Repository sichtbar sein, während sein Release-Prozess nicht reproduzierbar ist. Eine ausgereifte Abhängigkeitsprüfung dokumentiert sowohl die rechtliche Möglichkeit, den Code einzusehen und zu verändern, als auch die praktische Möglichkeit, das Artefakt neu zu bauen und zu verifizieren.
Für Teams, die ONNX Runtime bereits einsetzen, ist eine kurze Resilienzübung der sinnvolle nächste Schritt: Identifizieren Sie jedes von GitHub abgerufene Artefakt, frieren Sie die Produktionsversion ein, prüfen Sie Paket- und Modellpfade unabhängig voneinander, erstellen Sie einen Build aus einem internen Cache und dokumentieren Sie die Matrix der Execution Provider. Behalten Sie die aktuelle Runtime, wenn sie diese Prüfungen besteht. Starten Sie eine Migrationsuntersuchung erst dann, wenn Support, Sicherheit, Plattformabdeckung oder Reproduzierbarkeit des Projekts nicht mehr zu den Anforderungen der Anwendung passen.
Das ist die nachhaltigere Reaktion auf einen vorübergehenden 404-Fehler. Sie schützt die heutige Bereitstellung, liefert den Maintainerinnen und Maintainer ein klareres Ausfallsignal und lässt die Organisation mit einer funktionierenden Abhängigkeit zurück, selbst wenn der nächste Ausfall einen anderen Forge-Dienst, Paketindex oder Anbieter betrifft.
Related articles
FFmpeg 9.0 “Lei” ist ein wichtiges Open-Source-Upgrade mit Migrationsarbeit
Animiertes WebP, Vulkan, ONNX Runtime und ein ABI-Bruch über alle Bibliotheken: FFmpeg 9.0 bringt Fortschritt, aber kein sorgloses Drop-in-Update.
Open Source braucht langweilige Wartung, nicht das nächste Wunder
Warum gesunde Projekte von Review-Zeit, Release-Disziplin, Finanzierung und verlässlicher Routine leben.
Der Nexus-Fall zeigt, warum Dokumentprüfung zum Cyberrisiko wird
Gemeldete Verkäufe von Führerschein- und ID-Scans sind keine normale Datenpanne: Sie zeigen das Risiko gespeicherter Identitätsnachweise.
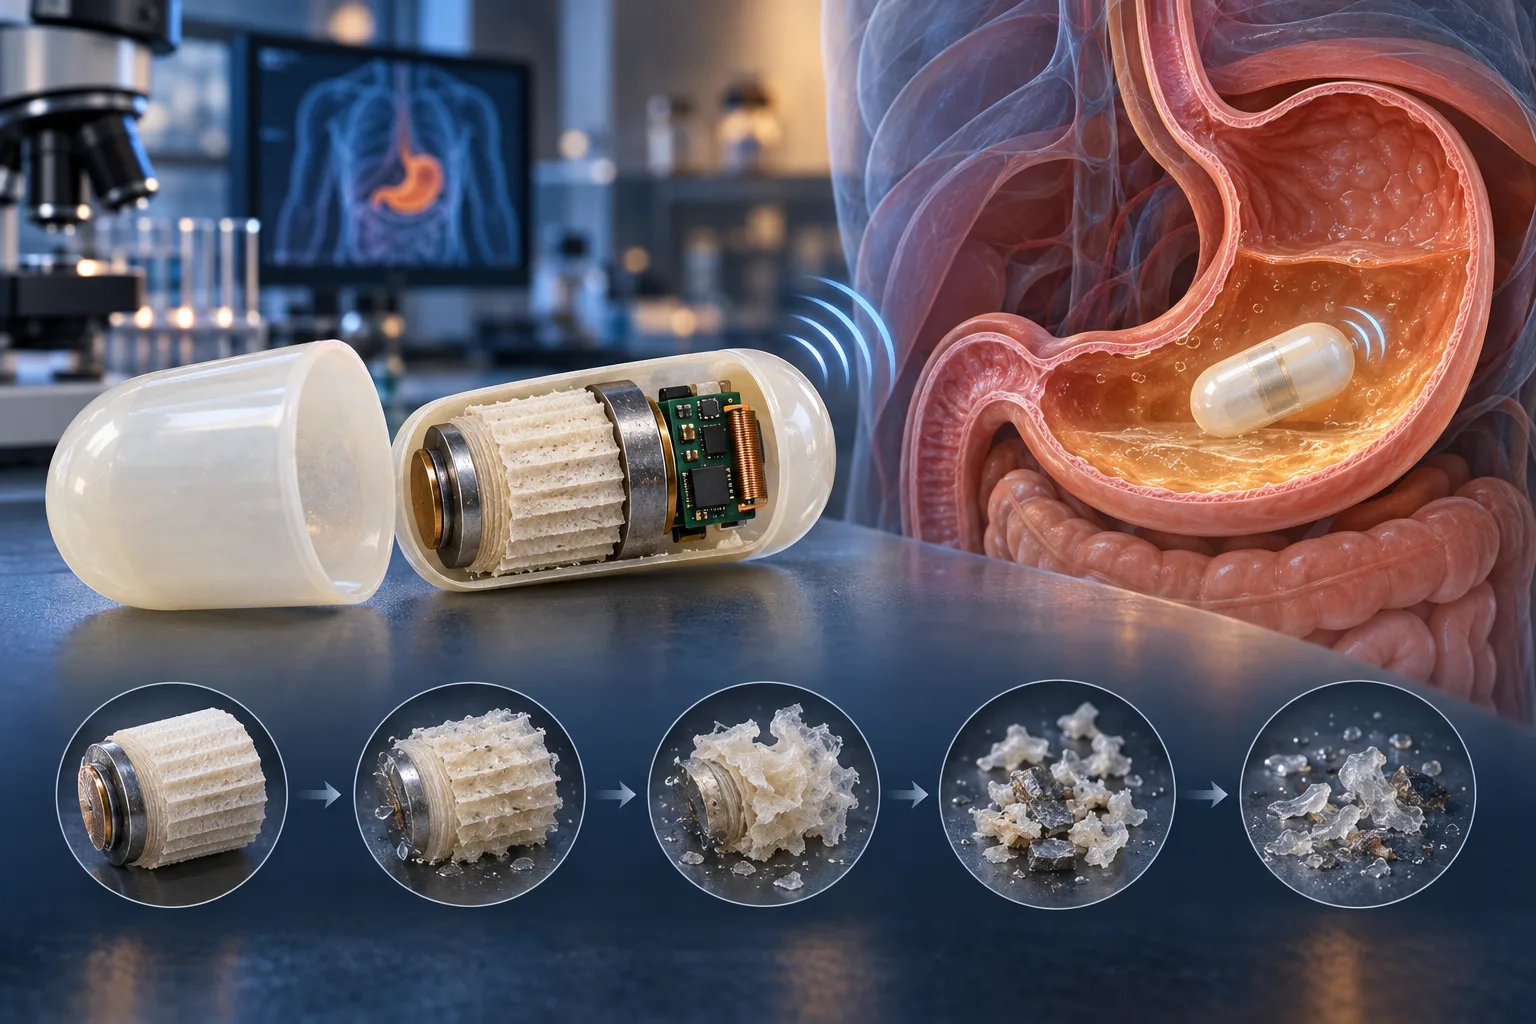
Eine Batterie für medizinische Kapseln, die im Körper arbeitet und sich danach auflöst
MIT-Forschende haben eine Magnesium-Molybdän-Batterie entwickelt, die bei Schweinen schluckbare Geräte mit Strom versorgt, Signale aus dem Magen überträgt und sich mit der Zeit abbaut. Der Schritt ist technisch bedeutsam, aber noch kein fertiges Medizinprodukt für Menschen.
Comments
Sign in to comment.
No comments yet.