Spettro place le workflow de l’agent de programmation dans le terminal et fait des permissions un élément central
Spettro est un jeune assistant de programmation en terminal, open source et sous GPL-3.0. Il mise sur les relais visibles entre agents, les validations humaines, le choix du fournisseur et l’isolation au niveau du système d’exploitation.
Spettro est un petit assistant de programmation open source au workflow volontairement visible. Il fonctionne dans le terminal, sépare la planification de l’implémentation, affiche l’agent actif et le mode de permission, et conserve suffisamment d’état pour reprendre une tâche plus tard. Le projet est écrit en Go, utilise une interface de terminal Bubble Tea et est distribué sous GPL-3.0. Au moment de la vérification, son dépôt affichait 37 étoiles et six forks, tandis que la dernière version taguée était la v2.8.2, publiée le 4 octobre 2026. Ces chiffres comptent : il s’agit d’un projet encore précoce à évaluer, pas d’une base établie pour un processus de développement à l’échelle d’une entreprise.
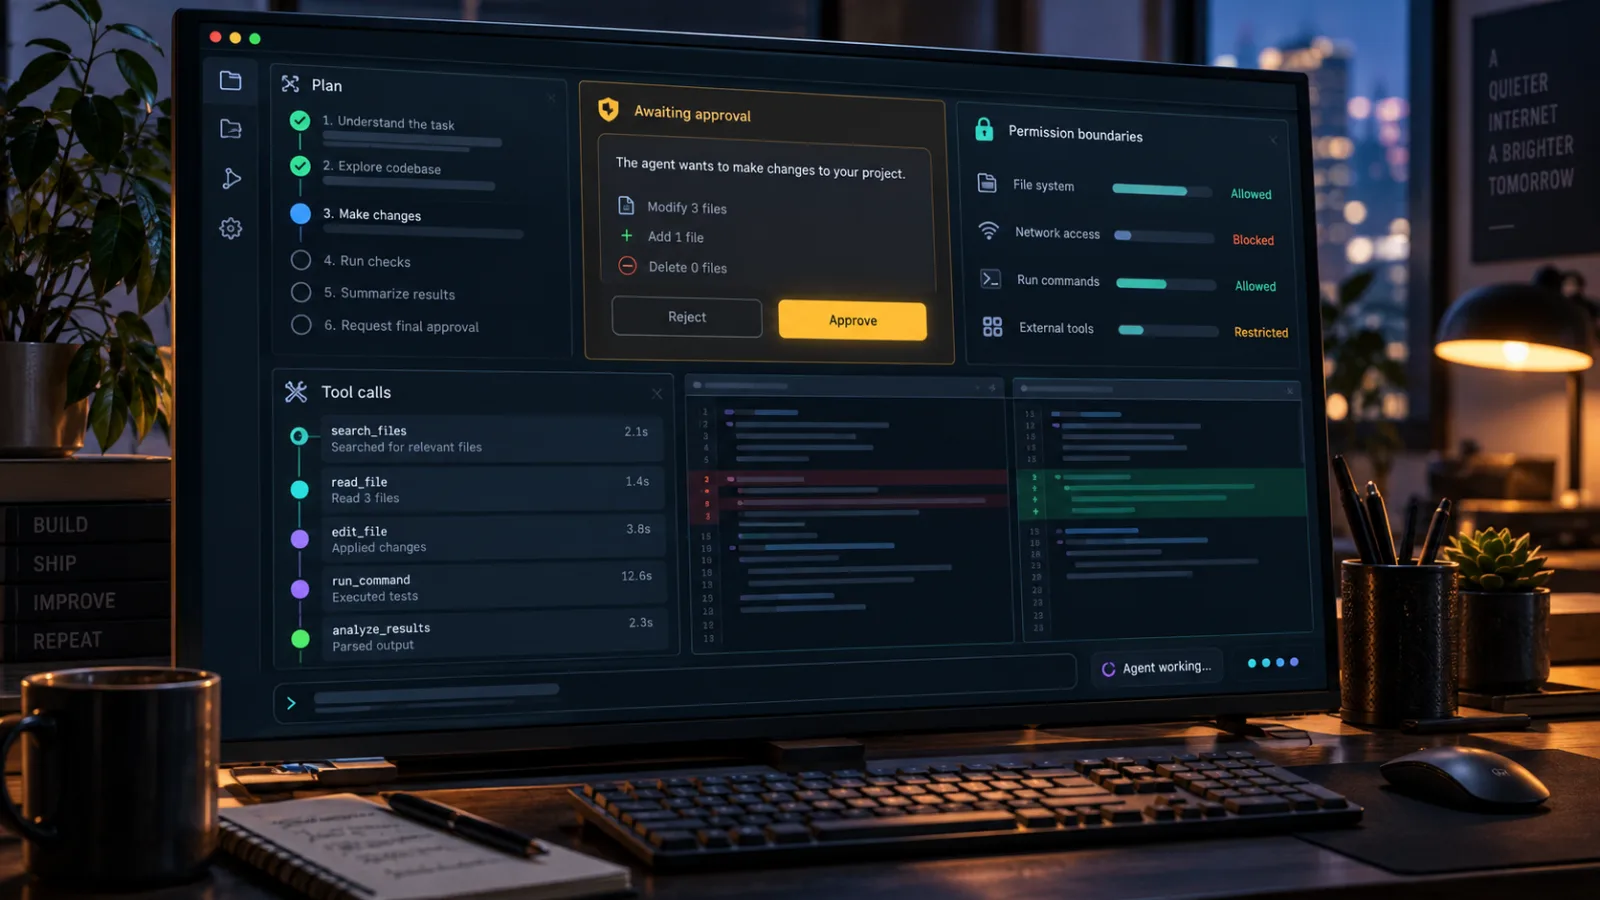
La question intéressante n’est donc pas de savoir si Spettro peut remplacer un assistant de programmation mature. Il ne l’a pas encore démontré. La meilleure question est de déterminer si sa conception rend le travail assisté par agent plus facile à superviser. Sur ce terrain plus limité, Spettro défend une idée cohérente : l’agent doit opérer à l’intérieur d’un périmètre de projet déclaré, proposer le travail avant de l’exécuter, utiliser des rôles nommés plutôt qu’un immense prompt unique et laisser une trace des appels d’outils qu’un développeur peut inspecter.
C’est une direction utile pour l’open source. De nombreux agents de programmation rivalisent sur la quantité de code qu’ils peuvent modifier avec une seule instruction. Spettro consacre davantage de sa surface produit à ce qui se passe avant et autour de la modification. Cela le rend intéressant pour les développeurs qui veulent étudier le contrôle des agents, construire des workflows locaux ou contribuer à une jeune application Go. Cela fournit aussi de nombreuses raisons de garder les expérimentations isolées.
Ce que Spettro apporte réellement
Le projet se décrit comme un assistant de programmation multi-agent pensé d’abord pour le terminal. La formule pourrait sembler interchangeable avec celle d’une liste croissante d’outils en ligne de commande, mais la structure de Spettro est plus précise. Son dépôt contient un manifeste d’agents, des fichiers de prompts, une interface utilisateur de terminal, une configuration des fournisseurs, la prise en charge de workflows, des sessions persistantes, des compétences, une mémoire, des hooks et un mode ACP séparé pour l’intégration aux éditeurs. Les rôles intégrés couvrent notamment la planification, le codage, les questions, l’exploration, le travail Git, les tests, la revue et la documentation.
L’unité importante n’est pas le rôle individuel. C’est le relais. Un agent de planification peut inspecter un dépôt et proposer une suite de modifications ; un agent de codage peut ensuite appliquer un plan approuvé ; les rôles de test et de revue peuvent intervenir après coup. Le manifeste et les fichiers de prompts sont visibles dans le dépôt, plutôt que conservés dans une configuration opaque côté service. Cela ne rend pas les résultats exacts par magie, mais cela donne au mainteneur quelque chose de concret à lire, à forker et à modifier.
L’interaction par défaut est également plus procédurale qu’une simple boîte de dialogue. Spettro demande à l’utilisateur d’autoriser un dossier de projet, de connecter un fournisseur de modèles, de choisir un modèle et de commencer avec l’agent de planification. Le README documente des commandes comme /plan, /approve, /permission, /models, /skills, /compact et /resume. Ce vocabulaire révèle la manière dont les développeurs imaginent l’usage de l’outil : une session est un environnement de travail, un plan est un objet soumis à la revue et un mode de permission fait partie de la tâche, au lieu d’être un détail caché de l’implémentation.
L’avantage pratique est réel. Lorsqu’une session d’agent déraille, le diagnostic n’est souvent pas simplement que « le modèle était mauvais ». Il est plus probable que l’agent ait disposé d’un accès trop large au système de fichiers, qu’une tâche n’ait pas été décomposée, qu’une commande ait été exécutée dans le mauvais répertoire, qu’un résultat d’outil n’ait pas été vérifié ou qu’une session interrompue ait perdu son contexte. Un workflow qui nomme ces étapes offre davantage de points d’arrêt et d’inspection à l’opérateur.
Les permissions sont le sujet principal
Le principal intérêt de Spettro pour l’open source réside dans sa tentative de rapprocher la limite de permission de la couche d’exécution. Son site indique que les commandes sandboxées peuvent être confinées avec Seatbelt sur macOS, Landlock sur Linux et Mandatory Integrity Control sur Windows. Il documente aussi des modes de système de fichiers comme off, workspace-write et read-only, ainsi que des politiques réseau comprenant all, localhost, none ou une liste explicite de ports.
Ces détails sont plus significatifs qu’une promesse générale selon laquelle l’agent serait « sûr ». Ils décrivent une surface de politique que l’opérateur peut examiner. Le projet indique que cette politique peut être fournie par des options de ligne de commande ou par un manifeste d’agent, et que le modèle ne peut ni l’inspecter ni la modifier. Dans un contexte d’agent de programmation, c’est la bonne frontière à discuter : le modèle de langage peut suggérer une commande shell, mais l’environnement hôte doit décider si cette commande peut atteindre un fichier, un répertoire, un périphérique ou une destination réseau.
La distinction est particulièrement importante avec les modèles locaux ou les services compatibles avec des API. Le choix du fournisseur ne supprime pas le risque d’exécution. Un modèle local peut toujours produire une commande destructive. Un modèle hébergé peut toujours mal comprendre le dépôt. Un petit runtime open source peut toujours contenir un bug dans ses contrôles de permission. La sandbox réduit le rayon d’explosion ; elle ne prouve pas que chaque workflow est sûr.
Le premier test raisonnable est donc volontairement banal :
1. Créer un dépôt jetable sans identifiants.
2. Lancer Spettro en mode lecture seule ou demande préalable.
3. Demander un plan qui décrit uniquement une petite modification.
4. Inspecter les appels d’outils et les chemins proposés.
5. Approuver une modification qui possède un test évident et un retour arrière simple.
6. Recommencer avec l’accès réseau désactivé.
Ne commencez pas en lui indiquant un répertoire personnel, un checkout de production, un dossier contenant des clés SSH ou un dépôt ayant accès à des identifiants de déploiement. Le fait qu’un projet expose des modes de permission est une raison de tester ces modes, pas de sauter le test.
La validation est utile, mais elle ne remplace pas la revue
Dans ses modes les plus stricts, Spettro sépare la planification de l’exécution par une étape /approve. C’est un bon modèle d’interaction : il donne à un humain la possibilité d’inspecter le périmètre proposé avant que les outils ne commencent à modifier les fichiers. C’est aussi un endroit naturel pour ajouter une checklist d’équipe : répertoires autorisés, fichiers attendus, tests à lancer, artefacts générés et commandes qui doivent rester interdites.
Il y a cependant une limite. La validation peut devenir un rituel si le plan est trop vaste ou trop difficile à lire. Une ligne indiquant « mettre à jour le flux d’authentification et corriger les tests associés » ne constitue pas un contrôle significatif simplement parce qu’elle a été approuvée. Un plan utile doit définir un ensemble de fichiers borné, donner une raison pour chaque changement et préciser une étape de vérification. Spettro peut exposer le workflow, mais sa qualité dépend encore des prompts, des instructions du dépôt et des habitudes qui l’entourent.
La même remarque vaut pour le mode d’objectif autonome. Le projet documente une commande /goal qui permet au runtime de continuer sur plusieurs itérations, de détecter les blocages, de reprendre la progression et de s’arrêter lorsqu’un objectif est marqué comme terminé. Cela peut être pratique pour les tâches longues, mais l’autonomie rend les points de contrôle encore plus importants. Une boucle d’objectif doit être traitée comme un pipeline de build doté d’un budget et d’une condition de sortie définis par un humain, pas comme la promesse que l’agent saura quand il en a fait assez.
Pour un développeur seul, le juste milieu consiste à réserver le mode objectif aux tâches dont la définition du fini est étroite. « Ajouter un parseur pour ces cinq exemples et écrire les tests » est vérifiable. « Améliorer l’architecture » ne l’est pas. Lorsque la tâche touche aux dépendances, aux identifiants, aux migrations, aux fichiers de déploiement ou au code sensible pour la sécurité, repassez à un flux fondé sur le plan et gardez la boucle courte.
Plusieurs agents ne signifient pas automatiquement de meilleurs résultats
Spettro met en avant le lancement parallèle de sous-agents ainsi que des rôles spécialisés d’orchestrateur et de travailleurs. Cela peut aider lorsque le travail se divise naturellement : un rôle explore le dépôt, un autre prépare les tests, un troisième relit un patch et l’orchestrateur rassemble les résultats. Cela peut aussi gaspiller du temps et des tokens si plusieurs agents répètent la même recherche ou produisent des suggestions incompatibles.
La valeur vient des frontières entre les rôles, pas du nombre d’agents. Une bonne décomposition attribue à chaque travailleur une question différente et un format de sortie clair. Par exemple, un rôle d’exploration peut identifier les paquets concernés et les tests existants ; un rôle de codage peut être limité à un plan d’implémentation ; un rôle de revue peut rechercher uniquement les régressions et les couvertures manquantes. Si chaque rôle reçoit la même consigne vague, le parallélisme ne fait que dupliquer l’incertitude.
L’approche fondée sur un manifeste est prometteuse parce qu’elle rend les définitions de rôles modifiables. Les mainteneurs peuvent examiner ce que l’on demande au planificateur, changer le prompt de revue, ajouter un rôle de documentation propre au projet ou supprimer un rôle inutile. Cela ressemble davantage à la personnalisation open source classique qu’à un tableau de bord fournisseur où le comportement change sans diff local.
Cette souplesse crée aussi du travail de maintenance. Les fichiers de prompts font partie du comportement du système. Ils ont besoin de tests, de versions et de revues. Une modification d’instruction d’agent peut avoir autant de conséquences qu’une modification d’un gestionnaire de commandes, surtout si elle change le moment où les outils sont appelés ou la quantité de contexte incluse. Les projets qui adoptent Spettro devraient examiner les manifestes d’agents avec le même sérieux que leur configuration CI et leurs scripts de développement.
La flexibilité des fournisseurs aide, mais elle transfère la responsabilité à l’opérateur
Le projet documente la prise en charge d’Anthropic, des API compatibles OpenAI et de points de terminaison locaux comme LM Studio ou Ollama. Il met aussi en avant le routage entre fournisseurs, un catalogue de modèles et des niveaux de raisonnement normalisés. C’est utile pour expérimenter : un développeur peut comparer un modèle hébergé à un modèle local, réserver un modèle moins coûteux à l’exploration d’un dépôt ou conserver une base de code sensible sur un point de terminaison interne suffisamment fiable.
L’indépendance vis-à-vis du fournisseur n’est pas une indépendance vis-à-vis du modèle. Les modèles interprètent différemment les outils, les limites de contexte, les sorties structurées et les instructions de validation. Un prompt qui produit un plan soigneux avec un fournisseur peut donner un résumé superficiel avec un autre. Un modèle qui gère bien une petite modification en Go peut peiner sur un monorepo volumineux. Le runtime peut normaliser une commande comme /thinking high, mais il ne peut pas rendre les modèles sous-jacents équivalents.
La meilleure méthode d’évaluation consiste à garder la tâche fixe. Utilisez un petit dépôt de référence, définissez les fichiers et les tests attendus, puis exécutez la même tâche avec deux fournisseurs. Notez si le plan identifie le bon code, si l’agent demande avant d’utiliser des outils, si le patch final passe les tests et quelle quantité de correction humaine a été nécessaire. Le résultat sera plus utile qu’un jugement de l’interface fondé sur une seule démonstration impressionnante.
Il existe aussi une question de gouvernance des données. Le dépôt indique que les clés sont chiffrées et le site présente des options de fournisseurs hébergés ou locaux, mais les utilisateurs doivent tout de même lire la documentation de configuration et de stockage avant de connecter des identifiants. Ils doivent déterminer quel processus peut lire la clé, où les données de session sont enregistrées, si les prompts et les sorties d’outils sont conservés et si une fonction web ou de relais activée crée un autre chemin de données. « Apportez votre propre clé » est un choix de déploiement, pas une politique complète de confidentialité.
ACP fait de Spettro davantage qu’une curiosité de terminal
Spettro peut fonctionner comme agent Agent Client Protocol via l’entrée et la sortie standard. Sa documentation ACP indique que des éditeurs comme Zed et des plugins Neovim peuvent le piloter depuis une interface d’agent native tout en réutilisant les réglages existants de fournisseur, de modèle, de permission, de manifeste et de sandbox. C’est un choix d’architecture pratique. Il permet de conserver la politique d’exécution dans un même runtime tout en changeant la façade.
Cela compte parce que les outils conçus d’abord pour le terminal sont souvent confrontés à un faux choix. Ils peuvent proposer un workflow en ligne de commande solide, mais obliger les utilisateurs à abandonner leur éditeur ; ou s’intégrer profondément à un éditeur et en hériter les hypothèses. ACP fournit une possible jonction entre ces préoccupations. Spettro peut rester le runtime de l’agent, tandis que l’éditeur devient l’endroit où l’utilisateur voit les prompts, les diffs et les questions.
Cette jonction est aussi un endroit où des bugs peuvent se cacher. Les intégrations d’éditeurs ajoutent la traduction de protocole, la gestion du cycle de vie, la sortie en flux, l’annulation et les demandes de permission. Un problème dans le client peut donner l’impression qu’une politique sûre est défaillante, ou une interface confuse peut pousser un utilisateur à approuver quelque chose sans comprendre son périmètre. Les premiers utilisateurs devraient tester ACP avec les mêmes restrictions que dans le terminal et vérifier qu’une annulation arrête réellement l’opération sous-jacente.
Pour l’instant, le meilleur argument en faveur d’ACP n’est pas qu’il remplace un assistant d’éditeur. C’est qu’il rend le projet plus facile à intégrer dans un workflow existant sans abandonner les contrôles déclarés du runtime. C’est un avantage architectural à surveiller, surtout si davantage de clients implémentent le protocole.
Le contrôle à distance et Telegram appellent une prudence supplémentaire
Le dépôt documente un plan de contrôle distant en boucle locale ainsi qu’un mode pouvant exposer ce plan de contrôle aux appareils du réseau local. Il documente également un relais Telegram. Ces fonctions peuvent être utiles à un développeur qui souhaite observer ou piloter une session depuis un autre appareil, mais elles modifient fortement le modèle de menace. Un outil de terminal qui lit uniquement les entrées locales est une chose ; un outil qui accepte des commandes distantes en est une autre.
Le choix prudent consiste à laisser les fonctions distantes désactivées tant que leur authentification, leur adresse d’écoute, la sécurité du transport et l’autorisation des commandes ne sont pas comprises. « Boucle locale » est plus restreint qu’une exposition au réseau local, mais ce n’est pas un substitut à la lecture de l’implémentation. Un point de terminaison web local peut tout de même être atteint par un autre processus, une extension de navigateur ou un port transféré. Un relais de discussion ajoute un compte tiers, la conservation des messages, la gestion d’un token de bot et la possibilité qu’une commande conversationnelle soit interprétée comme une instruction de modification du dépôt.
Si un mode distant est nécessaire, utilisez un projet jetable, liez-le à l’interface la plus restreinte possible, gardez une politique de système de fichiers restrictive et vérifiez les commandes disponibles avant de le connecter à un checkout réel. Ne considérez pas un historique de discussion visible comme une piste d’audit, sauf si le projet documente la manière dont il enregistre les appels d’outils, les événements de validation et les échecs.
Ce n’est pas une critique propre à Spettro. C’est une règle générale pour les runtimes d’agents : toute fonction de confort qui augmente l’accessibilité mérite une revue de sécurité distincte. Le fait que le code soit ouvert rend cette revue possible, mais ne l’effectue pas à votre place.
La GPL-3.0 est un choix significatif
Le dépôt de Spettro identifie le projet comme distribué sous licence GPL-3.0. C’est très différent des licences permissives utilisées par de nombreuses bibliothèques de développement. Les développeurs peuvent exécuter, étudier, modifier et partager le programme selon les conditions de la GPL, mais les organisations qui prévoient de l’intégrer à un produit propriétaire distribué doivent obtenir un avis juridique sur la manière dont elles combinent et distribuent le code.
La licence correspond aussi à la posture annoncée du projet. Spettro n’est pas seulement un SDK dissimulé derrière un service hébergé ; le dépôt comprend le runtime, les prompts, les scripts d’installation et la documentation. Une licence copyleft forte peut contribuer à préserver la liberté d’inspecter et de redistribuer des versions modifiées. Elle peut aussi réduire le nombre d’organisations prêtes à en faire un composant d’un outil commercial fermé.
Ne déduisez pas davantage de la licence qu’elle n’en dit. La GPL-3.0 ne garantit ni le support, ni des délais de réponse de sécurité, ni des builds reproductibles, ni une API stable. Ce sont des questions de gouvernance du projet et d’ingénierie des releases. La page de la dernière version affichait la v2.8.2, tandis que le README documente Go 1.26.1 ou une version plus récente pour compiler depuis les sources. Cela suffit à établir qu’il s’agit d’un projet actif et qui évolue rapidement, pas à garantir une compatibilité de long terme.
L’historique des releases dit « essayez-le », pas « standardisez-le »
La dernière version taguée listée sur GitHub, la v2.8.2, a été publiée le 4 octobre 2026. La précédente, la v2.8.1, ajoutait un logo de terminal animé, et la v2.8.0 avait été publiée le 28 septembre. La cadence visible suggère un projet qui avance rapidement à travers des changements d’interface et de workflow. Cela peut convenir à un utilisateur précoce qui souhaite recevoir rapidement des améliorations. Cela peut être contraignant pour des équipes qui ont besoin d’un comportement stable sur plusieurs machines.
Le dépôt n’affichait par ailleurs aucun nombre d’issues ou de pull requests dans le résumé de la page de release au moment de la vérification, tandis que la page principale montrait une petite communauté. Ces signaux doivent être interprétés avec prudence : ce sont des instantanés, pas une note de qualité. Ils signifient toutefois que de nombreuses questions importantes devront peut-être encore être résolues par la lecture du code plutôt qu’en s’appuyant sur des années de rapports communautaires.
Avant d’adopter une nouvelle version, épinglez la release ou le commit, gardez le binaire existant disponible et exécutez un test de fumée fixe. Celui-ci devrait couvrir l’autorisation du projet, la configuration du fournisseur, la génération d’un plan, la validation, une modification contrôlée de fichier, l’exécution des tests, la reprise d’une session et l’arrêt. Si vous utilisez ACP, ajoutez le démarrage de l’éditeur, l’annulation et les demandes de permission. Si vous utilisez le contrôle distant, ajoutez des vérifications d’authentification et de frontière réseau.
Un petit harnais de test vaut mieux qu’une grande démonstration. Il vous permet de repérer lorsqu’une mise à jour de dépendance modifie la surface de commandes, le mode de permission par défaut, la structure des prompts ou le comportement de persistance.
Qui devrait essayer Spettro maintenant
Spettro convient à quelques groupes précis.
D’abord, les développeurs qui préfèrent les workflows de terminal et veulent expérimenter avec des rôles d’agents sans s’engager auprès d’un seul fournisseur de modèles. La possibilité de connecter des fournisseurs hébergés ou locaux et d’inspecter le manifeste est utile pour les travaux de comparaison.
Ensuite, les mainteneurs open source qui s’intéressent à la mécanique de la supervision des agents. Spettro est assez petit pour être lu, écrit dans un langage familier et explicite sur les composants du workflow que de nombreux outils plus grands maintiennent derrière une frontière de service. Les contributeurs peuvent travailler sur les prompts, les adaptateurs de fournisseurs, le comportement de la sandbox, le support ACP, les tests, la documentation ou l’ingénierie des releases.
Enfin, les équipes qui construisent des prototypes internes dont l’exigence principale est un exécuteur de tâches contrôlable plutôt qu’une plateforme d’entreprise aboutie. Un espace de travail local restreint et dépourvu d’identifiants peut fournir un environnement sûr pour évaluer si les relais plan-validation améliorent la qualité de la revue.
Spettro convient mal à une équipe qui cherche un produit mature de gestion d’un parc, doté d’un support établi et d’une compatibilité de mise à niveau garantie. C’est également un mauvais premier choix pour les modifications non supervisées d’infrastructures de production, les dépôts contenant des identifiants sensibles ou les tâches dont l’achèvement ne peut pas être vérifié automatiquement.
Un plan d’évaluation pratique
Un essai utile peut tenir dans un après-midi si le périmètre reste petit. Commencez avec un dépôt neuf contenant un programme minuscule, un test en échec et un README court. Compilez Spettro depuis une release épinglée ou utilisez un artefact de release, puis lisez la documentation de configuration et de mise en place du projet. Ne commencez pas avec une application réelle.
Réglez le système de fichiers en lecture seule et le réseau sur none. Demandez à l’agent de planification de décrire comment il corrigerait le test en échec. Vérifiez qu’il identifie le fichier concerné et qu’il évite de prétendre avoir modifié quoi que ce soit. Passez ensuite à un espace de travail limité au dépôt jetable et approuvez la plus petite modification possible.
Réalisez ensuite la même tâche avec un second fournisseur ou un point de terminaison local. Comparez le plan, la séquence d’outils, le diff final, les tests et le nombre de corrections. Essayez d’interrompre l’exécution. Fermez le terminal et reprenez la session. Inspectez ce qui a été sauvegardé. Si vous utilisez un éditeur via ACP, répétez également les tests de validation et d’annulation.
Ce n’est qu’après ces vérifications que vous devriez ajouter un dépôt réel mais non sensible. Gardez l’agent éloigné des identifiants de déploiement, des tokens de publication de paquets et de la configuration personnelle. Utilisez un arbre de travail séparé ou une branche jetable. Notez la version, le modèle, le fournisseur, les réglages de permission et les instructions du dépôt afin qu’un résultat ultérieur puisse être reproduit.
Cette méthode fournit aussi des retours utiles au projet. Un rapport de bug contenant une version épinglée, une reproduction réduite, le mode de permission, le fournisseur et l’appel d’outil attendu par rapport à celui observé vaut bien davantage qu’un rapport disant simplement que l’agent s’est comporté de manière étrange.
Ce qu’il faut surveiller ensuite
Les prochains tests importants pour Spettro ne consistent pas en une nouvelle liste de commandes. Ils concernent la stabilité et les preuves. Le projet peut-il conserver une sémantique de permission cohérente tout en ajoutant des fonctions ? Peut-il rendre l’état des sessions inspectable et portable ? Son intégration ACP peut-elle préserver les mêmes garanties de validation que l’interface terminal ? Les mainteneurs peuvent-ils documenter le stockage des identifiants, des prompts, des sorties d’outils et des relais distants ? Un contributeur peut-il reproduire une release depuis les sources et comprendre quelles modifications affectent le comportement de l’agent ?
Le statut open source du projet rend ces questions vérifiables publiquement. Sa petite taille rend la contribution accessible. Sa maturité actuelle signifie que les réponses ne sont pas encore arrêtées. C’est précisément pour cette combinaison qu’il mérite d’être surveillé : non comme un remplacement fini de tous les assistants de programmation, mais comme une expérience concrète destinée à rendre le travail des agents lisible.
L’idée la plus utile de Spettro est assez simple pour être conservée : l’autonomie doit être entourée de limites explicites. Un plan doit être visible avant l’exécution. Un rôle doit avoir une fonction. Un appel d’outil doit hériter d’une politique. Une session doit pouvoir être reprise sans devenir mystérieuse. Le logiciel doit encore être renforcé, documenté et soumis à des revues de sécurité, et il lui faut une base plus large d’utilisateurs indépendants. En attendant, considérez-le comme un laboratoire prometteur et gardez le laboratoire isolé.
Sources
Les informations et attributions mentionnées dans cet article correspondent au dépôt, à l’historique des versions, au site officiel et à la documentation ACP de Spettro fournis pour cette adaptation.
Related articles
Comments
Sign in to comment.
No comments yet.