ROAM 展示视觉语言模型如何引导足式机器人,而无需直接控制其腿部
ETH 苏黎世的 ROAM 系统利用视觉语言模型理解地形、标志与危险,再将信息交给传统的建图和运动策略。它真正考验的是语义判断与物理控制之间的边界。
ROAM 的核心设计选择:由语言模型判断场景,而不是控制电机
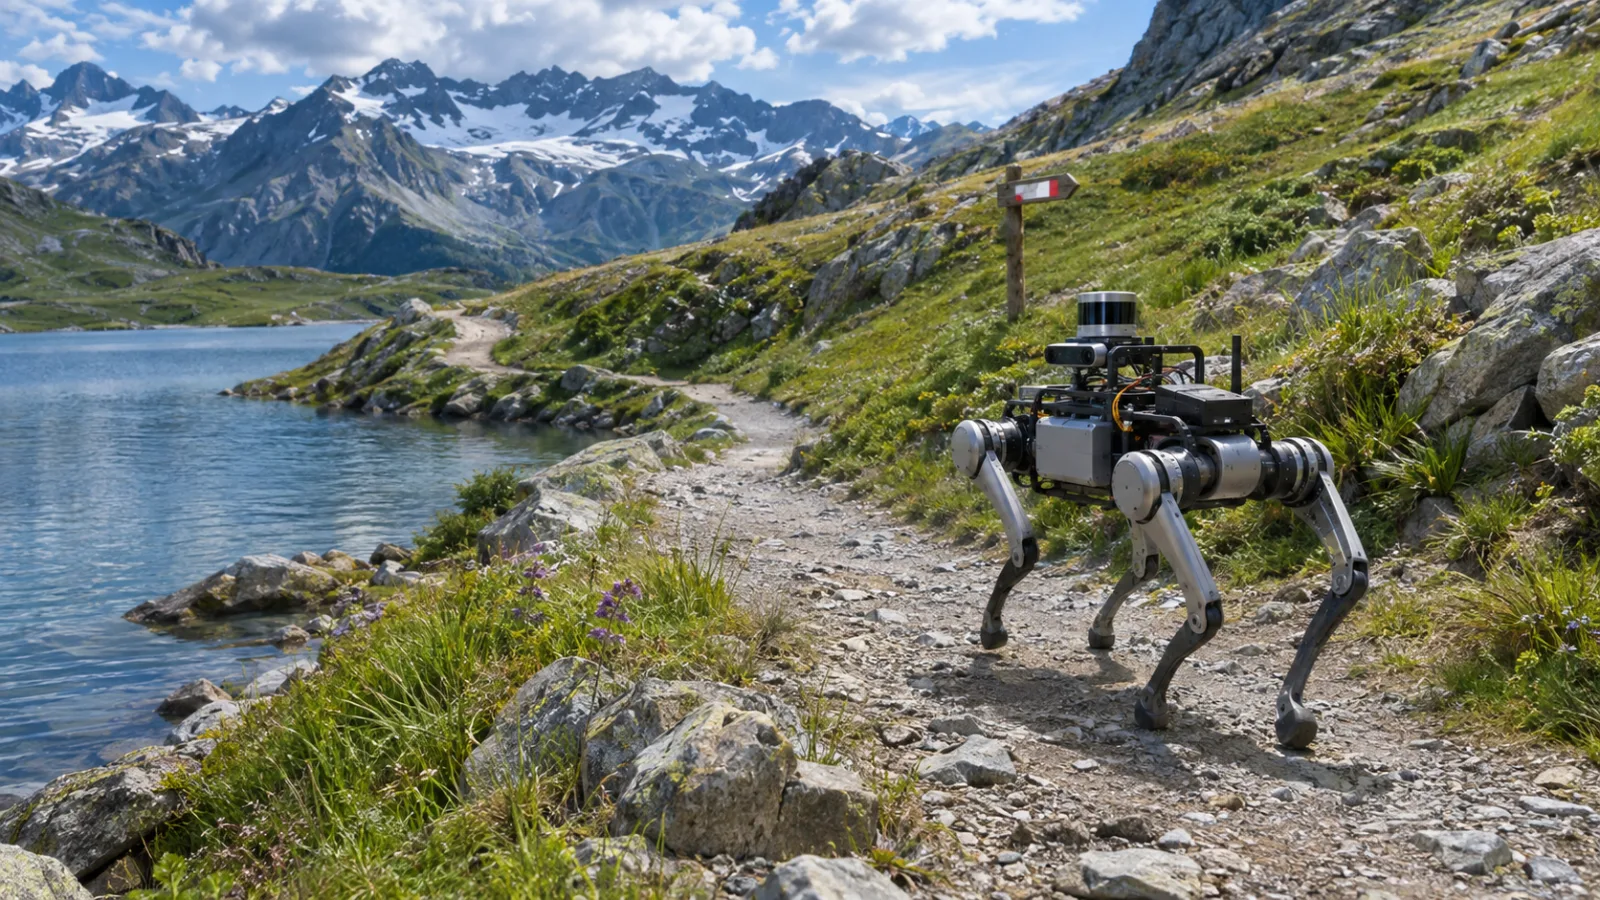
ROAM 建立在明确的分工之上。视觉语言模型负责解读机器人看到的内容——地形、危险、看起来更适合通行的区域以及标志;独立的导航与运动组件则负责将这些判断转化为移动。这个区别很重要,因为识别场景和控制一台行走机器是两个不同的问题。能够描述一条小径、识别一则警告,或比较两种地面,并不意味着模型就能可靠地产生行走指令。
因此,系统并不要求视觉语言模型输出坐标或速度,而是把模型的语义判断用作导航信息。模型为视野中的事物命名,并赋予它们与导航相关的风险值;与此同时,开放词汇分割模块在相机图像中逐像素找出这些类别。最终形成的是一张稠密的实时风险图:每个可见区域都会获得一项关于应当通行还是避开的偏好。ROAM 项目页面 对基本逻辑的描述很直接:模型说明视野中有什么以及风险有多高,机器人再据此决定往哪里走。
这一接口使系统能够表达纯几何视角可能遗漏的区别。问题不只是某块地面看起来是否在物理上可通行。湖泊、危险地表、动物或标志,都可能改变首选路线;即便单靠几何信息无法充分说明为什么应选择某个方向,这些因素仍然会影响决策。在 ROAM 中,这类语义判断会被转换成数值,并与机器人的空间表示融合,而不是停留在无结构的文字回答中。
随后,风险图会为两个预训练的强化学习策略提供条件:一个负责局部导航,另一个负责敏捷运动。这些策略处理流程中快速且精确的部分。论文 将其描述为高层视觉语言推理与低层物理控制的结合;官方代码仓库 则说明,语义图像会被输入高程图,供机器人的导航与运动策略使用。语言模型提供对环境的判断,学习得到的控制栈利用这一判断,同时继续负责路线选择和行走行为。
这种分离很重要,因为“往那边走”这样的原始指令并没有明确物理问题的全部条件。应当优先选择哪种地面?哪些障碍需要避开?看到的标志是否会改变路线?风险图为下游策略提供了结构化答案,同时不要求语言模型预测每一步落脚点、身体动作,或与地面的每次接触。模型负责评估可见场景,而策略仍然负责让移动真正可行。
这种方法也避免把语义感知限制在一份规模很小且固定的类别清单中。由于分割阶段采用开放词汇,系统可以用基于语言的描述识别相关区域,而不必只依赖预先定义的类别。项目材料展示了模型如何为碎石路、草地和奶牛等例子赋值,再将这些标签转换为逐像素地图。具体标签并不是最终动作;它会成为空间代价信号的一部分,供导航系统使用。
不过,两层之间的边界仍应保持清晰。风险图是一个中间判断,并不能保证路线安全。如果语义解释有误,控制器可能会收到关于地形的误导性偏好,或对场景作出错误警告。反过来,即使标签正确,也无法消除在不平整地面上行走时的物理不确定性。ROAM 的设计之所以有用,正是因为它将这些责任分开:语义推理可以影响足式机器人选择前往何处,但不会被当成替代那些让每一步在物理上成为可能的系统。
这使 ROAM 不仅成为对模型能力的研究,也成为对系统组合方式的研究。它的核心问题是:视觉语言模型能否提供足够有用、且具有空间定位的判断,供既有导航与运动策略加以利用。因此,真正值得关注的不是一次孤立的语言模型演示,而是从视觉解读、开放词汇分割和风险估计,到学习式路线选择与行走的完整流程。系统的潜力在于,把广泛的场景理解接入一个已经懂得如何移动的控制栈;难点则在于,当场景含义会影响最安全的路径时,如何确保这种衔接始终可靠。
实地演示究竟证明了什么
ROAM 的实地证据并不止于精心布置的室内障碍场。项目材料显示,这台足式机器人曾在高山步道、森林、草地、道路、室内空间、烟雾环境、铁轨,以及带有标志的城市环境中运行。这种多样性很重要,因为每种场景对“安全”的定义都不同。一条路线在几何上可能畅通无阻,却可能因为穿过高草、接近铁轨、进入烟雾,或被施工标志封闭而不适合通行。因此,这些演示检验的是:在机器人仍负责实际跨越地形行走的同时,语义场景理解能否影响路线选择。(ROAM 项目页面;arXiv 论文)
项目页面重点介绍了两次较长的户外运行:Seealpsee 的 2.4 公里演示,以及 Zermatt 的 10.1 公里演示。这些距离说明系统能够持续执行路线,而不只是成功迈出一步或对视觉输入做出短暂反应。Zermatt 路线包含碎石、岩石、草地、湖畔和铁轨;Seealpsee 路线则沿山湖环线行进。这个结果之所以有意义,正是因为系统必须在整条路线中持续整合不断变化的视觉环境,而不是只对一张孤立图像进行分类。不过,这些运行证明的只是系统在所报告条件下展示出的能力,并不能保证机器人能够在所有类似步道上导航,或正确解读每一个标志。
实地试验也说明,必须谨慎理解“自主”一词。ROAM 被描述为能够在极少干预下完成公里级徒步,较长的视频展示的也是机器人自行执行路线,而非持续接受远程操控。这支持一个具体判断:导航闭环能够利用语义信息决定前进方向,使平台穿越较长的真实环境。但这并不能证明它具备通用自主性、能够在没有监督的情况下无限运行,或能可靠应对每一种感知与控制故障。一次成功演示仍然受到路线、设备、配置,以及测试中所包含情境类型的限制。
要理解这一结果,系统内部的分工是关键。视觉语言模型并不直接驱动机器人的关节。它负责描述可见的地形与危险,赋予其语义风险,并提供信息,再由下游模块将这些信息转化为导航和运动行为。ROAM 将这一语义层与预训练的学习策略结合起来:其中一个用于局部导航,另一个用于运动控制。项目代码仓库将这条流程描述为生成语义图像,并将其与高程图融合,供机器人的导航和运动策略使用。(ROAM 代码仓库)
这种架构也使这些演示具有技术上的信息量。机器人能够依靠学习式控制行走,并不等于它会选择符合社会规范或物理条件的路线。实地案例显示,语义层能够改变原本相似地形的含义。城市标志可能告诉机器人离开当前道路;铁轨可能使路线的一侧更可取;烟雾则会改变决策所依据的视觉条件。在项目展示的室内到户外运行中,同一套系统从建筑物穿过校园区域,继续前往田野、森林步道和农场道路,随着周围环境变化,视觉标签也随之改变。因此,这些证据体现的是系统在不同地点之间保持连续工作的能力,而不只是它在某个经过特别调校的环境中的表现。
预训练策略的作用进一步划定了边界。ROAM 是开放式视觉语言推理与学习型物理控制之间的接口,并不是对运动控制系统的替代。机器人能否稳定迈步,仍取决于为运动训练的策略;语义组件则帮助判断哪些区域应当优先选择、避开,或视为不可落脚区域。实地运行表明,这些组件可以在移动中的足式平台上协同工作。但这并不意味着语言模型能够仅凭原始像素独自理解地形、规划完整路线并控制机身。
综合来看,这些演示确立了一项可信的研究成果:语义引导可以接入足式机器人,使其沿着长达数公里的户外路线行进,并应对自然、城市、室内以及能见度受损等多种场景。少量人工干预和路线完成情况,是系统完成整合的重要证据。但不应据此推断系统已经在所有天气、光照、地形或标志语境下实现稳健自主。更准确的结论是:ROAM 证明,视觉语言模型能够为导航系统提供有用的高层判断,而快速、精确的运动仍由传统建图与学习型控制负责。
语义风险地图为何有用,却仍然脆弱
仅由几何信息构建的地图可以回答一个重要但不完整的问题:机器人在哪些地方能够实际落脚?它可以表示坡度、缝隙、障碍物,以及从形状或深度推断出的其他属性。但仅凭这些信息,它无法可靠表达:为什么两个看起来同样可通行的表面,会对应不同的决策。即使水面看起来平坦,也可能不适合通过。高草可能遮蔽地形,使单靠几何信息难以判断。关闭的步道、警示标志或施工标记,可能改变路线,却不改变眼前地面的形状。在这些情况下,导航问题不只是寻找空闲空间,还要理解这些空间在具体语境中的含义。
这正是 ROAM 语义风险地图设计对读者而言的价值所在。视觉语言模型可以为机器人看到的内容附加与任务相关的意义,而开放词汇分割则能把这种判断投射到空间区域中,不让它停留在一句描述或一个标签上。下游导航策略随后可以把这些区域视为代价较高、值得优先选择或存在风险的区域,同时继续依靠独立的学习型策略完成路线跟随和运动控制。这样的安排让语言模型承担有用的角色,却不要求它计算每一个电机动作。因此,系统能够把场景理解与现有的几何和控制机制结合起来,由后者继续负责运动。
这种区分很重要,因为语义判断天生不如局部物理特征的测量稳定。深度估计或高程变化可以通过机器人传感器和地图进行核验;而标志的含义取决于是否识别出其视觉内容,并将其与路线联系起来。水、植被、烟雾或被阻断的路径究竟意味着什么,则取决于任务,以及机器人需要避开什么。模型可能注意到了相关物体,却赋予错误的优先级、遗漏其中一部分,或在场景变化后无法保留这种区分。风险地图可以让这些判断变得可执行,但它并不会从机制上保证判断正确。
研究人员直接指出了这一可靠性边界。该项目并未被呈现为视觉语言模型已经解决户外导航的证据,论文也讨论了视觉语言推理和空间推理可靠性方面仍待解决的问题。这些局限在一种会把解释转换为稠密空间信号的系统中尤其重要。描述文字中的错误可能会被人类读者直接看见,也容易提出质疑;风险地图中的错误则可能看起来只是普通的导航偏好,导致机器人绕远路、避开本可利用的地面,或未能对相关危险作出反应。将语义推理与控制分开,可以降低要求模型直接输出腿部指令的风险,但并不能免除对语义层进行验证的必要。
因此,与其把 ROAM 视为关于基础模型在真实世界中普遍表现的保证,不如将其理解为一种架构演示。它展示了如何把高层视觉语言判断接入传统建图和学习式运动控制,同时保留这些组件本身。真正悬而未决的问题是:面对不同的光照、视角、地形外观、标志,以及这些线索之间不熟悉的组合时,这种连接能否始终稳定。一次成功的野外路线只能证明完整管线在测试环境中能够运行;它并不能说明环境出现新的歧义时,同样的语义判断仍会可靠。
因此,评估时最值得关注的问题并不只是机器人能否抵达目的地,而是语义地图是否改善了纯几何系统难以处理的决策,以及其中的错误能否被发现并恢复。这需要在测量路线成功率的同时,记录危险和标志识别错误,考察人工干预的频率,并在视觉条件变化后反复测试。还需要通过对照实验拆分收益来源:语义理解带来了什么,预训练的导航与运动控制策略贡献了什么,以及仅凭几何信息能够做到什么。ROAM 让这条边界变得清晰,也让它成为下一阶段研究的核心工程问题。
谁应该关注,以及下一步该测试什么
ROAM 对那些工作于地图更新速度快于地形勘测速度的环境中的团队最有意义。巡检路线、搜救场景、工业场地和户外设施中,都可能存在难以仅用几何信息表达的线索:标志可能要求改变交通方向,某片植被看起来可以通行却并不适合进入,而一条熟悉的路径也可能已经不再是最安全的选择。ROAM 的作用,是让导航系统能够使用这些线索,同时不要求视觉语言模型直接控制机器人的腿部。模型提供语义判断;传统建图以及学习式导航和运动控制策略,仍负责将判断转化为移动。
这种分工也界定了正确的评估方式。一次成功的演示说明机器人能够在执行路线时利用语义信息,但本身并不足以证明它具备通用自主能力。研究演示和项目视频表明,这套架构可以在多种环境中运行,包括小径、森林、草地、道路、室内空间、烟雾环境、铁轨和带有城市标志的场景。它们应被视为对特定系统的测试:该系统由视觉语言模型、开放词汇分割、风险地图构建,以及预训练控制策略共同组成;不应被理解为同样的行为能够不加改变地迁移到每个地点或运行条件。
对实践者而言,首要问题不是基础模型能否抽象地“理解”场景,而是它的判断是否能在纯几何系统产生歧义的节点上改善机器人的决策。评估应报告干预率,并说明干预具体意味着什么:人工纠正、路线停止、恢复行为,还是改选路径。标志、危险、偏好地形和禁入区域相关的错误,也应分别测量。综合成功率可能掩盖一个关键区别:无害的语义错误,与把机器人引向危险区域或封闭区域的错误,并不是一回事。
评估还应覆盖语义感知最可能发生变化的条件。天气和光照需要明确纳入测试,视角变化也一样,尤其是那些会让标志或危险部分被遮挡的视角。可重复性同样重要:同一路线应测试多次,避免把结果归因于一连串有利的观测。研究人员和采购方还应记录机器人平台、传感器、运行系统所需的计算资源,以及哪些能力来自预训练策略。这些细节决定了报告中的行为能否复现,也决定了这套架构能否脱离某一套特定的软硬件配置而被独立评估。
几何信息基线不可或缺。没有它,就无法判断性能提升究竟来自视觉语言组件,还是来自路线设计、参数调优或底层运动策略。比较应采用相同的平台和大体可比的传感配置,随后考察语义风险地图在何处改变了机器人选择的路线,以及这些改变是否减少了人工干预或危险判断错误。同样重要的是,必须记录语言模型不确定、空间定位不精确,或干脆判断错误的情况。研究人员指出,可靠性和空间推理仍是持续存在的局限,因此这些失败本身就是结果的一部分,而不是可以删去的不便例外。
更广泛的启示应当以审慎而非革命性的方式理解。ROAM 在高层语义判断与底层物理控制之间提供了一个可信接口:语言引导的感知可以影响腿式机器人前往何处,而学习得到的运动控制仍负责决定它如何行走。下一步不是取消这种分工,而是系统地检验它的边界——覆盖不同路线、环境条件、硬件和基线。如果未来评估显示,在传感与计算需求不过度增加的前提下,系统能够降低人工干预率,并减少具有后果的标志或危险判断错误,那么这一架构可能成为应对变化环境的导航方案之一。在此之前,它最有力的主张反而更具体,也更有价值:语义风险地图为把“意义”加入地形感知导航提供了一条切实可行的研究路径,同时也把可靠物理自主这一难题留在原处。
Related articles
The distracted dog walk: how to protect wildlife, livestock and your dog without ruining the outing
A new University of Surrey study links missed dog waste, wildlife disturbance and livestock encounters to divided attention. Here is a practical way to make walks safer, calmer and easier to manage.
Home Assistant 2026.9’s Matter Map Is Most Useful Before You Buy Another Thread Device
Home Assistant 2026.9 adds a Matter network map that can expose weak links, missing border-router paths, and Wi-Fi assumptions. Here is what it can tell you, what it cannot, and how to use it before expanding a Thread setup.
Halloween and Pets: A Calm, Practical Safety Plan for Candy, Costumes, Doors and Decorations
Halloween changes a home in ways pets may find confusing: open doors, unfamiliar visitors, tempting food and chewable decorations. A few simple preparations can prevent poisoning, escapes and unnecessary stress without excluding animals from the evening.
Comments
Sign in to comment.
No comments yet.