Serve Robotics ouvre sa flotte de livraison aux développeurs — mais l’API n’est pas encore un service robotique
Serve Robotics ouvre sa flotte de livraison via une API publique et un bac à sable. Le véritable test consiste à voir si l’accès logiciel peut transformer des robots de trottoir en infrastructure locale fiable, malgré une couverture, une supervision et une validation en direct strictement contrôlées.
Ce que Serve a réellement ouvert le 11 novembre
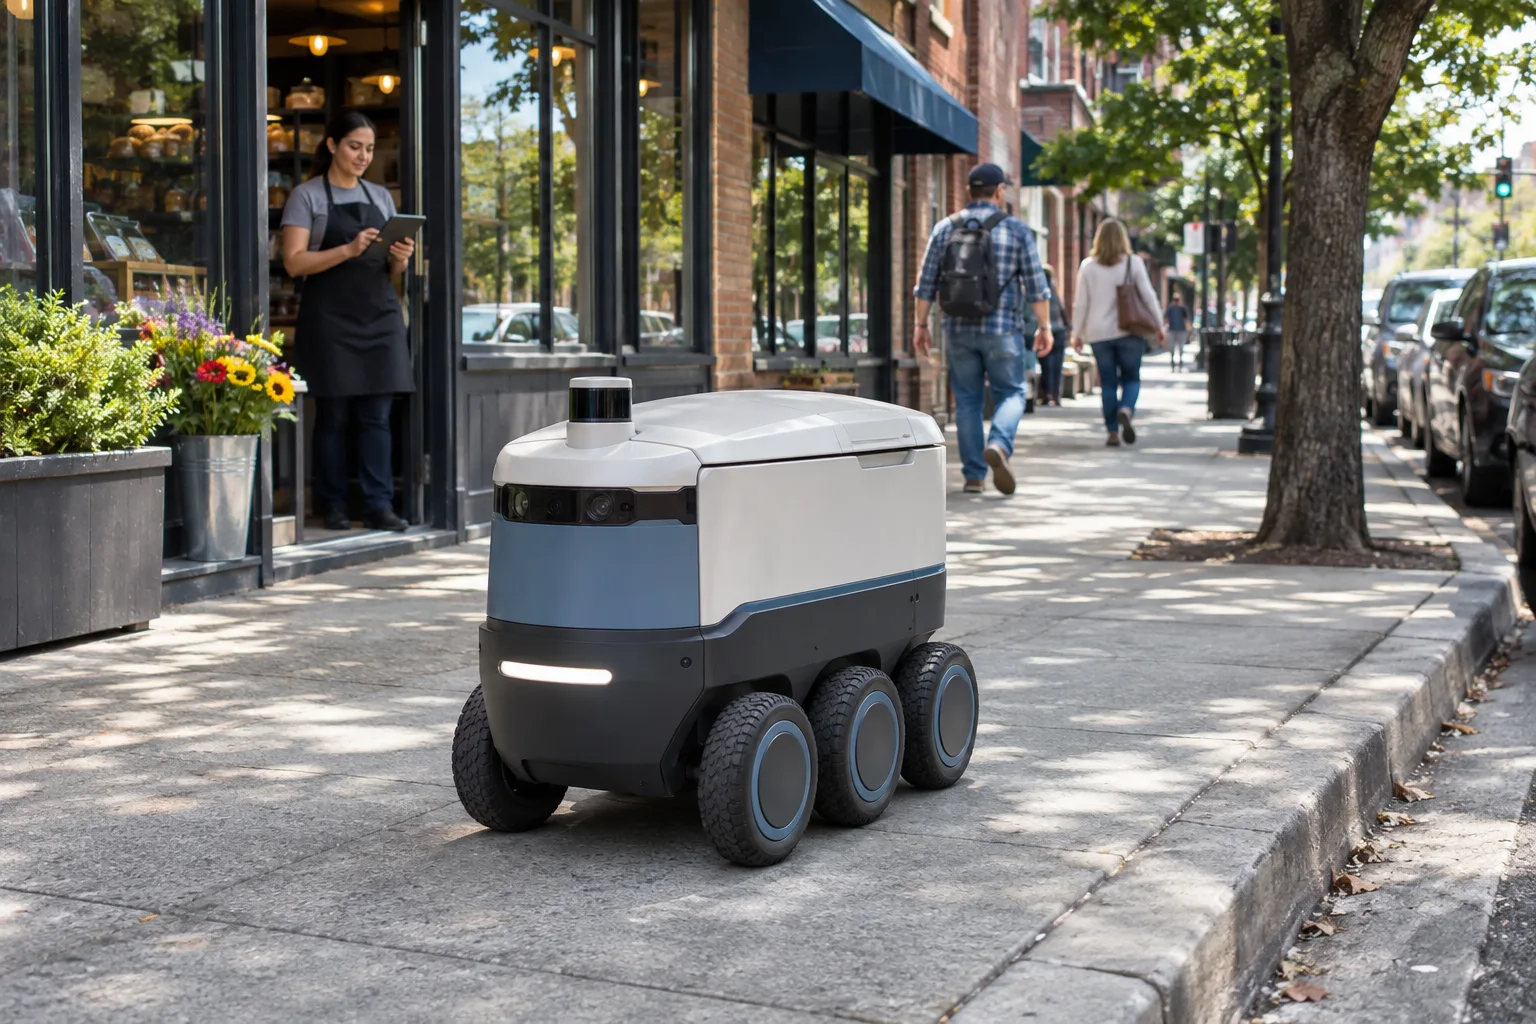
Le lancement de Serve Robotics, le 11 novembre, doit être compris comme une nouvelle couche d’accès logiciel ajoutée à une opération de livraison existante, et non comme la mise à disposition d’un robot que les développeurs pourraient contrôler de manière indépendante. L’entreprise a ouvert son portail développeur AV Delivery, avec une API publique, de la documentation et un bac à sable destinés aux développeurs, aux entreprises, aux passionnés et aux assistants d’IA. Le principe est simple : une application peut demander au réseau de Serve de prendre en charge un retrait et une livraison, confirmer les détails, puis suivre la course jusqu’à son achèvement. Le travail physique reste intégré au système d’exploitation de Serve. Le développeur fournit le cas d’usage et la connexion logicielle ; Serve fournit la flotte et toute la machinerie opérationnelle qui la fait fonctionner.
Cette distinction compte, car l’annonce emploie le vocabulaire de l’infrastructure tout en maintenant les limites d’un service géré. Serve affirme que son réseau comprend 2 000 robots opérant dans plus de 150 quartiers répartis sur 20 villes américaines, et que ces robots ont effectué des centaines de milliers de livraisons. Jusqu’à présent, l’accès à ce réseau passait par des partenaires de livraison tiers. Le nouveau portail change les acteurs qui peuvent concevoir et développer un flux de livraison, mais il ne transforme pas la flotte en plateforme robotique ouverte. Un développeur peut écrire l’intégration qui demande une livraison. Serve décide toujours si la demande en conditions réelles sera traitée, et de quelle manière.
Le bac à sable public est le moyen le plus clair de voir ce qui est effectivement devenu disponible. Il comprend des robots simulés, des clés API de test, un espace Playground, de la documentation et des outils associés. Un développeur peut répéter le parcours d’une livraison et explorer les cas limites sans envoyer de véhicule réel dans un quartier. Selon les conditions du bac à sable, aucune opération qui y est effectuée ne déclenche un robot réel ni ne crée une véritable livraison. Elles précisent également que l’accès au bac à sable ne donne pas accès à la production, aux livraisons réelles ni à un partenariat avec Serve. Pour aller au-delà de l’environnement de test, il faut obtenir l’accord de Serve et conclure un accord de production écrit distinct.
Le portail reste donc utile avant même qu’une seule course d’un tiers n’atteigne un trottoir. Il offre aux concepteurs un espace pour tester la manière dont une application recueillerait les informations de retrait et de livraison, confirmerait la demande et en suivrait l’avancement. Il permet aussi de découvrir les éléments qu’une transaction physique apparemment simple exige en plus d’un appel API : les bons emplacements, un créneau de livraison disponible, un article qui tient dans le robot et un destinataire capable d’effectuer la remise. Le flux simulé peut faire apparaître ces questions d’intégration, mais il ne peut pas, à lui seul, établir qu’un trajet réel sera disponible ou qu’il se déroulera de la même manière.
Le rôle de Serve est volontairement étendu. Selon l’annonce de l’entreprise et ses documents destinés aux développeurs, elle conserve la responsabilité de la répartition des courses, du calcul des itinéraires, de la navigation et de la supervision. Les robots envoyés via l’API restent soumis aux mêmes normes d’exploitation que les autres livraisons de Serve, notamment la surveillance à distance par des superviseurs formés et les systèmes de sécurité intégrés à chaque véhicule. Les livraisons réelles sont également limitées aux zones où Serve est active, à ses heures d’exploitation et aux articles qui tiennent dans le compartiment de chargement du robot. Autrement dit, l’API expose une interface de demande et de suivi pour l’opération de livraison ; elle n’expose pas la pile de navigation sous-jacente et n’accorde aucun contrôle sur les déplacements du robot.
Les conditions juridiques du bac à sable confortent cette lecture. L’accès est accordé à la discrétion de Serve, peut être limité ou interrompu, et est fourni pour évaluer Serve et construire une intégration avec son API de livraison. Les utilisateurs ne peuvent pas partager leurs clés API, contourner les limites de débit, procéder à de l’ingénierie inverse ou surcharger le bac à sable, publier des résultats de performance sans consentement écrit, ni utiliser l’environnement pour créer ou entraîner un produit ou un modèle concurrent. Ils sont responsables des activités menées par leurs applications, scripts, automatisations ou agents d’IA. Les règles relatives aux données de test interdisent également de transmettre de vrais noms, numéros de téléphone, adresses ou autres informations personnelles. Il ne s’agit pas des conditions d’un service public sans restriction, mais des garde-fous qui encadrent un programme développeur en accès anticipé.
Le changement concret n’est donc pas que n’importe qui puisse faire venir un robot à la demande, quelles que soient les conditions. C’est que davantage de personnes peuvent commencer à concevoir des services autour d’une capacité de livraison que Serve exploite déjà. Les exemples donnés par l’entreprise comprennent un commerce local qui livre directement ses clients, une société qui déplace des fournitures entre ses bureaux et un assistant d’IA qui coordonne une livraison réelle. Ils décrivent le type de flux de travail que le portail est censé prendre en charge, sans prouver que chaque cas d’usage est déjà disponible partout ni qu’il a été validé en production. Le premier test consiste à voir si des concepteurs de logiciels peuvent transformer ce service limité et supervisé en applications fiables sans devoir construire eux-mêmes une flotte.
Le robot reste un service géré, pas une machine ouverte
L’ouverture de Serve aux développeurs est significative précisément parce qu’elle ne va pas jusqu’à leur donner le contrôle direct d’un robot de trottoir. L’interface publique constitue une couche d’accès logiciel posée sur une opération de livraison que Serve continue de piloter. Un développeur peut créer une intégration autour du flux de livraison, mais l’entreprise conserve les décisions opérationnelles qui déterminent si une mission physique est exécutée, et de quelle manière.
Cette répartition est importante. La documentation de l’API de Serve décrit un flux dans lequel une application peut demander un devis de livraison, créer une mission et suivre son statut. Ce sont des fonctions utiles pour un commerçant, un système de gestion de bureaux ou un agent logiciel qui doit déplacer un objet d’un endroit à un autre. Ce ne sont pas des commandes permettant de prendre la main sur la navigation, de choisir un itinéraire ou d’attribuer un robot précis. L’API expose la transaction et son état ; elle ne transforme pas le robot en machine ouverte.
Serve conserve de son côté l’affectation des missions, le calcul des itinéraires, la navigation et la supervision à distance. Concrètement, le développeur doit présenter la demande de livraison et gérer les états logiciels qui en découlent, tandis que Serve reste responsable de l’exploitation de la flotte dans le monde physique. Cela comprend les décisions et les interventions nécessaires entre l’acceptation de la demande et la remise terminée. La distinction peut facilement passer inaperçue dans un portail pour développeurs : un point d’accès peut donner à une action physique l’apparence d’un simple appel de fonction, mais cet appel n’efface pas le service géré qui se trouve derrière.
Le bac à sable confirme cette limite. Il permet aux développeurs d’exercer le flux de l’API avec des robots simulés, mais aucune opération effectuée dans cet environnement n’envoie un robot réel ni ne crée une livraison réelle. Un devis, une mission ou une transition de statut simulés peuvent aider une équipe d’ingénierie à valider l’authentification, le format des requêtes, la logique de l’application et la gestion des erreurs. Ils ne peuvent pas démontrer que la même demande sera acceptée dans un quartier donné, à une heure précise, pour un article particulier ou dans les mêmes conditions d’exploitation sur le réseau réel. Le bac à sable teste la surface d’intégration ; l’exploitation de Serve en production détermine ce qui peut se passer au-delà.
Les conditions d’utilisation du bac à sable explicitent cette séparation : son accès ne donne ni accès à la production, ni livraisons réelles, ni partenariat avec Serve. L’utilisation en production nécessite un accord écrit distinct. L’accès aux robots en service est également soumis à l’approbation de Serve. Le portail constitue donc une invitation à développer et à évaluer une intégration, pas une voie inconditionnelle vers la flotte. Un développeur peut apprendre publiquement le fonctionnement de l’interface et préparer une application, tandis que l’accès aux robots réels reste soumis à l’examen de Serve et aux conditions qui encadrent l’utilisation en production.
Les contraintes sont aussi physiques que contractuelles. Les livraisons sont limitées aux zones de service actives de Serve et à ses horaires d’exploitation, et l’article doit tenir dans le compartiment de chargement du robot. Les documents de l’entreprise décrivent une disponibilité correspondant au réseau qu’elle exploite, et non une couverture géographique universelle. Une application ne peut donc pas supposer qu’une adresse est desservie simplement parce qu’elle peut être inscrite dans une requête, ni qu’une mission peut être programmée chaque fois qu’un client ou un salarié le souhaite. La couverture et les créneaux disponibles font partie du périmètre opérationnel du service ; ce ne sont pas des paramètres qu’un développeur externe peut modifier.
La capacité de chargement constitue une autre limite concrète. La flotte de robots est destinée aux livraisons qui restent dans les limites physiques documentées. Une intégration doit donc tenir compte de l’adéquation du colis, au lieu de considérer le robot comme un coursier générique. Une demande peut être valide du point de vue logiciel tout en étant incompatible avec le service de livraison disponible si l’article ne rentre pas. Une intégration solide doit par conséquent gérer explicitement les demandes indisponibles, refusées ou impossibles à exécuter ; un appel API réussi ne signifie pas qu’une livraison physique a abouti.
Il en résulte un modèle de responsabilités à plusieurs niveaux. Le développeur peut prendre en charge le parcours destiné au client ou aux équipes internes : recueillir les informations de retrait et de dépôt, demander un devis, afficher les disponibilités, lancer la course et communiquer son état. Serve prend en charge la couche liée à la flotte : affectation, exécution de l’itinéraire, navigation et supervision à distance. Cette séparation permet aux équipes logicielles de construire autour d’un service physique sans exploiter elles-mêmes les robots. Elle signifie aussi qu’elles ne peuvent pas modifier indépendamment la zone couverte, prolonger les horaires, choisir des itinéraires arbitraires ni garantir que chaque étape de leur workflow logiciel correspondra proprement à une action effectuée par un robot en service.
Cette distinction devrait guider l’évaluation du lancement. Serve ouvre la possibilité de créer une intégration avec son réseau de livraison ; l’entreprise ne met pas à disposition une plateforme robotique généraliste dont les machines pourraient être programmées à volonté par les développeurs. Pour ces derniers, le véritable test consiste donc moins à vérifier qu’une commande peut atteindre un robot qu’à déterminer si leur logiciel sait se comporter correctement lorsque le réseau répond non, ne couvre pas la zone demandée, atteint une limite de capacité ou nécessite l’intervention de l’opérateur. Tant que ces situations ne font pas partie de la conception, une connexion API reste la façade d’un service géré.
Pourquoi l’API compte pour les commerces locaux et les agents IA
L’intérêt pratique du portail développeur de Serve ne tient pas au fait qu’une entreprise pourrait soudainement acheter ou contrôler un robot de trottoir. Il tient à la possibilité, pour un commerçant, un bureau, un développeur ou un assistant IA, de commencer à tester un parcours de livraison physique sans constituer une flotte, recruter une équipe de robotique ou résoudre séparément la navigation dans chaque quartier. Serve décrit une application qui demande un retrait et un dépôt, confirme les détails de la livraison, puis suit le robot jusqu’à l’achèvement. Cela crée un point d’entrée logiciel pour une tâche qui dépendait auparavant de la relation existante entre une plateforme de livraison et le réseau de robots.
Pour un commerce local, le cas d’usage le plus évident est le retrait en magasin ou la livraison de produits provenant de son propre stock. Serve évoque aussi les entreprises qui déplacent des fournitures entre leurs bureaux et les sociétés locales qui étendent leur périmètre de livraison sans recruter de personnel supplémentaire. Ce sont des applications plausibles de l’interface, mais il faut les considérer comme des possibilités de conception, pas comme la preuve de déploiements tiers déjà établis. Le portail permet de prototyper le parcours ; il ne démontre pas, à lui seul, qu’un commerçant donné a obtenu un service fiable, une adoption par ses clients ou une économie favorable.
Cette nuance compte, car une livraison physique comporte davantage de points de défaillance que ne le laisse penser une requête API. Un système logiciel peut envoyer les informations de retrait et de dépôt, mais les marchandises doivent encore être préparées, déposées au bon endroit pour la remise et disponibles à l’arrivée du robot. Le destinataire doit pouvoir être joint à destination, et la livraison peut devoir être coordonnée avec les procédures d’un magasin, d’un bureau ou d’un service client. Si un article manque, si un retrait prend du retard, si la destination est inaccessible ou si le destinataire ne peut pas effectuer la remise, l’application doit pouvoir détecter le problème et décider de la suite. L’API peut exposer le parcours de livraison ; elle ne supprime pas le fonctionnement opérationnel qui l’entoure.
C’est particulièrement important pour les agents IA. En théorie, un assistant pourrait coordonner une demande dans le monde physique : identifier un lieu de retrait et un lieu de dépôt, envoyer la commande et surveiller son état. Mais un agent qui agit au moyen d’une clé reste responsable des actions qu’il entreprend. Les conditions d’utilisation du bac à sable de Serve attribuent explicitement à l’utilisateur qui l’exploite la responsabilité d’une application, d’un script, d’une automatisation ou d’un agent IA, et interdisent l’utilisation de véritables informations personnelles lors des tests dans le bac à sable. Celui-ci sert donc à répéter la logique d’une intégration de livraison, tout en montrant clairement qu’une demande automatisée ne constitue pas une activité commerciale autonome.
Le bac à sable est donc utile moins comme une flotte miniature que comme un espace où tester des hypothèses. Les développeurs peuvent parcourir la séquence de création et de suivi d’une livraison avec des robots simulés, puis examiner les cas limites avant de demander l’accès à un robot réel. Ils peuvent repérer les étapes où leur propre application doit gérer une confirmation, un changement de statut, une exception ou une intervention humaine. Les conditions précisent toutefois que rien, dans le bac à sable, ne dépêche un robot réel ni ne crée une livraison réelle, et que les résultats simulés, les prix, les délais estimés, les itinéraires et les réponses générées par l’IA peuvent ne pas refléter les performances ou la disponibilité dans le monde réel. Un test réussi montre que l’intégration sait communiquer avec l’environnement de test. Il ne valide pas l’ensemble du service auquel serait confronté un client.
C’est dans l’écart entre ces deux réalités que se trouve le travail opérationnel. Serve conserve la gestion des courses, des itinéraires, de la navigation et de la supervision ; le concepteur ne dirige donc pas directement les déplacements du robot. Cette séparation est intéressante pour une petite entreprise : elle réduit les compétences en robotique nécessaires pour expérimenter. Elle signifie aussi que l’entreprise dépend d’un service dont la disponibilité est régie par la couverture active de Serve, ses horaires d’exploitation, les limites de chargement, le processus d’approbation et le modèle de supervision. Un commerçant peut concevoir un parcours client soigné tout en voyant sa demande échouer si le point de collecte ou de dépôt ne respecte pas les conditions du service, si l’article ne rentre pas dans le robot ou si l’accès en direct n’a pas été approuvé.
À court terme, la valeur de l’API tient donc surtout à son rôle de couche d’intégration et de test opérationnel. Elle permet aux entreprises et aux développeurs de vérifier si la livraison robotisée s’intègre à un flux de travail donné : où se produisent les relais, quels événements nécessitent l’intervention d’une personne, comment les exceptions sont transmises au support et si le service physique peut être présenté clairement au client. Elle offre aussi aux concepteurs d’agents d’IA une surface contrôlée pour expérimenter des actions qui passent du logiciel à la rue. La question importante n’est pas de savoir si quelques lignes de code peuvent demander un robot. Il s’agit de déterminer si l’activité autour de cette demande peut préparer, réceptionner, surveiller et gérer de manière fiable la livraison qu’elle déclenche.
Les éléments encore manquants avant d’en faire une infrastructure
Un portail développeur public peut prouver qu’un logiciel peut accéder à un flux de livraison robotisée. Il ne peut pas, à lui seul, prouver que ce flux est assez fiable pour jouer le rôle d’une infrastructure. C’est la distinction qui constitue le véritable test du lancement de Serve. L’entreprise décrit un réseau de plus de 2 000 robots, tandis que ses ressources destinées aux développeurs exposent un bac à sable et un parcours centré sur une API pour demander et suivre des missions de livraison. Ces éléments établissent l’accès à un système opérationnel et la possibilité d’expérimenter. Ils ne démontrent pas qu’une application externe peut dépendre de ce service comme elle dépendrait d’une plateforme mature de paiement, de cartographie ou de logistique.
Les preuves manquantes commencent par la question commerciale la plus simple : combien coûte une livraison effectuée, et dans quelles conditions ? Un développeur ne peut évaluer une intégration que si le service affiche un tarif de production clair, une zone desservie définie et une procédure de compte ou d’approbation compréhensible. Les documents de lancement présentent l’usage réel comme contrôlé plutôt que disponible pour tous ; une demande acceptée dans le bac à sable ne prouve donc pas que la même demande sera acceptée par une flotte en production. Un tarif public rendrait cette limite mesurable. Sans lui, un développeur peut tester la forme d’une interaction, mais pas déterminer si le robot est viable pour un commerçant, un bureau ou une autre activité locale.
La question suivante est de savoir si des demandes de tiers ont effectivement abouti de bout en bout. Le portail permet de construire l’intégration autour du flux, mais la preuve pertinente ne consiste pas seulement à vérifier qu’une API peut renvoyer un devis ou accepter une mission. Une plateforme devient concrètement exploitable lorsqu’une application externe peut passer de façon répétée de la demande à la collecte, puis à la remise, avec des réponses prévisibles lorsqu’une mission est refusée, retardée, réacheminée ou impossible à terminer. Les documents publics de Serve n’indiquent ni le nombre de livraisons effectuées par l’API pour des tiers, ni un bilan comparable concernant des utilisateurs en conditions réelles. Cette absence ne rend pas le lancement insignifiant ; elle signifie qu’il faut le comprendre comme une invitation à produire ces éléments de preuve, et non comme la preuve qu’ils existent déjà.
La fiabilité doit aussi être mesurée à l’échelle des itinéraires. Un réseau peut sembler impressionnant dans son ensemble tout en fonctionnant très différemment d’un quartier à l’autre. Des indicateurs utiles montreraient les taux de livraison réussie par zone de service, créneau horaire et type de mission, ainsi que les annulations et les transmissions de colis échouées. Ils indiqueraient également à quelle fréquence une intervention humaine à distance est nécessaire. Serve conserve la responsabilité de l’affectation, du routage, de la navigation et de la supervision à distance, ce qui constitue une manière cohérente d’exploiter un service robotisé géré. Mais cette organisation fait des taux d’intervention un élément de l’économie du produit. Une livraison nécessitant peu d’intervention humaine et une autre qui en exige plusieurs peuvent sembler identiques à l’appelant de l’API, tout en représentant des coûts très différents pour l’opérateur.
L’économie unitaire compte donc autant que l’autonomie. La question n’est pas seulement de savoir si un robot peut aller d’un point à un autre, mais si le coût cumulé de l’exploitation de la flotte, de la supervision, de la maintenance, de l’assistance et des tentatives échouées ou répétées permet de proposer un service reproductible. Le lancement ne fournit pas assez d’informations pour répondre. Il ne précise pas non plus combien d’utilisateurs réels dépendent de l’API. Ces chiffres aideraient à distinguer une expérimentation destinée aux développeurs d’une plateforme bénéficiant d’une demande externe durable, et à déterminer si l’API devient une source d’activité significative pour la flotte ou reste principalement un test encadré.
Le bac à sable est utile parce qu’il réduit le coût de ces interrogations. Il offre aux développeurs un espace pour examiner le fonctionnement et concevoir leurs logiciels avant de dépendre de la couverture réelle. Mais un simulateur peut démontrer qu’une intégration est bien conçue sans rien résoudre des contraintes physiques : l’adresse est-elle desservie ? La demande entre-t-elle dans les horaires d’exploitation ? Le chargement tient-il dans la capacité annoncée ? La remise du colis aboutit-elle ? Et que se passe-t-il lorsque le service ne peut pas approuver la mission ? Ce ne sont pas des détails périphériques de l’API. Ils déterminent si celle-ci correspond à un service local réellement utilisable.
C’est pourquoi il faut interpréter avec prudence le nombre de robots et le portail très abouti. Plus de 2 000 robots témoignent d’une certaine échelle opérationnelle, tandis qu’un bac à sable public montre la volonté de rendre cette échelle compréhensible aux développeurs. Aucun de ces indicateurs ne dit avec quelle régularité une entreprise indépendante peut obtenir une livraison, combien elle la paiera ni quelle quantité de travail humain reste nécessaire en coulisses. L’affirmation d’une infrastructure ne devient crédible que lorsque l’usage par des tiers produit des éléments vérifiables et reproductibles : des missions réalisées en production, une fiabilité mesurée par itinéraire, les taux d’intervention, une tarification transparente et une population visible de clients ou d’applications actifs.
Serve a établi une séparation importante entre son réseau physique et les logiciels externes. La prochaine étape ne consiste pas simplement à ajouter des points d’accès ou à élargir son public de développeurs. Il faut démontrer que cette séparation fonctionne sous la pression commerciale ordinaire, dans les zones limitées et les conditions d’exploitation où le service est disponible. Tant que ces résultats ne sont pas établis, la description la plus exacte reste plus circonscrite : Serve a rendu son système de livraison géré accessible aux développeurs afin qu’ils puissent le tester et l’intégrer. C’est une étape importante vers une infrastructure robotisée, mais il s’agit encore de vérifier si cet accès peut devenir un service fiable.
Related articles
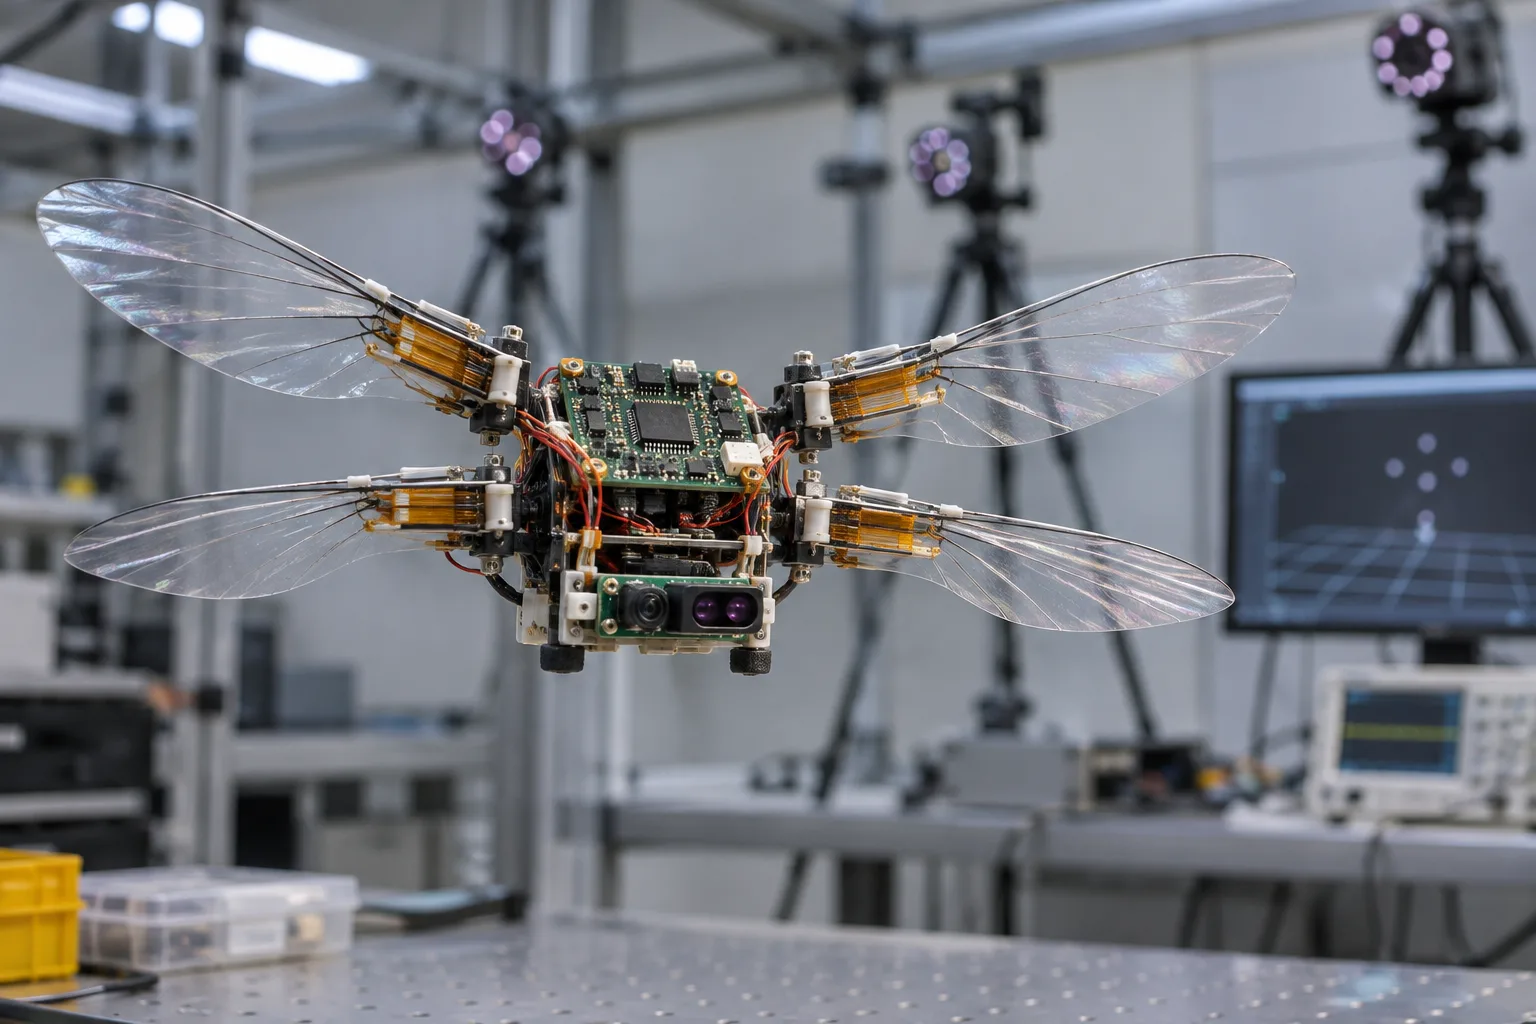
Le robot volant de la taille d’un insecte du MIT apprend à se diriger avec ses propres capteurs et son ordinateur
Des chercheurs du MIT ont embarqué la détection et le contrôle du vol sur un robot à ailes battantes léger comme un trombone. Il peut rester en vol stationnaire et suivre de courtes trajectoires sans caméras de capture de mouvement, mais dépend encore d’une alimentation externe et d’instructions humaines.
Le succès viral de Microduck transforme un bipède à 399 $ en test de l’apprentissage robotique accessible
Le Microduck de Pollen Robotics est petit, abordable selon les standards de la robotique et ouvert côté logiciel. L’explosion des précommandes après le keynote de NVIDIA à Berlin pose une question plus utile que celle de son apparence : peut-il devenir une plateforme pratique pour apprendre l’IA physique ?
Qualcomm’s PickNik Deal Puts Open Robot Motion Planning at the Center of Physical AI
Qualcomm’s planned acquisition of PickNik is less about buying a robot than owning a critical layer beneath many of them. The outcome will depend on whether MoveIt can gain hardware acceleration without losing the openness that made it useful.
Faraday Future’s 919 Robot Launch Tests Whether a Portfolio Can Become a Deployment Business
Faraday Future is using its September 19 launch to present humanoids, quadrupeds, mobile manipulators, and industry packages as one robotics platform. The important question is not how many forms it shows, but whether customers can operate and measure them beyond a demonstration.
Comments
Sign in to comment.
No comments yet.