Auto Ontology de NVIDIA convierte los metadatos empresariales en una capa de contexto para agentes: qué está listo para probar
El nuevo proyecto Auto Ontology de NVIDIA, bajo Apache-2.0, busca mejorar las consultas de agentes al hacer explícitas las definiciones empresariales, la procedencia, las relaciones y el linaje. La cuestión práctica es si encaja con una pila de datos real.
Qué publicó NVIDIA y qué pretende hacer la capa de ontología
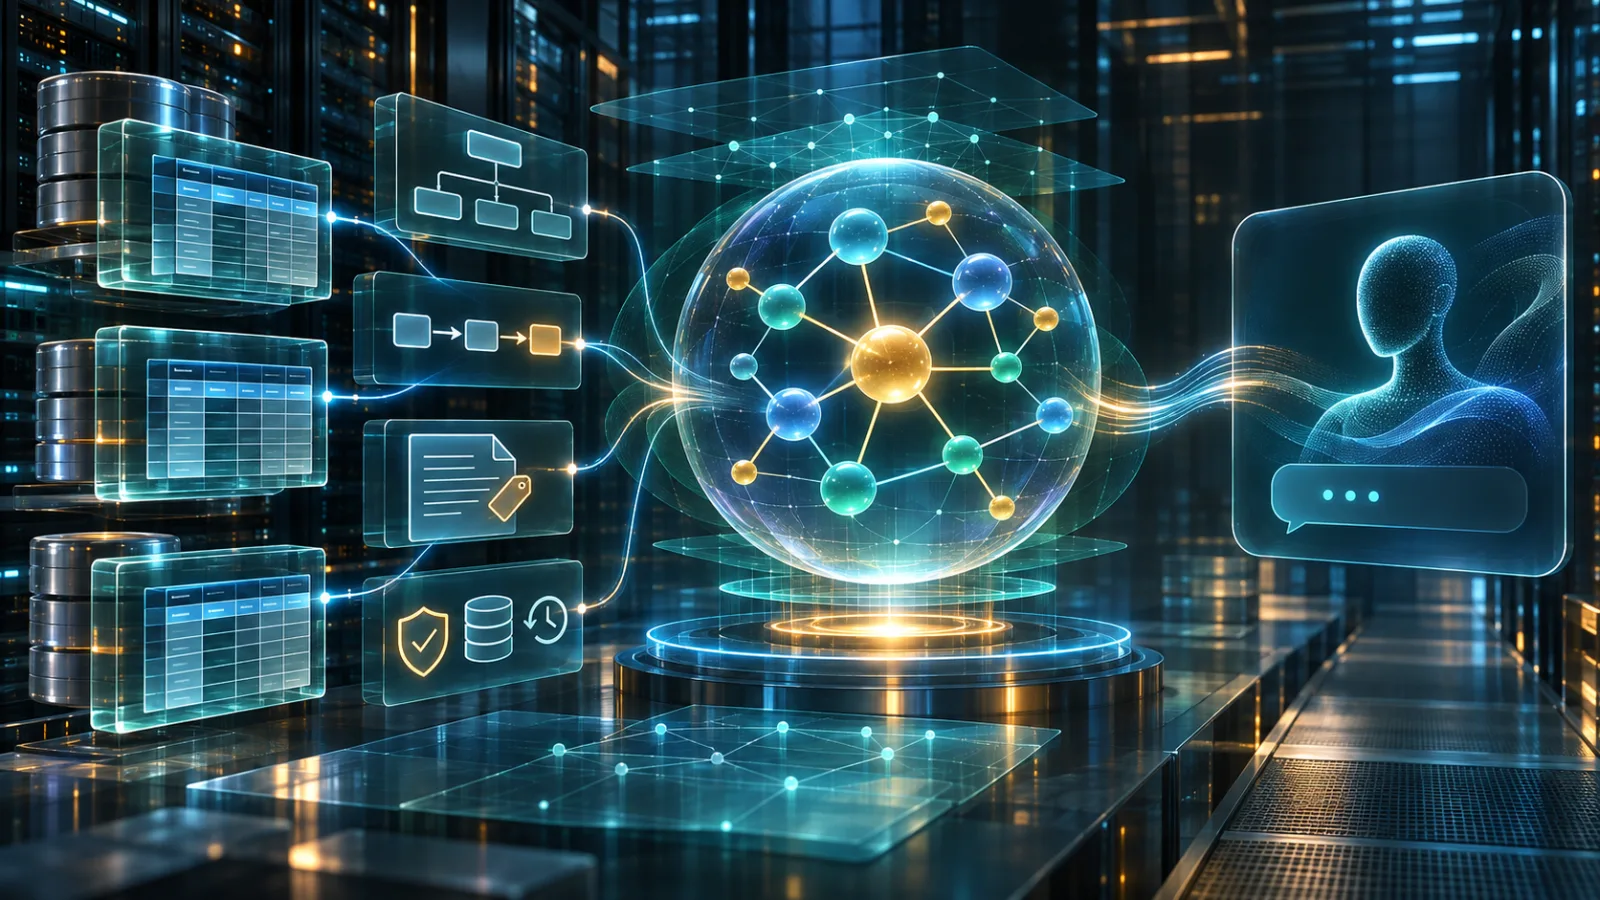
NVIDIA Auto Ontology se presenta como un framework de Python bajo licencia Apache-2.0 para convertir los metadatos empresariales en una capa de contexto estructurada para agentes de datos. Su propósito no es sustituir a un modelo de lenguaje, una base de datos ni un catálogo de datos convencional. En cambio, se sitúa entre esos sistemas: reúne información sobre tablas, columnas, definiciones empresariales, relaciones, linaje y procedencia, y después la organiza para que un agente pueda utilizarla al interpretar una pregunta y elaborar una consulta analítica.
Esa distinción importa porque un agente puede producir SQL sintácticamente válido y, aun así, interpretar mal el significado empresarial de una solicitud. Una base de datos puede contener varias versiones de los datos de ingresos, clientes, envíos o actividad, cada una con distintos límites temporales y responsables. Un modelo que solo ve nombres de tablas y descripciones de columnas puede elegir un campo plausible sin saber qué definición está certificada, cómo se deriva una métrica o qué sistema ascendente es la fuente autorizada. Auto Ontology pretende hacer explícitas esas conexiones, en lugar de dejarlas a las asociaciones inferidas por el modelo.
El repositorio describe un framework capaz de generar ontologías empresariales a partir de metadatos o conectarse a ellas, además de conciliar definiciones entre sistemas. En términos prácticos, la ontología es una representación legible por máquinas de los conceptos de datos de una organización y de sus relaciones. Puede asociar un término empresarial con estructuras de datos físicas, conectar entidades relacionadas, conservar el linaje y retener la procedencia necesaria para entender de dónde surgió una definición o relación. El resultado se parece más a un mapa semántico gobernado que a una colección de documentos recuperados para incluirlos en un prompt.
Auto Ontology también expone este contexto mediante varias interfaces. El proyecto incluye una aplicación web, una API, una interfaz de línea de comandos y una integración con MCP pensada para entornos de agentes. Estas interfaces ofrecen distintos puntos de entrada al mismo flujo general: ingerir metadatos, construir o revisar la ontología y poner su información semántica a disposición de las aplicaciones que necesitan responder preguntas sobre datos. MCP resulta especialmente relevante para los equipos que ya prueban agentes capaces de usar herramientas, porque permite que un entorno de agentes externo invoque capacidades respaldadas por la ontología, en lugar de incrustar todo el catálogo y el proceso de razonamiento en un prompt.
Por tanto, la arquitectura compatible separa dos preocupaciones. Una es el entorno de datos empresarial: las bases de datos, los esquemas, los sistemas de metadatos y las definiciones con los que el proyecto se conecta o que ingiere. La otra es la capa de ontología y razonamiento que interpreta esas entradas y presenta el contexto pertinente a un agente. Mantener separadas ambas preocupaciones resulta útil desde el punto de vista operativo. Una capa de ontología puede describir una fuente sin convertirse en la fuente misma, y puede ayudar a un agente a recorrer varios sistemas sin exigir que cada regla empresarial se redescubra a partir de la estructura bruta de la base de datos.
Por eso Auto Ontology no debería evaluarse como un producto genérico de búsqueda vectorial. La recuperación semántica puede formar parte de una implementación, pero el valor declarado del proyecto depende de las relaciones estructuradas y de los metadatos, no simplemente de encontrar texto parecido a la pregunta de un usuario. Un índice vectorial puede recuperar una definición; por sí solo, no establece si dos métricas son equivalentes, qué conjunto de datos es ascendente ni cómo se asigna un concepto a una ruta de combinación. El modelo de ontología pretende conservar esas conexiones para que el agente reciba un contexto estructurado y trazable.
El mismo límite diferencia al proyecto de un endpoint de modelo. Auto Ontology no hace fiable a un agente únicamente por añadir otro paso de generación. Su aportación propuesta es el contexto que se proporciona al modelo: las definiciones que debe respetar, las entidades que puede relacionar, el linaje que puede inspeccionar y la procedencia que puede utilizar para evaluar la confianza. La calidad de la respuesta final sigue dependiendo del modelo subyacente, de los metadatos disponibles para la ingesta, de la configuración del despliegue y de la calidad de las propias definiciones de la organización.
Eso hace que el proyecto resulte interesante como componente de ingeniería de datos que se puede probar, más que como una promesa de corrección semántica automática. Un equipo puede evaluar si el contexto basado en ontologías modifica el comportamiento del agente ante un conjunto controlado de preguntas de negocio. Puede comprobar si la consulta generada utiliza el concepto certificado, sigue una relación adecuada y conserva el alcance previsto. También puede examinar si la respuesta sigue siendo explicable: no solo qué filas se devolvieron, sino por qué se seleccionó un conjunto de datos, una definición o una ruta de linaje determinados.
Por tanto, la primera pregunta práctica es más concreta que saber si Auto Ontology resuelve la analítica empresarial. Consiste en determinar si el marco puede hacer que un agente existente comprenda mejor el vocabulario y la estructura de los datos de la organización. El proyecto de NVIDIA ofrece los componentes para realizar ese experimento —ingesta de metadatos, construcción de ontologías, acceso semántico mediante una API o MCP e interfaces para operar el sistema—, pero la prueba debe proceder de una evaluación acotada con esquemas y respuestas conocidos. La capa de ontología propone un puente entre los metadatos empresariales sin procesar y el razonamiento del agente; la siguiente cuestión es si ese puente mejora las respuestas en los casos donde el significado empresarial, y no solo la sintaxis SQL, determina qué es correcto.
La prueba útil: ¿puede el significado empresarial mejorar las respuestas del agente?
El problema práctico que Auto Ontology pretende abordar no es si un agente puede producir SQL ejecutable. Es si la consulta representa la pregunta de negocio. Una columna llamada revenue quizá no contenga información suficiente para indicar al agente qué definición debe usar; una tabla de clientes puede describir cuentas, entidades de facturación o usuarios finales. El resultado puede ser sintácticamente válido, numéricamente plausible y semánticamente incorrecto. NVIDIA presenta Auto Ontology como una forma de proporcionar contexto explícito a los agentes antes de consultar, incluidos términos de negocio vinculados a columnas, SQL revisado para las métricas y relaciones entre tablas. (Repository README)
Ese contexto debería probarse como una cadena, no aceptarse como una promesa general. Un concepto de negocio debería resolverse en una definición que el equipo pueda inspeccionar y, cuando corresponda, certificar. La definición debe identificar las tablas, columnas o lógica de métrica pertinentes; las relaciones deben explicar qué uniones son legítimas; el linaje debe mostrar cómo depende una respuesta de los activos ascendentes; y la procedencia debe hacer visible el origen de los metadatos. El valor no está en que el agente parezca más seguro. Está en que un revisor pueda ver por qué se seleccionó un término y cómo condujo a la consulta generada.
«Certificado» también debe significar algo más que «creado por un trabajo de ingesta». Una prueba útil debería separar las definiciones revisadas por el responsable del dominio de las sugerencias que siguen siendo provisionales. Si una ontología define «cliente activo» según una lógica empresarial aprobada, las preguntas que utilicen esa expresión deberían resolverse mediante la métrica o la ruta de consulta correspondiente. Si el sistema no puede mostrar qué definición se utilizó, qué relaciones respaldaron la unión o qué activos de origen contribuyeron a la respuesta, la capa semántica no ha hecho que el resultado sea suficientemente verificable.
Una evaluación acotada resulta más reveladora que una demostración amplia. Empiece con un esquema pequeño que contenga algunas tablas de hechos y dimensiones, un campo de fecha y al menos una métrica deliberadamente ambigua. Prepare preguntas con respuestas conocidas, incluidos casos que requieran una unión concreta, un periodo de información definido o una distinción entre métricas similares. Ejecute cada pregunta primero mediante una ruta convencional de texto a SQL, con el esquema y documentación corriente, y después mediante una ruta basada en ontología. Mantenga tan constantes como sea posible el modelo, los datos y los permisos, para que la comparación mida la capa de contexto y no cambios ajenos.
Registre algo más que el éxito de la ejecución. En cada prueba, capture el SQL generado, los conceptos y relaciones recuperados, los filtros aplicados y el resultado final. Revise si la consulta utilizó la definición prevista, conservó el nivel de granularidad correcto, unió las entidades adecuadas y respondió a la pregunta que realmente plantearía un experto del dominio. El repositorio de NVIDIA describe una comprobación de respondibilidad y devuelve el SQL y los pasos del agente junto con una respuesta; esos artefactos deberían formar parte de la evaluación, no descartarse después de que la interfaz muestre un resultado. (Auto Ontology README)
Las pruebas negativas son esenciales. Pregunta por un término ambiguo, omite un límite temporal necesario o solicita una relación que el esquema no admite. El comportamiento esperado puede ser pedir una aclaración o indicar explícitamente que la pregunta no se puede responder. Un número pulido no implica éxito si el agente selecciona en silencio una tabla conveniente. La documentación de MCP también expone check_answerable junto con la respuesta a preguntas, y su herramienta ask_question devuelve por separado la respuesta, el SQL y las filas, lo que facilita inspeccionar este comportamiento en un entorno de pruebas para agentes. (Documentación de MCP)
Por último, clasifica los fallos en lugar de reducir el resultado a una sola cifra de precisión: definición empresarial incorrecta, unión inválida, granularidad equivocada, filtro ausente, afirmación no compatible o SQL simplemente ineficiente. Incorpora las correcciones revisadas al glosario y a las relaciones, y vuelve a ejecutar el mismo conjunto de respuestas conocidas. Ese ciclo de retroalimentación solo resulta útil cuando cada cambio en los metadatos se puede revisar y atribuir. Si el anclaje en la ontología mejora la precisión semántica, el comportamiento de aclaración y la trazabilidad en preguntas cuyas definiciones son explícitas, merece seguir en evaluación. Por sí solo, no demuestra que las consultas empresariales arbitrarias sean fiables.
Qué hace falta realmente para ejecutarlo
NVIDIA Auto Ontology se parece más a una pequeña plataforma de datos que a un paquete que se pueda añadir a un agente con un solo comando. El repositorio describe un despliegue compuesto por varios servicios: un frontend para la interfaz web, un backend que expone la aplicación y la superficie de la API, servicios de ingesta que se conectan a fuentes de datos empresariales y construyen la ontología, y Postgres con pgvector para el estado de la aplicación y la recuperación basada en vectores. Las rutas documentadas son Docker Compose para una configuración local o en un único host, y Kubernetes para un despliegue más operativo. Esta división importa porque la prueba no consiste únicamente en comprobar si la ontología produce una respuesta mejor; también hay que determinar si el equipo puede mantener alineados los servicios, las bases de datos, los endpoints de modelos y las credenciales como un solo sistema.
La capa de modelos es otra dependencia explícita. Auto Ontology está diseñado para funcionar con endpoints NVIDIA NIM o endpoints de modelos compatibles, y su configuración abarca más que el modelo de lenguaje utilizado para interpretar una pregunta. Las decisiones sobre embeddings y reranking también influyen en la selección de metadatos y del contexto candidato antes de generar una respuesta. En la práctica, dos instalaciones que usen el mismo esquema de origen pueden comportarse de forma distinta si emplean configuraciones diferentes de modelo, embeddings o reranking. Por eso, una evaluación útil registra esos ajustes junto con las preguntas y las salidas. De lo contrario, un cambio en la recuperación o en la configuración del modelo puede confundirse con una mejora de la propia ontología.
El lado de la base de datos también es concreto. El proyecto está pensado para conectarse a bases de datos empresariales compatibles y utilizar sus metadatos como entrada, mientras Postgres y pgvector cubren las necesidades de persistencia y recuperación de la propia aplicación. Esto establece una frontera entre las bases de datos descritas y el almacén utilizado por Auto Ontology. Antes de introducir credenciales, una prueba debería trazar esa frontera: identificar qué sistemas de origen se leerán, qué metadatos o información de linaje se recopilarán, dónde se almacenará la ontología resultante y qué servicio tiene permiso para llegar a cada endpoint. La arquitectura es manejable, pero no es una instalación ligera de un único binario que pueda incorporarse a un entorno de agentes sin tomar decisiones de infraestructura.
Hay dos formas principales de poner el contexto resultante a disposición de un agente. El proyecto expone una ruta de API para las aplicaciones que quieran llamar directamente a sus servicios, y su documentación de MCP describe un servidor MCP que puede utilizarse con un entorno de agentes compatible con MCP. MCP resulta útil cuando el agente ya sabe descubrir y llamar herramientas, mientras que la API es el punto de integración más directo para una aplicación controlada o un script de evaluación. En ambos casos, el agente no está consultando una segunda base de datos mágica. Está invocando las capacidades semánticas y de recuperación de Auto Ontology para incorporar definiciones empresariales, relaciones y metadatos relacionados al flujo de la solicitud o de la consulta.
Esa distinción debería orientar la primera prueba. Empiece con una base de datos pequeña y no sensible, o con un esquema representativo; levante el despliegue con Compose y verifique por separado el frontend, el backend, la ruta de ingesta, el almacén de Postgres/pgvector y el endpoint del modelo antes de conectar un agente. Después, ejecute las mismas preguntas fijas mediante la API o la ruta MCP, manteniendo sin cambios el modelo, los embeddings, el reranking y la configuración de las fuentes. No compruebe únicamente la respuesta final en lenguaje natural: revise también si el SQL generado es válido, si utiliza las tablas y definiciones previstas y si el sistema expone suficiente procedencia para explicar el resultado. Que un despliegue responda correctamente a una pregunta de demostración todavía no demuestra que toda la integración sea fiable.
Por tanto, el coste operativo forma parte de la evaluación del producto. Los equipos necesitan orquestación de contenedores, un servicio de Postgres persistente, acceso a modelos, rutas de red hacia las bases de datos de origen y un plan para actualizar y recuperar los distintos componentes ante fallos. Kubernetes puede facilitar la repetición del despliegue a escala organizativa, pero también vuelve más importante definir responsables y contar con observabilidad; Docker Compose puede acortar una evaluación acotada, aunque deja sin resolver las cuestiones de producción. El umbral razonable para superar la fase de prueba no es que la interfaz funcione, sino que el equipo pueda reproducir la configuración, limitar el acceso, identificar qué componente generó una respuesta y retirar o sustituir el servicio de ontología sin dejar al agente ni a los sistemas de origen en un estado ambiguo.
Licencia, credenciales y motivos para mantener la cautela
Apache-2.0 hace que Auto Ontology sea relativamente fácil de evaluar desde la perspectiva de las licencias: los equipos pueden inspeccionar, ejecutar, modificar y redistribuir el proyecto conforme a sus términos. NVIDIA también publica artefactos de contenedor e identifica por separado los componentes de terceros. Esto resulta útil para una evaluación técnica, pero no debe confundirse con un compromiso completo de soporte para producción. El repositorio afirma que el equipo de Auto Ontology mantiene el código y no acepta pull requests externos; las solicitudes de integración y los informes de errores se gestionan mediante issues. En la práctica, un adoptante debería asumir que las correcciones importantes, las decisiones de lanzamiento y los cambios sensibles para la seguridad siguen dependiendo del equipo mantenedor.
Ese modelo de propiedad importa porque el proyecto es lo bastante grande como para tener varios límites operativos: el frontend web y la capa de autenticación, el backend de FastAPI y los servicios de ingesta, PostgreSQL con pgvector, los endpoints de modelos, los conectores de bases de datos y el puente MCP. Además, un issue público señala que la documentación todavía describe el repositorio como interno de NVIDIA, aunque el repositorio es público. La discrepancia no constituye por sí misma una vulnerabilidad, pero indica que conviene contrastar la documentación con el código, los manifiestos de despliegue y las imágenes publicadas antes de tratar la guía de inicio rápido como un procedimiento operativo de referencia. La misma revisión debería confirmar qué etiquetas de imagen, valores de Helm, rutas de API y endpoints de modelos están aprobados para el entorno previsto.
La advertencia más importante tiene que ver con el almacenamiento de credenciales. Las conexiones añadidas mediante la interfaz se almacenan de forma distinta según esté configurado HashiCorp Vault. Sin Vault, el objeto de conexión completo, incluida la contraseña, se serializa en una fila del catálogo de PostgreSQL sin cifrado. Vault cambia esa disposición al guardar las credenciales por separado y dejar fuera de ellas la fila del catálogo, pero Vault es opcional y una configuración parcial vuelve al almacenamiento en texto plano y muestra una advertencia. Por eso, este ajuste es un control arquitectónico, no una simple comodidad. Antes de conectar un almacén de datos de producción, los equipos de seguridad deberían verificar la configuración real de Vault, inspeccionar las copias de seguridad y las réplicas de la base de datos, restringir el acceso al catálogo y confirmar que los roles que no necesitan los registros de conexión no pueden leerlos.
El límite del servicio interno merece el mismo nivel de atención. La documentación del proyecto indica que los puertos utilizados por el backend de FastAPI y el servicio de ingesta deben permanecer en una red privada. El frontend transmite la identidad del usuario al backend, mientras que las operaciones de ingesta —como ingest, delete, reset y compile— no cuentan con autenticación propia. Por tanto, la vía prevista pasa por la aplicación web autenticada o por la puerta de enlace de la API pública, no por exponer directamente esos servicios de FastAPI. Publicar los puertos internos detrás de un balanceador de carga, abrirlos a una red de clúster amplia o asumir que un cliente MCP aporta la autorización que falta debilitaría el límite en el que se basa el modelo de despliegue.
Las decisiones sobre modelos y servicios alojados añaden otra cuestión de gobernanza de datos. La configuración predeterminada utiliza endpoints de modelos alojados por NVIDIA, aunque pueden configurarse endpoints NIM autohospedados o compatibles según el rol. Las preguntas predictivas también pueden dirigirse a KumoRFM cuando está habilitado; la documentación señala que las tablas conectadas pueden cargarse en ese servicio alojado, sujeto a sus límites de configuración y condiciones. Una evaluación debería registrar, por tanto, por dónde circulan los metadatos del esquema, los valores de muestra, los prompts, el SQL generado y los resultados de las consultas. «Código abierto» describe el código de Auto Ontology, pero no convierte automáticamente al proveedor de modelos configurado, el conector, la base de datos o el servicio de predicción alojado en parte del mismo límite de confianza.
Una vía sensata de adopción es realizar un piloto contenido con datos sintéticos o no sensibles, aplicar políticas de red que mantengan privados los servicios internos, habilitar Vault antes de añadir credenciales gestionadas desde la interfaz y elegir los endpoints de modelos de forma deliberada. Hay que probar la autenticación y el comportamiento de los roles mediante las mismas rutas de API y MCP que utilizarán los agentes. Conviene conservar una exportación de la ontología validada, la configuración de acceso a la base de datos y la versión del despliegue, para poder desactivar la compilación o revertir cambios sin perder el estado de referencia. Después, antes de usarlo en producción, se debe exigir una revisión de seguridad independiente que incluya comprobaciones de secretos, registros, copias de seguridad, tráfico saliente, procedencia de las dependencias y permisos en cada fuente conectada.
La conclusión práctica es más limitada que afirmar «Auto Ontology está listo» o «Auto Ontology es inseguro». Está listo para probarse como capa de metadatos y contexto para agentes, siempre que la evaluación trate el despliegue y la gestión de datos como parte del producto, no como simples detalles de configuración. Su licencia Apache-2.0 facilita la inspección, mientras que el almacenamiento de conexiones en texto plano sin Vault, los endpoints de servicios internos sin autenticación, los límites de confianza de los modelos alojados y los cambios controlados por los mantenedores plantean preguntas que una demostración no puede responder. La prueba adecuada es un despliegue pequeño y reversible en el que los controles de seguridad, el comportamiento de las consultas y el procedimiento de reversión queden demostrados antes de permitir que la ontología se sitúe delante de datos empresariales sensibles.
Related articles
GitHub Actions a supprimé Node 20 : ce que les mainteneurs open source doivent vérifier maintenant
GitHub Actions exécute désormais les actions JavaScript avec Node 24. La migration dépasse les métadonnées : runners auto-hébergés, anciens Mac, appareils ARM32, caches et émulateurs locaux peuvent encore provoquer des échecs.
Android-Head-Units im Auto werden zum IoT-Lieferkettenrisiko
Der neue Fall von Kaspersky zeigt, warum vernetzte Nachrüstbildschirme wie Endpunkte behandelt werden müssen, nicht wie harmlose Radios.
Faut-il acheter un aspirateur robot avec lavage et auto-nettoyage en 2026 ?
Les aspirateurs robots sont devenus plus intelligents, mais ils ne remplacent pas une vraie séance de ménage. Voici dans quels foyers un modèle avec station autonome vaut son prix.
Autohalterungen für Actionkameras: Wann Saugnapf, Magnet oder Klemme sinnvoll sind
Eine Autohalterung ist nur so zuverlässig wie Oberfläche, Belastung und Strecke. Dieser Vergleich zeigt, wann Saugnäpfe, magnetische Halterungen und Klemmen für eine Actionkamera passen – und wo ihre Grenzen liegen.
Comments
Sign in to comment.
No comments yet.