NVIDIA Auto Ontology zamienia metadane przedsiębiorstwa w warstwę kontekstu dla agentów — co jest gotowe do testów
Nowy projekt NVIDIA Auto Ontology na licencji Apache-2.0 ma zwiększać niezawodność zapytań agentów, ujawniając definicje biznesowe, pochodzenie danych, relacje i proweniencję. Kluczowe pytanie brzmi, czy jego wdrożenie i model poświadczeń pasują do rzeczywistego stosu danych.
Co wydała firma NVIDIA i do czego ma służyć warstwa ontologii
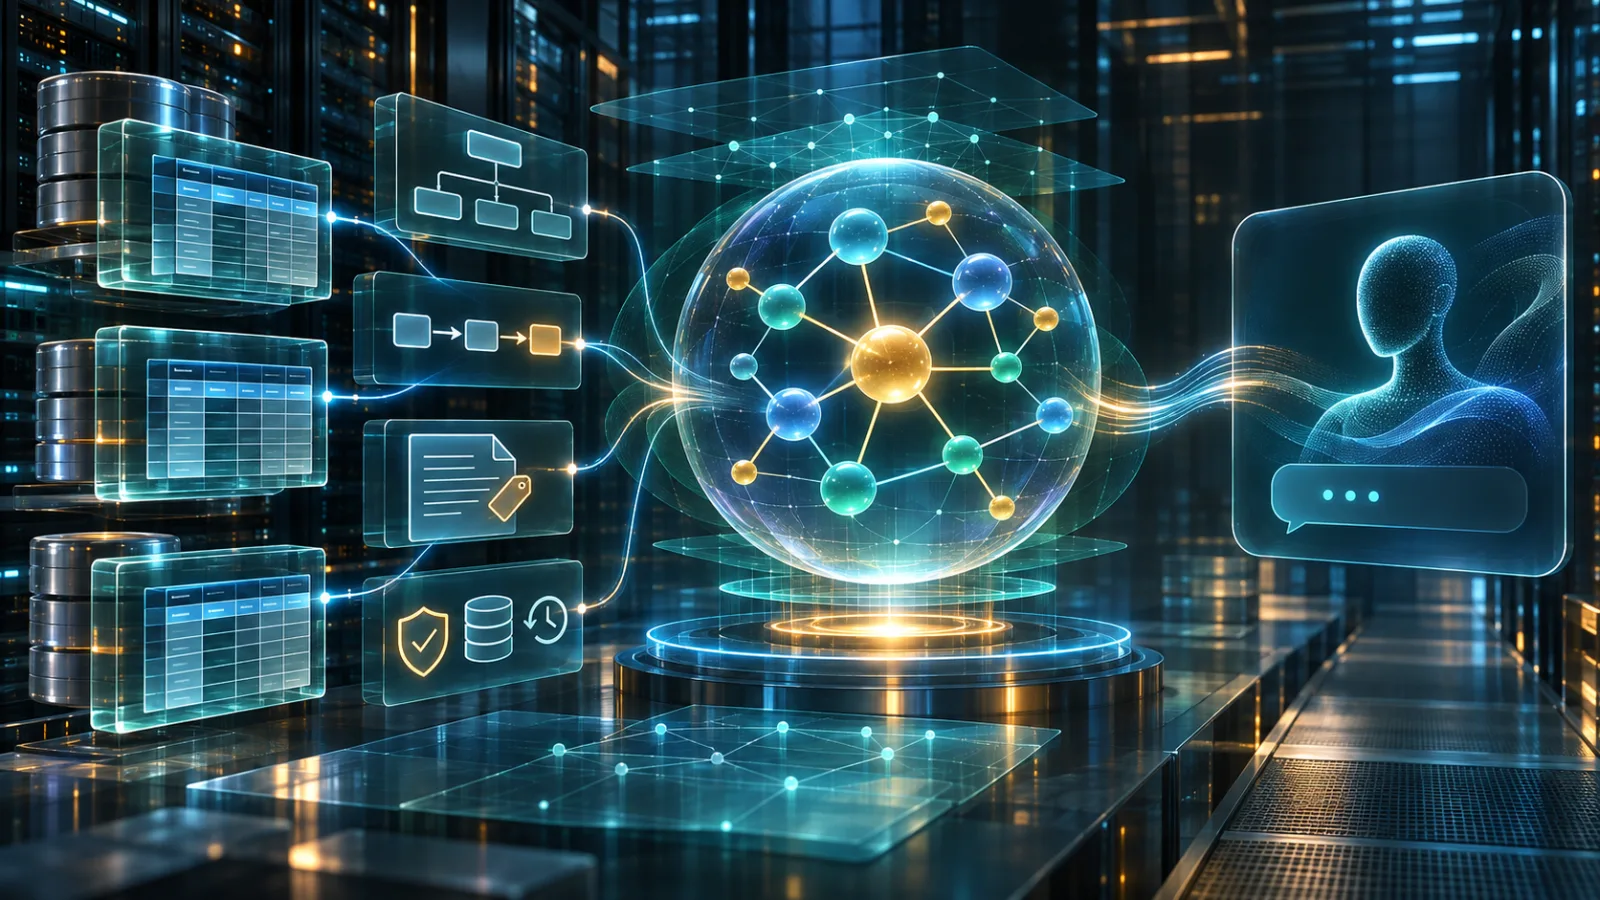
NVIDIA Auto Ontology przedstawiono jako framework w języku Python, udostępniony na licencji Apache-2.0, który zamienia metadane przedsiębiorstwa w ustrukturyzowaną warstwę kontekstu dla agentów danych. Jego celem nie jest zastąpienie modelu językowego, bazy danych ani tradycyjnego katalogu danych. Warstwa ta lokuje się między tymi systemami: gromadzi informacje o tabelach, kolumnach, definicjach biznesowych, relacjach, pochodzeniu danych i proweniencji, a następnie porządkuje je tak, aby agent mógł wykorzystać je podczas interpretowania pytania i tworzenia zapytania analitycznego.
To rozróżnienie ma znaczenie, ponieważ agent może wygenerować poprawny składniowo SQL, a mimo to błędnie zrozumieć biznesowy sens prośby. Baza danych może zawierać kilka wersji danych dotyczących przychodów, klientów, wysyłek lub aktywności, z odmiennymi granicami czasowymi i właścicielami. Model, który widzi tylko nazwy tabel i opisy kolumn, może wybrać wiarygodnie wyglądające pole, nie wiedząc, która definicja została zatwierdzona, jak wyliczana jest dana metryka ani który system nadrzędny jest źródłem referencyjnym. Auto Ontology ma ujawniać te powiązania, zamiast pozostawiać je skojarzeniom wywnioskowanym przez model.
Repozytorium opisuje framework, który może generować ontologie przedsiębiorstwa na podstawie metadanych lub łączyć się z nimi, a także uzgadniać definicje między systemami. W praktyce ontologia jest czytelną maszynowo reprezentacją pojęć dotyczących danych organizacji i relacji między nimi. Może łączyć termin biznesowy z fizycznymi strukturami danych, wiązać powiązane encje, zachowywać informacje o pochodzeniu danych oraz przechowywać proweniencję potrzebną do ustalenia, skąd pochodzi dana definicja lub relacja. Rezultat przypomina zarządzaną mapę semantyczną bardziej niż zbiór dokumentów pobieranych na potrzeby promptu.
Auto Ontology udostępnia ten kontekst także przez kilka interfejsów. Projekt obejmuje aplikację internetową, API, interfejs wiersza poleceń oraz integrację MCP przeznaczoną dla środowisk uruchamiających agentów. Interfejsy te oferują różne punkty wejścia do tego samego szerszego procesu: pozyskiwania metadanych, tworzenia lub przeglądania ontologii oraz udostępniania informacji semantycznych aplikacjom, które muszą odpowiadać na pytania dotyczące danych. MCP ma szczególne znaczenie dla zespołów już testujących agentów korzystających z narzędzi, ponieważ umożliwia zewnętrznemu środowisku agenta wywoływanie funkcji opartych na ontologii, zamiast umieszczania całego katalogu i procesu rozumowania w prompcie.
Obsługiwana architektura rozdziela więc dwie kwestie. Pierwszą jest środowisko danych przedsiębiorstwa: bazy danych, schematy, systemy metadanych i definicje, z którymi projekt się łączy lub które pozyskuje. Drugą jest warstwa ontologii i rozumowania, która interpretuje te dane wejściowe i przedstawia agentowi odpowiedni kontekst. Operacyjne rozdzielenie tych obszarów jest użyteczne. Warstwa ontologii może opisywać źródło, nie stając się nim, a także pomagać agentowi poruszać się po kilku systemach bez konieczności każdorazowego odtwarzania reguł biznesowych z surowej struktury bazy danych.
Z tego powodu Auto Ontology nie powinno być oceniane jako ogólny produkt do wyszukiwania wektorowego. Wyszukiwanie semantyczne może być częścią implementacji, lecz deklarowana wartość projektu zależy od ustrukturyzowanych relacji i metadanych, a nie tylko od znajdowania tekstu podobnego do pytania użytkownika. Indeks wektorowy może pobrać definicję, ale sam z siebie nie ustali, czy dwie metryki są równoważne, który zbiór danych znajduje się wyżej w łańcuchu zależności ani jak dane pojęcie mapuje się na ścieżkę łączenia. Model ontologii ma zachowywać te powiązania, aby agent otrzymywał kontekst wraz ze strukturą i możliwością prześledzenia źródła.
Ta sama granica oddziela projekt od punktu końcowego modelu. Auto Ontology nie zapewnia agentowi niezawodności wyłącznie przez dodanie kolejnego etapu generowania. Proponowany wkład projektu to kontekst dostarczany modelowi: definicje, których powinien przestrzegać, encje, które może ze sobą wiązać, pochodzenie danych, które może sprawdzać, oraz proweniencja, na podstawie której może oceniać poziom pewności. Jakość końcowej odpowiedzi nadal zależy od bazowego modelu, dostępnych do pozyskania metadanych, konfiguracji wdrożenia oraz jakości własnych definicji organizacji.
To sprawia, że projekt jest interesujący jako komponent inżynierii danych możliwy do przetestowania, a nie jako obietnica automatycznej poprawności semantycznej. Zespół może sprawdzić, czy kontekst oparty na ontologii zmienia zachowanie agenta na kontrolowanym zestawie pytań biznesowych. Może zweryfikować, czy wygenerowane zapytanie korzysta z certyfikowanego pojęcia, używa właściwej relacji i zachowuje zamierzony zakres. Warto też ocenić, czy odpowiedź pozostaje wyjaśnialna: nie tylko które wiersze zwrócono, ale dlaczego wybrano konkretny zbiór danych, definicję lub ścieżkę pochodzenia.
Pierwsze praktyczne pytanie jest więc węższe niż kwestia tego, czy Auto Ontology rozwiązuje problem analityki korporacyjnej. Chodzi o to, czy framework może sprawić, że istniejący agent lepiej rozumie słownictwo i strukturę danych organizacji. Projekt NVIDIA udostępnia elementy potrzebne do takiego eksperymentu — pozyskiwanie metadanych, budowanie ontologii, dostęp semantyczny przez API lub MCP oraz interfejsy do obsługi systemu — ale dowód musi pochodzić z ograniczonej ewaluacji przeprowadzonej na znanych schematach i przy znanych odpowiedziach. Warstwa ontologii ma być pomostem między surowymi metadanymi przedsiębiorstwa a rozumowaniem agenta; kolejne pytanie brzmi, czy ten pomost poprawia odpowiedzi tam, gdzie o poprawności decyduje znaczenie biznesowe, a nie sama składnia SQL.
Użyteczny test: czy znaczenie biznesowe może poprawić odpowiedzi agenta
Praktyczny problem, który ma rozwiązać Auto Ontology, nie sprowadza się do tego, czy agent potrafi wygenerować działający kod SQL. Chodzi o to, czy zapytanie rzeczywiście oddaje sens pytania biznesowego. Kolumna o nazwie revenue może nie dostarczać agentowi wystarczających informacji, by wybrał właściwą definicję; tabela klientów może opisywać konta, podmioty rozliczeniowe albo użytkowników końcowych. Wynik może być poprawny składniowo, liczbowo wiarygodny, a zarazem błędny semantycznie. NVIDIA przedstawia Auto Ontology jako sposób na dostarczenie agentom jawnego kontekstu przed wykonaniem zapytania, w tym terminów biznesowych powiązanych z kolumnami, zweryfikowanego SQL dla miar oraz relacji między tabelami. (Repository README)
Taki kontekst powinien być testowany jako łańcuch, a nie przyjmowany jako ogólna obietnica. Pojęcie biznesowe powinno prowadzić do definicji, którą zespół może sprawdzić i, jeśli to właściwe, certyfikować. Definicja powinna wskazywać odpowiednie tabele, kolumny lub logikę miary; relacje powinny wyjaśniać, które złączenia są uzasadnione; pochodzenie powinno pokazywać, od jakich zasobów nadrzędnych zależy odpowiedź; a proweniencja powinna ujawniać źródło metadanych. Wartość nie polega na tym, że agent brzmi bardziej pewnie. Chodzi o to, by osoba weryfikująca mogła zobaczyć, dlaczego wybrano dany termin i jak doprowadziło to do wygenerowanego zapytania.
„Certyfikowane” nie powinno oznaczać jedynie „utworzone przez zadanie ingestujące”. Dobry test musi rozdzielać definicje zweryfikowane przez właściciela domeny od sugestii, które pozostają wstępne. Jeśli ontologia definiuje „aktywnego klienta” zgodnie z zatwierdzoną logiką biznesową, pytania zawierające to określenie powinny prowadzić do odpowiadającej mu miary lub ścieżki zapytania. Jeżeli system nie potrafi pokazać, której definicji użyto, jakie relacje uzasadniały złączenie ani które zasoby źródłowe przyczyniły się do powstania odpowiedzi, warstwa semantyczna nie zapewniła wystarczającej rozliczalności wyniku.
Ograniczona ewaluacja mówi więcej niż szeroka demonstracja. Zacznij od niewielkiego schematu zawierającego kilka tabel faktów i wymiarów, pole daty oraz co najmniej jedną celowo niejednoznaczną miarę. Przygotuj pytania o znanych odpowiedziach, w tym przypadki wymagające konkretnego złączenia, określonego okresu raportowania albo rozróżnienia podobnych miar. Każde pytanie przepuść najpierw przez konwencjonalną ścieżkę text-to-SQL, korzystającą ze schematu i zwykłej dokumentacji, a następnie przez ścieżkę opartą na ontologii. Utrzymuj model, dane i uprawnienia w miarę możliwości bez zmian, aby porównanie mierzyło wpływ warstwy kontekstu, a nie niezwiązanych z nim różnic.
Rejestruj więcej niż sam fakt pomyślnego wykonania. Dla każdego uruchomienia zapisz wygenerowany SQL, pobrane pojęcia i relacje, zastosowane filtry oraz końcowy wynik. Sprawdź, czy zapytanie użyło zamierzonej definicji, zachowało właściwy poziom szczegółowości, połączyło odpowiednie encje i odpowiedziało na pytanie, które rzeczywiście zadałby ekspert domenowy. README repozytorium NVIDIA opisuje kontrolę możliwości udzielenia odpowiedzi oraz zwracanie SQL i kroków agenta wraz z odpowiedzią; te artefakty powinny być częścią ewaluacji, a nie znikać po wyświetleniu wyniku przez interfejs. (Auto Ontology README)
Testy negatywne są niezbędne. Zapytaj o termin o wielu znaczeniach, pomiń konieczne ograniczenie czasowe albo poproś o relację, której schemat nie obsługuje. Oczekiwanym zachowaniem może być prośba o doprecyzowanie lub wyraźne wskazanie, że na pytanie nie da się odpowiedzieć. Wygenerowana liczba nie świadczy o sukcesie, jeśli agent po cichu wybierze wygodną tabelę. Dokumentacja MCP udostępnia również check_answerable obok odpowiadania na pytania, a narzędzie ask_question zwraca odpowiedź, SQL i wiersze jako osobne pola, dzięki czemu łatwiej przeanalizować to zachowanie w uprzęży agenta. (dokumentacja MCP)
Na koniec klasyfikuj błędy, zamiast sprowadzać wynik do jednej wartości dokładności: błędna definicja biznesowa, nieprawidłowe połączenie, niewłaściwy poziom szczegółowości, brakujący filtr, nieobsługiwane twierdzenie albo po prostu nieefektywny SQL. Zweryfikowane poprawki wprowadzaj z powrotem do glosariusza i relacji, a następnie ponownie uruchamiaj ten sam zestaw pytań z ustalonymi odpowiedziami. Taka pętla informacji zwrotnej jest użyteczna tylko wtedy, gdy każdą zmianę metadanych można przejrzeć i przypisać do konkretnego źródła. Jeśli ugruntowanie w ontologii poprawia poprawność semantyczną, zachowanie przy prośbach o doprecyzowanie i możliwość prześledzenia odpowiedzi w pytaniach, których definicje są jednoznaczne, rozwiązanie zasługuje na dalsze testy. Samo w sobie nie dowodzi jednak, że dowolne zapytania przedsiębiorstwa będą obsługiwane niezawodnie.
Czego naprawdę wymaga uruchomienie
NVIDIA Auto Ontology przypomina raczej niewielką platformę danych niż pakiet, który można dodać do istniejącego agenta jednym poleceniem. Repozytorium opisuje wdrożenie złożone z kilku usług: frontendu dla interfejsu internetowego, backendu udostępniającego aplikację i interfejs API, usług ingestujących łączących się z firmowymi źródłami danych i budujących ontologię oraz bazy Postgres z pgvector, przechowującej stan aplikacji i obsługującej wyszukiwanie wektorowe. Udokumentowane ścieżki wdrożenia to Docker Compose w konfiguracji lokalnej lub na jednym hoście oraz Kubernetes w bardziej operacyjnym środowisku. Ten podział ma znaczenie, bo test nie dotyczy wyłącznie tego, czy ontologia daje lepszą odpowiedź. Chodzi również o to, czy zespół potrafi utrzymać spójność usług, bazy danych, endpointów modeli i poświadczeń jako jednego systemu.
Warstwa modeli jest kolejną jawną zależnością. Auto Ontology zaprojektowano do pracy z endpointami NVIDIA NIM lub zgodnymi endpointami modeli, a konfiguracja obejmuje więcej niż model językowy używany do interpretacji pytania. Wybór modelu osadzającego i mechanizmu rerankingu również wpływa na to, jakie metadane i jaki kontekst zostaną wybrane przed wygenerowaniem odpowiedzi. W praktyce dwie instalacje korzystające z tego samego schematu źródłowego mogą działać różnie, jeśli używają innych konfiguracji modelu, osadzania lub rerankingu. Rzetelna ewaluacja powinna więc zapisywać te ustawienia razem z pytaniami i wynikami. W przeciwnym razie zmianę konfiguracji wyszukiwania lub modelu można pomylić z ulepszeniem samej ontologii.
Strona bazodanowa jest równie konkretna. Projekt ma łączyć się z obsługiwanymi firmowymi bazami danych i wykorzystywać ich metadane jako dane wejściowe, podczas gdy Postgres i pgvector odpowiadają za własne potrzeby aplikacji związane z trwałością danych i wyszukiwaniem. Powstaje więc granica między bazami opisywanymi przez system a magazynem używanym przez Auto Ontology. Przed wprowadzeniem jakichkolwiek poświadczeń należy tę granicę odwzorować: ustalić, z jakich systemów źródłowych będą odczytywane dane, jakie metadane lub informacje o pochodzeniu zostaną zebrane, gdzie będzie przechowywana wynikowa ontologia oraz która usługa może łączyć się z poszczególnymi endpointami. Architektura jest możliwa do opanowania, ale nie jest lekką instalacją w postaci pojedynczego pliku binarnego, który można bez decyzji infrastrukturalnych wrzucić do środowiska uruchomieniowego agenta.
Istnieją dwa główne sposoby udostępnienia agentowi tak uzyskanego kontekstu. Projekt oferuje ścieżkę API dla aplikacji, które chcą bezpośrednio wywoływać jego usługi, a dokumentacja MCP opisuje serwer MCP możliwy do wykorzystania przez zgodną z MCP uprząż agenta. MCP sprawdza się, gdy agent potrafi już wykrywać i wywoływać narzędzia, natomiast API jest bardziej bezpośrednim punktem integracji dla kontrolowanej aplikacji lub skryptu ewaluacyjnego. W obu przypadkach agent nie odpytuje magicznej drugiej bazy danych. Wywołuje semantyczne i wyszukiwawcze funkcje Auto Ontology, aby definicje biznesowe, relacje i powiązane metadane mogły zostać uwzględnione w procesie obsługi żądania lub zapytania.
To rozróżnienie powinno wyznaczyć kształt pierwszego testu. Zacznij od jednej małej, niewrażliwej bazy danych albo reprezentatywnego schematu, uruchom wdrożenie Compose i niezależnie zweryfikuj frontend, backend, ścieżkę ingestii, magazyn Postgres/pgvector oraz endpoint modelu, zanim podłączysz agenta. Następnie prześlij ten sam ustalony zestaw pytań przez API lub MCP, pozostawiając bez zmian model, embeddingi, reranking i konfigurację źródeł. Sprawdzaj nie tylko końcową odpowiedź tekstową, lecz także to, czy wygenerowany SQL jest poprawny, czy korzysta z właściwych tabel i definicji oraz czy system udostępnia wystarczająco dużo informacji o pochodzeniu danych, by wyjaśnić wynik. To, że wdrożenie poprawnie odpowie na jedno pytanie demonstracyjne, nie jest jeszcze dowodem niezawodności całej integracji.
Koszt operacyjny jest więc częścią pytania o produkt. Zespoły potrzebują orkiestracji kontenerów, trwałej usługi Postgres, dostępu do modeli, tras sieciowych do baz źródłowych oraz planu aktualizacji i obsługi awarii obejmującego odrębne komponenty. Kubernetes może ułatwić powtarzalność na skalę organizacji, ale jednocześnie zwiększa znaczenie jasno określonej odpowiedzialności i obserwowalności; Docker Compose może skrócić ograniczoną ewaluację, pozostawiając nierozwiązane kwestie produkcyjne. Rozsądnym progiem wyjścia poza test nie jest samo działanie interfejsu, lecz zdolność zespołu do odtworzenia konfiguracji, ograniczenia dostępu, ustalenia, który komponent wygenerował odpowiedź, oraz usunięcia lub zastąpienia usługi ontologii bez pozostawiania agenta ani systemów źródłowych w niejednoznacznym stanie.
Licencja, dane uwierzytelniające i powody do ostrożności
Apache-2.0 sprawia, że Auto Ontology jest stosunkowo łatwy do oceny pod względem licencyjnym: zespoły mogą analizować, uruchamiać, modyfikować i redystrybuować projekt zgodnie z warunkami licencji. NVIDIA publikuje również artefakty kontenerowe i osobno wskazuje komponenty firm trzecich. Jest to przydatne w ocenie technicznej, ale nie należy mylić tego z pełnym zobowiązaniem do wsparcia produkcyjnego. Repozytorium informuje, że zespół Auto Ontology utrzymuje kod i nie przyjmuje zewnętrznych pull requestów; prośby dotyczące integracji oraz zgłoszenia błędów są obsługiwane jako issues. W praktyce użytkownik powinien założyć, że istotne poprawki, decyzje dotyczące wydań i zmiany związane z bezpieczeństwem nadal zależą od zespołu opiekunów.
Ten model własności ma znaczenie, ponieważ projekt jest na tyle rozbudowany, że obejmuje kilka granic operacyjnych: frontend internetowy i warstwę uwierzytelniania, backend FastAPI i usługi ingestii, PostgreSQL z pgvector, endpointy modeli, konektory baz danych oraz most MCP. Publiczne zgłoszenie wskazuje też, że dokumentacja nadal opisuje repozytorium jako wewnętrzne dla NVIDIA, mimo że samo repozytorium jest publiczne. Ta rozbieżność nie jest sama w sobie podatnością, ale sygnalizuje, że przed potraktowaniem quickstartu jako wiążącej procedury operacyjnej należy porównać dokumentację z kodem, manifestami wdrożeniowymi i opublikowanymi obrazami. W ramach tego samego przeglądu trzeba potwierdzić, które tagi obrazów, wartości Helm, trasy API i endpointy modeli są zatwierdzone dla planowanego środowiska.
Najpoważniejsze ostrzeżenie dotyczy przechowywania danych uwierzytelniających. Połączenia dodane przez interfejs są zapisywane różnie w zależności od tego, czy skonfigurowano HashiCorp Vault. Bez Vaulta cały obiekt połączenia, w tym hasło, jest serializowany w wierszu katalogu PostgreSQL bez szyfrowania. Vault zmienia ten układ, przechowując dane uwierzytelniające osobno i pozostawiając wiersz katalogu bez nich, jednak Vault jest opcjonalny, a częściowa konfiguracja powoduje powrót do przechowywania w postaci jawnego tekstu wraz z ostrzeżeniem. To sprawia, że ustawienie jest kontrolą architektoniczną, a nie drobnym udogodnieniem. Przed podłączeniem produkcyjnej hurtowni danych zespoły bezpieczeństwa powinny zweryfikować rzeczywistą konfigurację Vaulta, sprawdzić kopie zapasowe i repliki bazy danych, ograniczyć dostęp do katalogu oraz potwierdzić, że rekordów połączeń nie mogą odczytywać role, które nie mają takiej potrzeby.
Wewnętrzna granica usług wymaga takiej samej uwagi. Dokumentacja projektu wskazuje, że porty używane przez backend FastAPI i usługę ingestowania powinny pozostać w prywatnej sieci. Frontend przekazuje tożsamość użytkownika do backendu, natomiast operacje ingestowania, takie jak ingest, delete, reset i compile, nie mają własnego uwierzytelniania. Zamierzona ścieżka prowadzi więc przez uwierzytelnioną aplikację internetową albo publiczną bramę API, a nie przez bezpośrednie wystawienie tych usług FastAPI. Publikowanie wewnętrznych portów za load balancerem, otwieranie ich dla szerokiej sieci klastra lub założenie, że klient MCP zapewnia brakującą autoryzację, osłabiłoby granicę, na której opiera się model wdrożenia.
Wybór modeli i usług hostowanych rodzi kolejne pytanie dotyczące zarządzania danymi. Domyślna konfiguracja korzysta z hostowanych przez NVIDIA endpointów modeli, ale dla poszczególnych ról można skonfigurować samodzielnie hostowane NIM-y lub kompatybilne endpointy. Pytania predykcyjne mogą być również kierowane do KumoRFM, jeśli ta opcja jest włączona; dokumentacja stwierdza, że połączone tabele mogą być przesyłane do tej usługi hostowanej, z uwzględnieniem jej limitów konfiguracyjnych i warunków korzystania. Ocena powinna zatem obejmować rejestr miejsc, do których trafiają metadane schematu, próbkowane wartości, prompty, wygenerowany SQL i wyniki zapytań. Określenie „open source” opisuje kod Auto Ontology i nie oznacza automatycznie, że skonfigurowany dostawca modelu, konektor, baza danych czy hostowana usługa predykcyjna należą do tej samej granicy zaufania.
Rozsądna ścieżka wdrożenia zaczyna się od ograniczonego pilotażu z użyciem danych syntetycznych lub niewrażliwych, polityk sieciowych utrzymujących usługi wewnętrzne w trybie prywatnym, włączenia Vault, zanim zostaną dodane dane uwierzytelniające zarządzane z poziomu interfejsu, oraz świadomego wyboru endpointów modeli. Uwierzytelnianie i działanie ról należy testować przez te same ścieżki API i MCP, z których będą korzystać agenci. Warto zachować sprawdzony eksport ontologii, konfigurację dostępu do bazy danych i wersję wdrożenia, aby można było wyłączyć kompilację lub wykonać rollback bez utraty stanu referencyjnego. Przed użyciem produkcyjnym należy przeprowadzić niezależny przegląd bezpieczeństwa, obejmujący sekrety, logi, kopie zapasowe, ruch wychodzący, pochodzenie zależności oraz uprawnienia do każdego podłączonego źródła.
Praktyczny wniosek jest węższy niż stwierdzenie „Auto Ontology jest gotowe” albo „Auto Ontology jest niebezpieczne”. Rozwiązanie nadaje się do testów jako warstwa metadanych i kontekstu dla agentów, pod warunkiem że wdrożenie i obsługa danych zostaną potraktowane jako część produktu, a nie szczegóły konfiguracji. Licencja Apache-2.0 ułatwia inspekcję, natomiast przechowywanie danych połączeniowych w postaci jawnego tekstu bez Vaulta, nieuwierzytelnione wewnętrzne endpointy usług, granice usług hostowanych oraz zmiany kontrolowane przez maintainerów rodzą pytania, na które demonstracja nie odpowie. Właściwym sprawdzianem jest niewielkie, odwracalne wdrożenie, w którym przed udostępnieniem ontologii wrażliwym danym przedsiębiorstwa zostaną zademonstrowane mechanizmy bezpieczeństwa, działanie zapytań i procedura wycofania zmian.
Related articles
NVIDIA OpenShell podporządkowuje uprawnienia agentów politykom — co można już testować
NVIDIA OpenShell to środowisko uruchomieniowe na licencji Apache, które umieszcza agentów kodujących i autonomicznych w kontrolowanych politykami piaskownicach. Jego sednem jest granica obejmująca pliki, procesy, sieć, dane uwierzytelniające i zmiany polityk.
Rozmowy Nvidia-Hugging Face zmieniają model hub w ryzyko platformowe
To nie jest potwierdzone przejęcie, ale sygnał, że huby modeli trzeba traktować jak strategiczne zależności.
Mistral Large 4 est disponible en poids ouverts. Le vrai test est de savoir si vous pouvez l’exécuter
Mistral a publié les poids de son modèle multimodal d’un billion de paramètres. La question n’est plus seulement l’accès à une API, mais le matériel, les logiciels de service, la licence et l’utilité d’un déploiement local pour votre équipe.
NVIDIA OpenShell puts agent permissions under policy control — what is ready to test
NVIDIA OpenShell is an Apache-licensed runtime for placing coding and autonomous agents inside policy-controlled sandboxes. Its useful idea is not another agent framework, but a boundary around files, processes, networks, credentials, and policy changes.
Comments
Sign in to comment.
No comments yet.