NVIDIA Auto Ontology 将企业元数据转化为智能体上下文层——目前有哪些内容可以测试
NVIDIA 的 Apache-2.0 Auto Ontology 项目试图通过明确业务定义、血缘、关系和来源,让智能体查询更可靠。实际问题在于,它的部署方式和凭证模型能否适配真实的数据技术栈。
NVIDIA 发布了什么,以及本体层要解决什么问题
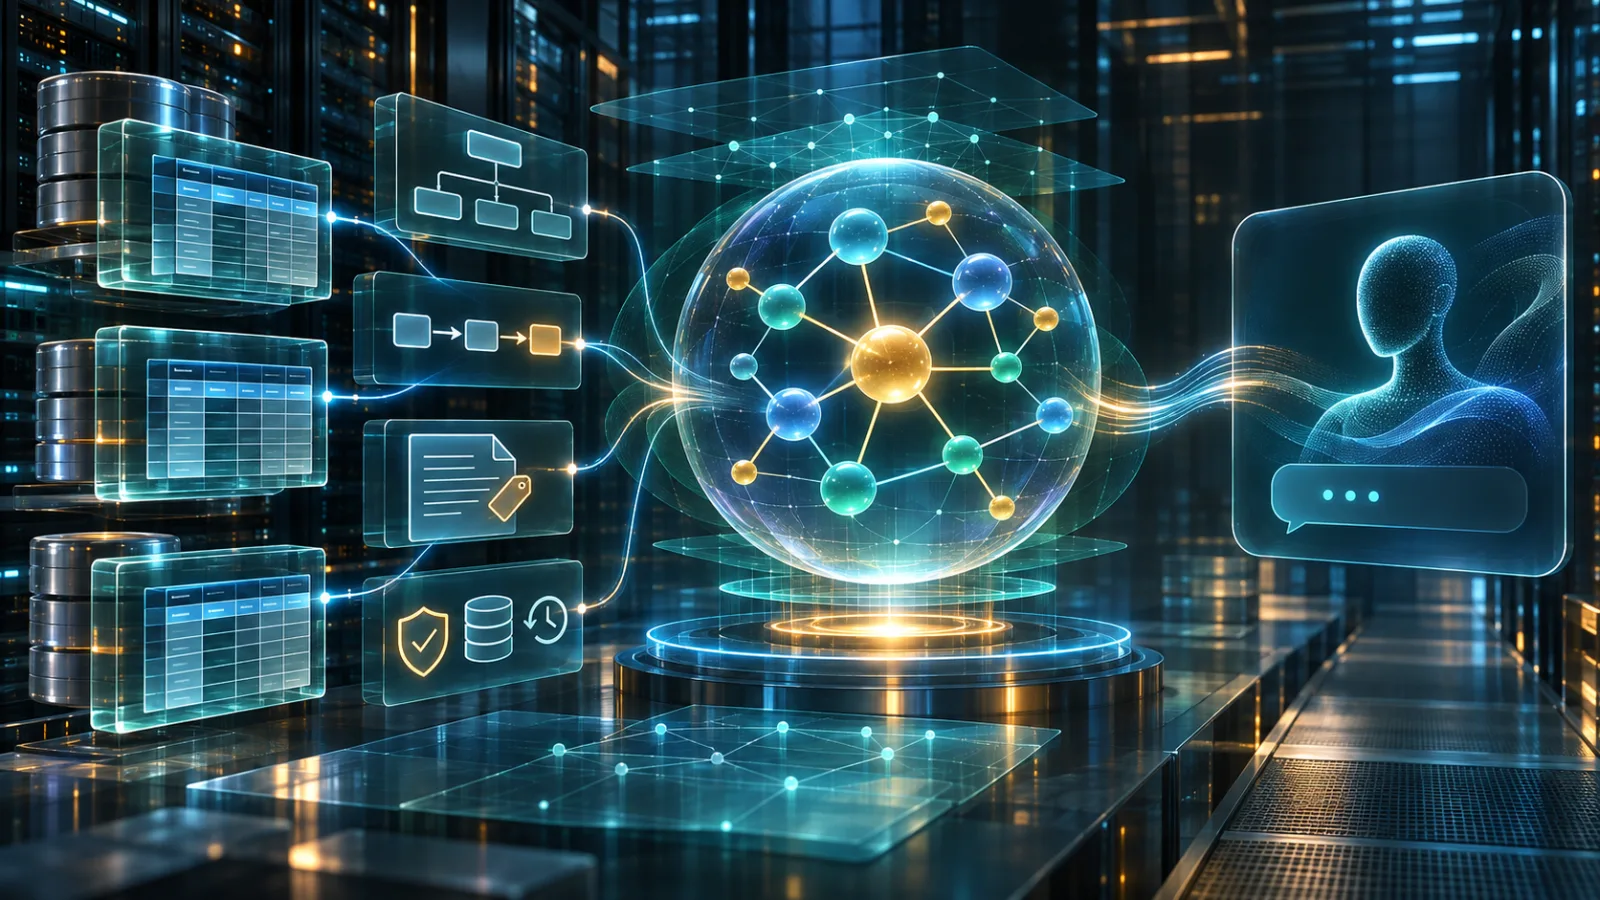
NVIDIA Auto Ontology 被定位为一个采用 Apache-2.0 许可证的 Python 框架,用于将企业元数据转化为数据智能体可使用的结构化上下文层。它并不是要取代语言模型、数据库或传统数据目录,而是位于这些系统之间:收集有关表、列、业务定义、关系、血缘和来源的信息,再对这些信息进行组织,使智能体能够在理解问题和构造分析查询时加以利用。
这一点很重要,因为智能体即使生成了语法正确的 SQL,也可能误解请求的业务含义。数据库中可能存在多个版本的收入、客户、发货或活动数据,它们的时间边界和归属各不相同。只看到表名和列描述的模型,可能会选中一个看似合理的字段,却不知道哪个定义经过认证、某个指标如何计算,或哪个上游系统才是权威来源。Auto Ontology 的目标,是明确表达这些关联,而不是把它们留给模型自行推断。
该项目仓库介绍了一个框架,可以根据元数据生成企业本体,或连接已有企业本体,并协调不同系统之间的定义。实际来看,本体是组织数据概念及其关系的机器可读表示。它可以把业务术语关联到物理数据结构,连接相关实体,保留血缘信息,并记录理解某个定义或关系来源所需的出处。最终形成的更像是一张受治理的语义地图,而不是一组为提示词检索出来的文档。
Auto Ontology 还通过多种接口提供这些上下文。项目包含 Web 应用、API、命令行界面,以及面向智能体运行环境的 MCP 集成。这些接口为同一套更广泛的工作流提供了不同入口:接入元数据、构建或审查本体,并将其中的语义信息提供给需要回答数据问题的应用。对于已经在测试工具调用型智能体的团队,MCP 尤其值得关注,因为外部智能体环境可以调用由本体支持的能力,而不必把整个目录和推理过程都嵌入提示词。
因此,这套架构包含两个彼此分开的关注点。一边是企业数据环境,包括项目要连接或接入的数据库、模式、元数据系统和定义;另一边是本体与推理层,用来解释这些输入并向智能体呈现相关上下文。在运维上保持两者分离很有价值。本体层可以描述数据源,却不必成为数据源本身;它也能帮助智能体在多个系统之间导航,而不必每次都从原始数据库结构中重新发现所有业务规则。
这也是 Auto Ontology 不应被当作通用向量搜索产品来评估的原因。语义检索可能是实现的一部分,但项目所宣称的价值依赖于结构化关系和元数据,而不只是找到与用户问题相似的文本。向量索引可以检索一个定义,却无法单独确定两个指标是否等价、哪个数据集位于上游,或某个概念如何映射到连接路径。本体模型的作用,是保留这些关联,让智能体接收到带有结构和可追溯性的上下文。
同样的边界也将该项目与模型端点区分开来。Auto Ontology 并不会仅仅因为增加了一次生成步骤,就让智能体变得可靠。它拟提供的贡献在于交给模型的上下文:模型应遵守的定义、可以关联的实体、能够检查的血缘,以及可用来判断置信度的来源。最终答案的质量,仍取决于底层模型、可供接入的元数据、部署配置,以及组织自身定义的质量。
这使得该项目更适合作为一个可测试的数据工程组件,而不是自动实现语义正确性的承诺。团队可以在一组受控的业务问题上,检验基于本体的上下文是否改变了智能体的行为;也可以检查生成的查询是否使用了经过认证的概念、遵循了恰当的关系,并保持了预期范围。还可以进一步考察答案是否具有可解释性:不仅要知道返回了哪些行,还要知道系统为何选择某个数据集、定义或血缘路径。
因此,最初的实际问题并不是 Auto Ontology 能否解决企业分析,而是这个框架能否让现有智能体更了解组织的数据词汇和结构。NVIDIA 的项目提供了开展这项实验所需的组件——元数据摄取、本体构建、通过 API 或 MCP 进行语义访问,以及用于运行系统的操作接口——但最终证明仍须来自针对已知模式和已知答案的限定评估。本体层被提出作为连接原始企业元数据与智能体推理的桥梁;接下来要问的是,在决定正确答案的是业务含义而非单纯 SQL 语法的场景中,这座桥是否真的能改善结果。
有价值的测试:业务含义能否改善智能体答案
Auto Ontology 要解决的实际问题,不是智能体能否生成一条可以执行的 SQL,而是这条查询是否真正表达了业务问题。名为 revenue 的列可能没有足够信息告诉智能体该采用哪种定义;客户表可能描述的是账户、开票实体,也可能是最终用户。结果可以语法有效、数值看似合理,却在语义上完全错误。NVIDIA 将 Auto Ontology 描述为一种在查询前向智能体提供明确上下文的方式,其中包括映射到列的业务术语、经过审核的指标 SQL,以及表之间的关系。(Repository README)
这类上下文应当被作为一条可检查的链路来测试,而不是被当作笼统承诺接受。业务概念应解析为团队能够检查、并在适当情况下予以认证的定义。定义应指出相关表、列或指标逻辑;关系应说明哪些连接是合理的;血缘应展示答案如何依赖上游资产;来源信息则应让元数据的出处清晰可见。价值不在于智能体听起来更有把握,而在于审核者能够看出系统为何选中了某个术语,以及它如何据此生成查询。
“已认证”也不能仅仅意味着“由摄取任务创建”。有价值的测试应区分领域负责人审核过的定义与仍属临时建议的定义。如果本体按照获批准的业务逻辑定义了“活跃客户”,那么使用这一说法的问题就应解析到相应的指标或查询路径。如果系统无法展示采用了哪个定义、哪些关系支撑了连接,或哪些源资产参与了答案生成,那么这个语义层还没有让结果具备足够的可追责性。
限定范围的评估比宽泛的演示更能说明问题。可以从一个小型模式开始,其中包含几张事实表和维度表、一个日期字段,以及至少一个刻意设置为含义模糊的指标。准备一组答案已知的问题,包括需要特定连接、明确报告周期,或区分相似指标的案例。每个问题先通过传统的 text-to-SQL 路径运行,输入模式和普通文档;再通过基于本体的路径运行。尽量保持模型、数据和权限一致,使比较结果反映上下文层的影响,而不是其他无关变化。
记录的内容不应只有执行是否成功。对每次运行,都应保存生成的 SQL、检索到的概念和关系、应用的过滤条件以及最终结果。检查查询是否使用了预期定义、保持了正确粒度、连接了正确实体,并回答了领域专家实际提出的问题。NVIDIA 的代码库介绍了可回答性检查,并会随答案返回 SQL 和智能体执行步骤;这些产物应成为评估的一部分,而不是在界面显示结果后被丢弃。(Auto Ontology README)
负面测试必不可少。可以询问一个含义过载的术语,省略必要的时间边界,或请求模式并不支持的关系。理想行为可能是要求澄清,或明确指出该问题无法回答。如果智能体悄悄选中了一个方便使用的表,那么即使生成了一个看似精确的数字,也不能算成功。MCP 文档同样提供了 check_answerable,并且其 ask_question 工具会将答案、SQL 和行作为独立字段返回,这让智能体测试框架更容易检查这一行为。(MCP 文档)
最后,应对失败进行分类,而不是把结果压缩成一个准确率数字:业务定义错误、连接无效、粒度不正确、缺少筛选条件、提出了不受支持的断言,或只是 SQL 效率不高。将审核后的修正反馈到术语表和关系中,再次运行同一组已知答案的问题。只有当每次元数据变更都可审核、可追溯时,这才会形成有用的反馈循环。如果本体 grounding 能在定义明确的问题上改善语义准确性、澄清行为和可追溯性,那么它就值得继续测试。但这本身并不能证明任意企业查询都可靠。
实际运行需要什么
NVIDIA Auto Ontology 更像一个小型数据平台,而不是执行一条命令就能添加到现有智能体中的软件包。仓库说明的部署由多个服务组成:负责 Web 界面的前端、提供应用和 API 接口的后端、连接企业数据源并构建本体的数据摄取服务,以及使用 pgvector 保存应用状态并支持向量检索的 Postgres。文档给出的路径包括用于本地或单主机部署的 Docker Compose,以及更偏向运维场景的 Kubernetes。这种划分很重要,因为测试的关键不只是本体能否给出更好的答案,还在于团队能否让服务、数据库、模型端点和凭据作为一个整体持续保持一致。
模型层也是一项明确的依赖。Auto Ontology 的设计支持 NVIDIA NIM 端点或兼容的模型端点,其配置覆盖的并不只是用于理解问题的语言模型。嵌入模型和重排序方案也会影响答案生成前元数据及候选上下文的选择。实际而言,即使使用相同的源模式,只要模型、嵌入或重排序配置不同,两套安装的表现就可能不同。因此,有价值的评估应将这些设置与问题及输出一并记录。否则,检索或模型配置的变化可能会被误认为是本体本身带来的改进。
数据库侧同样有明确边界。项目计划连接受支持的企业数据库,并将其元数据作为输入;Postgres 和 pgvector 则负责 Auto Ontology 自身的持久化与检索需求。这就在被描述的数据库与 Auto Ontology 使用的存储之间形成了边界。在输入任何凭据前,试运行应先明确这条边界:确定将读取哪些源系统、会收集哪些元数据或血缘信息、生成的本体存储在哪里,以及哪些服务获准访问各个端点。这个架构可以管理,但它不是一个无需基础设施决策、能够直接放进智能体运行时的轻量级单二进制安装。
将生成的上下文提供给智能体,主要有两种方式。项目提供了面向应用的 API 路径,允许应用直接调用其服务;MCP 文档则介绍了一个可供兼容 MCP 的智能体测试框架使用的 MCP 服务器。当智能体已经具备发现和调用工具的能力时,MCP 很有用;对于受控应用或评估脚本,API 则是更直接的集成点。无论采用哪种方式,智能体都不是在查询某个神奇的第二数据库,而是在调用 Auto Ontology 的语义和检索能力,将业务定义、关系及相关元数据纳入请求或查询流程。
这一差异应当决定首次测试的方式。先选择一个规模较小且不敏感的数据库,或一份具有代表性的架构,启动 Compose 部署,并在接入智能体之前,分别验证前端、后端、摄取路径、Postgres/pgvector 存储以及模型端点。随后,通过 API 或 MCP 路径,用同一组固定问题进行测试,同时保持模型、嵌入、重排序和源配置不变。检查的不应只是最终生成的文字答案,还要确认生成的 SQL 是否有效、是否使用了预期的表和定义,以及系统是否提供了足够的溯源信息来解释结果。一次演示问题回答正确,并不能证明整个集成是可靠的。
因此,运维成本也是产品评估的一部分。团队需要容器编排、持久化的 Postgres 服务、模型访问权限、连接源数据库的网络路由,以及一套应对多个独立组件升级和故障的方案。Kubernetes 可能有助于在组织规模上实现可重复部署,但也会让所有权和可观测性变得更加重要;Docker Compose 可以缩短范围明确的评估周期,却无法解决生产环境中的问题。决定是否超出测试阶段的合理门槛,不是界面能否运行,而是团队能否复现这套配置、限制访问、识别哪个组件生成了答案,并在移除或替换本体服务后,不让智能体或源系统处于含义不明的状态。
许可证、凭据,以及保持谨慎的理由
从许可证角度看,Apache-2.0 让 Auto Ontology 相对容易评估:团队可以依据许可证条款检查、运行、修改和再分发项目。NVIDIA 也发布了容器制品,并单独列出第三方组件。这对技术评估很有帮助,但不应将其等同于完整的生产支持承诺。仓库说明 Auto Ontology 团队负责维护代码,不接受外部拉取请求;集成请求和错误报告则通过 issue 处理。实际采用时,应假设重要修复、版本决策以及涉及安全的变更仍取决于维护团队。
这一所有权模式之所以重要,是因为项目足够庞大,包含多个运维边界:Web 前端与身份验证层、FastAPI 后端和摄取服务、带 pgvector 的 PostgreSQL、模型端点、数据库连接器以及 MCP 桥接层。有一条公开 issue 还指出,文档仍将该仓库描述为 NVIDIA 内部项目,尽管仓库已经公开。这种不一致本身并不是漏洞,但说明在团队将快速入门指南视为权威操作流程之前,应当对照代码、部署清单和已发布镜像进行检查。同样的审查还应确认:哪些镜像标签、Helm values、API 路由和模型端点获准用于目标环境。
最需要重视的警告涉及凭据存储。通过界面添加的连接,会根据是否配置 HashiCorp Vault 而采用不同的存储方式。未配置 Vault 时,完整的连接对象(包括密码)会未经加密地序列化到 PostgreSQL 目录表的一行中。Vault 会改变这一安排:凭据被单独存储,目录表中不再保留凭据;但 Vault 是可选项,部分配置还会在发出警告后退回明文存储。因此,这个设置是架构控制,而不是一个次要的便利功能。在连接生产数据仓库之前,安全团队应核实实际的 Vault 配置,检查数据库备份和副本,限制目录访问,并确认不需要读取连接记录的角色无法读取这些记录。
内部服务边界同样值得重视。项目文档指出,FastAPI 后端和摄取服务使用的端口应始终保留在私有网络中。前端会将用户身份传递给后端,而 ingest、delete、reset 和 compile 等摄取操作本身并没有独立的身份验证。因此,预期的访问路径应是经过身份验证的 Web 应用或公共 API 网关,而不是直接暴露这些 FastAPI 服务。若将内部端口发布到负载均衡器之后、开放给范围过大的集群网络,或假定 MCP 客户端会提供缺失的授权,就会破坏这一部署模型所依赖的边界。
模型和托管服务的选择又带来一个数据治理问题。默认配置使用 NVIDIA 托管的模型端点,也可以按角色配置自托管 NIM 或兼容端点。启用后,预测类问题还可以路由至 KumoRFM;文档称,连接的表可能会上传到该托管服务,具体受其配置限制和条款约束。因此,评估时应记录架构元数据、采样值、提示词、生成的 SQL 以及查询结果会流向何处。“开源”描述的是 Auto Ontology 代码,并不会自动使所配置的模型提供商、连接器、数据库或托管预测服务属于同一个信任边界。
合理的采用路径,是先开展一次受控试点:使用合成数据或非敏感数据;通过网络策略确保内部服务保持私有;在通过界面添加凭据前启用 Vault;并有意选择模型端点。应通过智能体实际使用的相同 API 和 MCP 路径,测试身份验证及角色行为。保留一份已知可用的本体导出文件、数据库访问配置和部署版本,以便团队在不丢失参考状态的情况下停用编译或回滚。随后,在投入生产前要求独立的安全审查,包括检查机密信息、日志、备份、出站流量、依赖项来源,以及每个连接数据源上的权限。
实际结论比“Auto Ontology 已准备就绪”或“Auto Ontology 不安全”更具体。只要测试将部署和数据处理视为产品的一部分,而非安装细节,它就已经适合作为元数据与智能体上下文层进行测试。Apache-2.0 许可证降低了检查代码的门槛,但未使用 Vault 时以明文存储连接信息、未经身份验证的内部服务端点、托管模型的信任边界,以及由维护者控制的变更,都提出了演示无法回答的问题。正确的验证方式,是先进行一次规模较小且可逆的部署,在允许本体接触敏感企业数据之前,完整展示其安全控制、查询行为和回滚流程。
Related articles
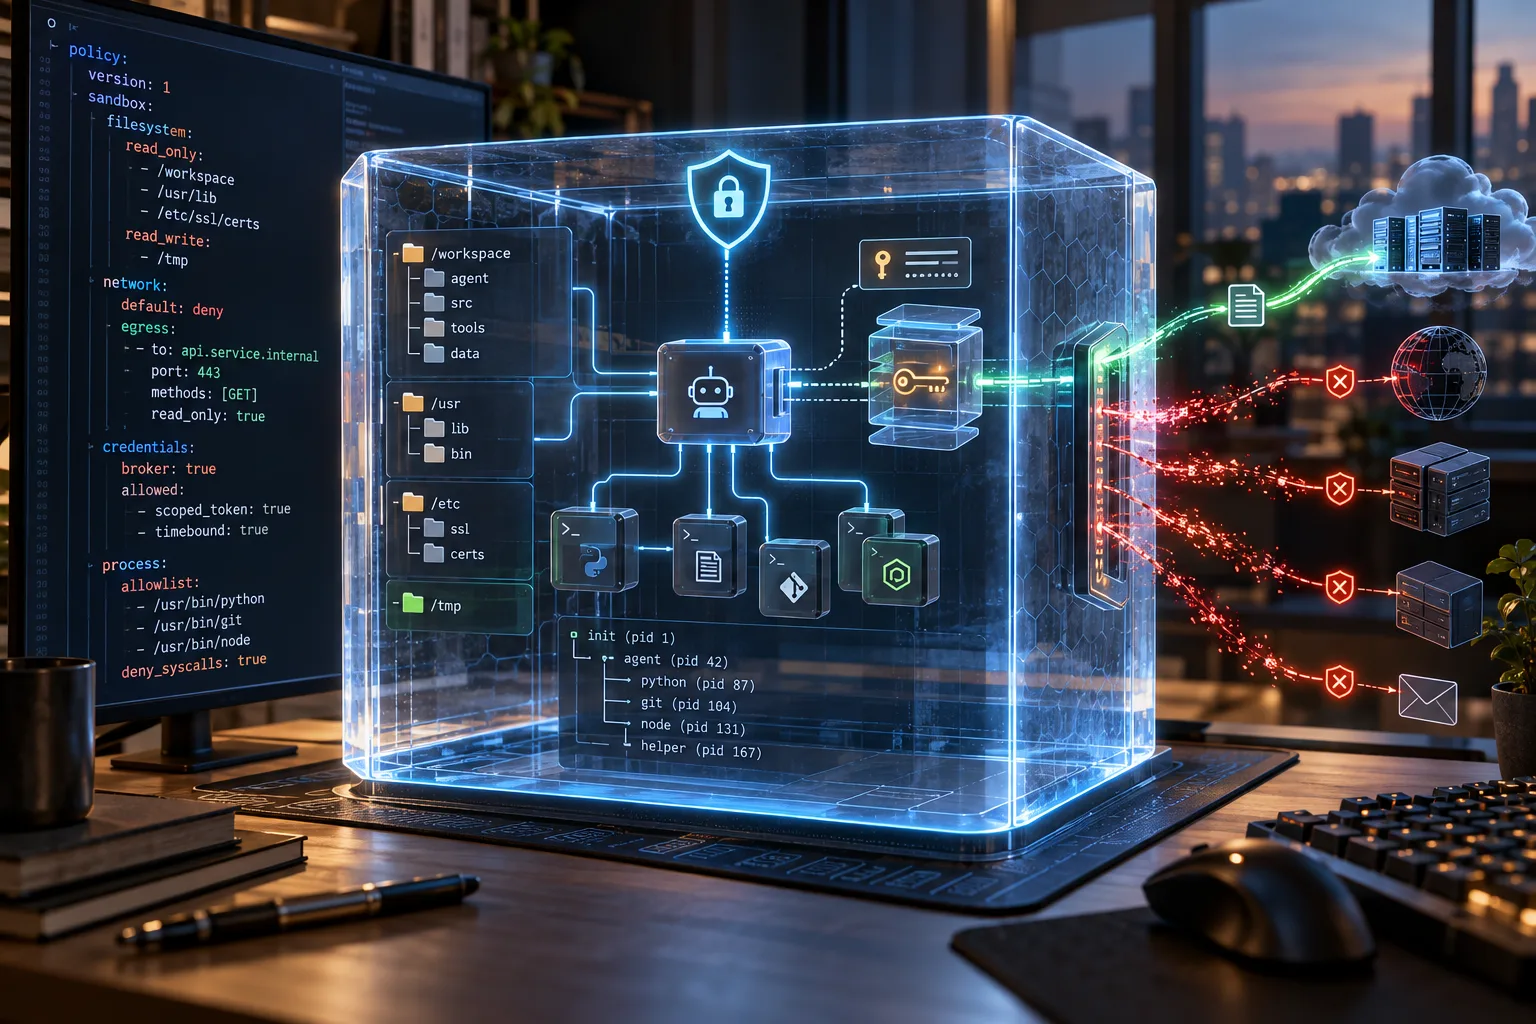
NVIDIA OpenShell:让智能体权限受策略控制——当前值得测试到什么程度
NVIDIA OpenShell 把 Codex、Claude Code 等智能体放进受策略约束的沙箱,限制文件、进程、网络和凭据权限。它值得用于安全实验与受控开发,但快速跑通示例并不等于适合生产环境。
Nvidia 与 Hugging Face 传闻谈判,让模型中心成为平台风险
这不是已确认的收购,但提醒 AI 团队:模型中心是战略依赖,不只是中立的权重下载目录。
Mistral Large 4 est disponible en poids ouverts. Le vrai test est de savoir si vous pouvez l’exécuter
Mistral a publié les poids de son modèle multimodal d’un billion de paramètres. La question n’est plus seulement l’accès à une API, mais le matériel, les logiciels de service, la licence et l’utilité d’un déploiement local pour votre équipe.
NVIDIA OpenShell puts agent permissions under policy control — what is ready to test
NVIDIA OpenShell is an Apache-licensed runtime for placing coding and autonomous agents inside policy-controlled sandboxes. Its useful idea is not another agent framework, but a boundary around files, processes, networks, credentials, and policy changes.
Comments
Sign in to comment.
No comments yet.