NVIDIA Auto Ontology превращает корпоративные метаданные в контекстный слой для агентов — что уже можно тестировать
Новый проект NVIDIA Auto Ontology под лицензией Apache-2.0 делает бизнес-определения, происхождение данных и связи явными, чтобы агент точнее формировал запросы. Практический вопрос — впишутся ли его развёртывание и модель учётных данных в реальный стек.
Что выпустила NVIDIA и для чего нужен онтологический слой
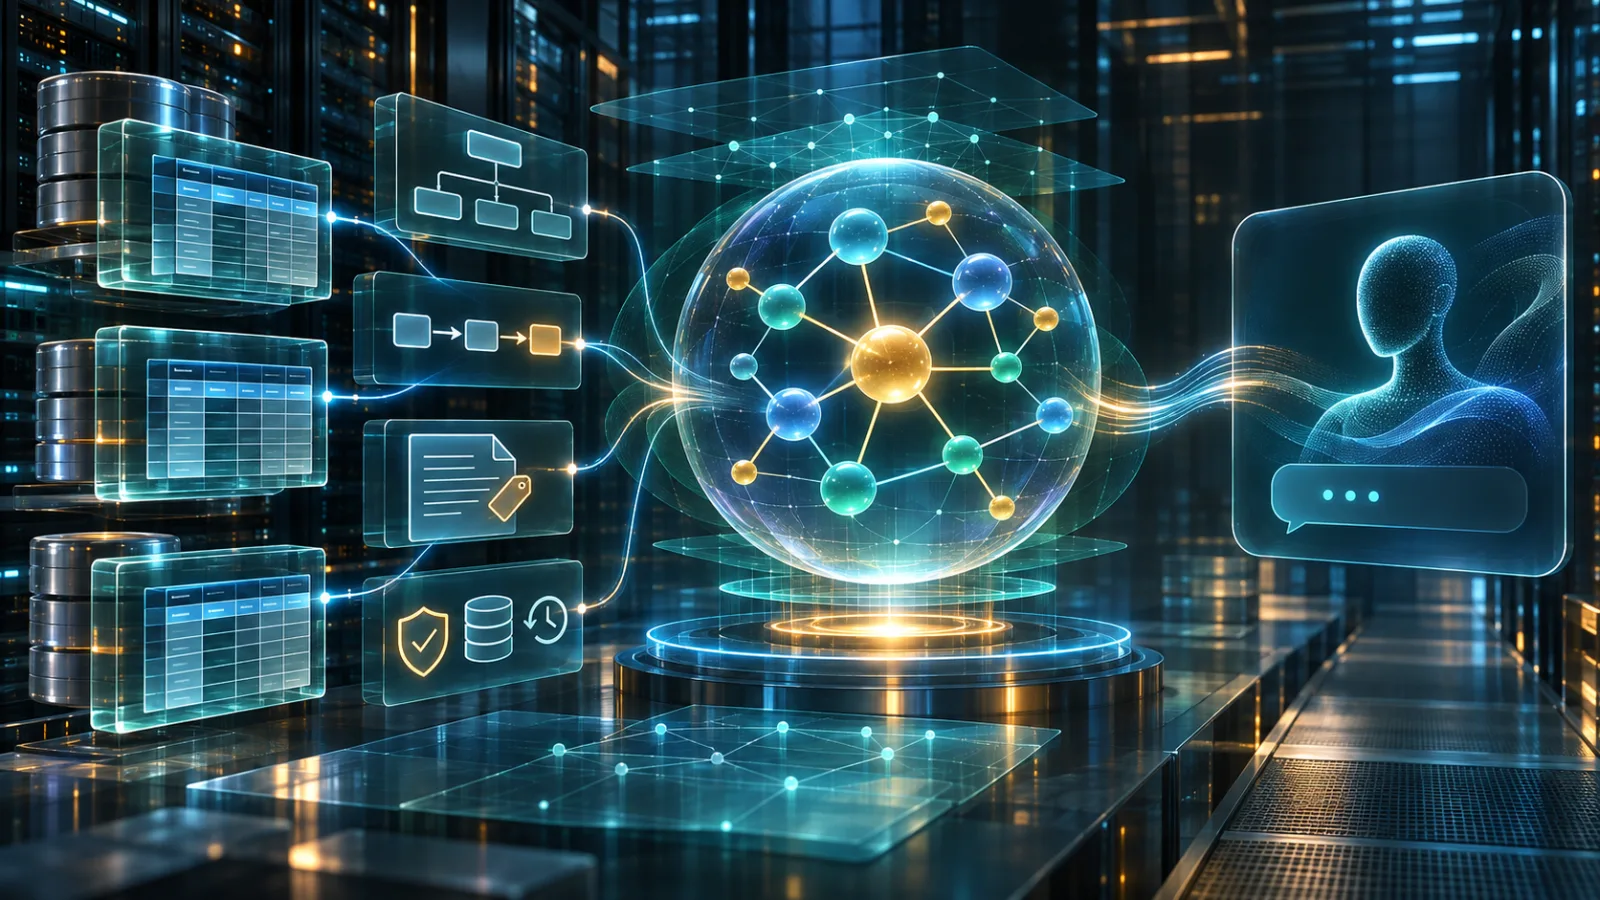
NVIDIA Auto Ontology представлен как Python-фреймворк под лицензией Apache-2.0, который превращает корпоративные метаданные в структурированный контекстный слой для агентов, работающих с данными. Он не призван заменять языковую модель, базу данных или обычный каталог данных. Вместо этого фреймворк располагается между этими системами: собирает сведения о таблицах, столбцах, бизнес-определениях, связях, происхождении и источниках данных, а затем организует их так, чтобы агент мог использовать эту информацию при интерпретации вопроса и составлении аналитического запроса.
Это различие важно: агент способен сгенерировать синтаксически корректный SQL и при этом неверно понять бизнес-смысл запроса. В базе данных могут находиться несколько версий данных о выручке, клиентах, отгрузках или активности — с разными временными границами и владельцами. Модель, которая видит только названия таблиц и описания столбцов, может выбрать правдоподобное поле, не зная, какое определение утверждено, как рассчитывается метрика и какая исходная система считается авторитетной. Auto Ontology призван явно обозначить эти связи, а не оставлять их на усмотрение ассоциаций, выведенных моделью.
В репозитории описан фреймворк, способный создавать корпоративные онтологии из метаданных или подключаться к ним, а также согласовывать определения между системами. На практике онтология представляет собой машиночитаемое описание концепций, используемых в данных организации, и связей между ними. Она может связывать бизнес-термин с физическими структурами данных, объединять связанные сущности, сохранять происхождение данных и фиксировать сведения об источнике, необходимые для понимания того, откуда взялись определение или связь. В результате получается не столько набор документов, извлекаемых для промпта, сколько управляемая семантическая карта.
Auto Ontology также предоставляет доступ к этому контексту через несколько интерфейсов. В проект входят веб-приложение, API, интерфейс командной строки и интеграция с MCP, предназначенная для сред запуска агентов. Эти интерфейсы дают разные точки входа в один общий процесс: загрузить метаданные, построить или проверить онтологию и предоставить её семантическую информацию приложениям, которым нужно отвечать на вопросы о данных. MCP особенно актуален для команд, уже тестирующих агентов, способных вызывать инструменты: внешняя среда агента может обращаться к функциям, работающим на основе онтологии, вместо того чтобы встраивать весь каталог и процесс рассуждений в промпт.
Таким образом, поддерживаемая архитектура разделяет две задачи. Первая — корпоративная среда данных: базы, схемы, системы метаданных и определения, к которым подключается проект или которые он загружает. Вторая — слой онтологии и рассуждений, интерпретирующий эти входные данные и представляющий агенту релевантный контекст. Операционно такое разделение полезно. Онтологический слой может описывать источник, не становясь самим источником, и помогать агенту ориентироваться в нескольких системах, не требуя каждый раз заново выводить бизнес-правила из необработанной структуры базы данных.
Поэтому Auto Ontology не стоит оценивать как обычный продукт для векторного поиска. Семантический поиск может быть частью реализации, однако заявленная ценность проекта зависит от структурированных связей и метаданных, а не только от поиска текста, похожего на вопрос пользователя. Векторный индекс способен найти определение, но сам по себе не устанавливает, эквивалентны ли две метрики, какой набор данных является исходным или каким образом концепция соответствует пути соединения таблиц. Онтологическая модель должна сохранять эти связи, чтобы агент получал контекст вместе со структурой и возможностью проследить его происхождение.
Та же граница отделяет проект от конечной точки модели. Auto Ontology не делает агента надёжным просто за счёт добавления ещё одного шага генерации. Предполагаемый вклад проекта — контекст, который получает модель: определения, которым она должна следовать, сущности, которые может связывать, происхождение данных, которое может проверять, и сведения об источниках, позволяющие оценивать уверенность. Качество итогового ответа по-прежнему зависит от базовой модели, доступных для загрузки метаданных, конфигурации развёртывания и качества собственных определений организации.
Это делает проект интересным как тестируемый компонент инженерии данных, а не как обещание автоматической семантической корректности. Команда может проверить, меняет ли контекст, основанный на онтологии, поведение агента на контролируемом наборе бизнес-вопросов. Можно выяснить, использует ли сгенерированный запрос сертифицированное понятие, применяет ли подходящую связь и сохраняет ли заданную область данных. Важно также проверить объяснимость ответа: не только какие строки были возвращены, но и почему был выбран конкретный набор данных, определение или путь происхождения.
Поэтому первоначальный практический вопрос уже, чем вопрос о том, решает ли Auto Ontology задачу корпоративной аналитики. Нужно понять, способен ли фреймворк сделать существующего агента более чувствительным к словарю и структуре данных организации. Проект NVIDIA предлагает для такого эксперимента необходимые компоненты — загрузку метаданных, построение онтологии, семантический доступ через API или MCP и интерфейсы для управления системой, — но доказательства должны быть получены в рамках ограниченной проверки на известных схемах и с заранее известными ответами. Слой онтологии задуман как мост между необработанными корпоративными метаданными и рассуждениями агента; следующий вопрос — улучшает ли этот мост ответы там, где правильность определяется смыслом бизнеса, а не только синтаксисом SQL.
Полезный тест: улучшает ли бизнес-смысл ответы агента
Практическая задача, которую призван решать Auto Ontology, заключается не в том, способен ли агент сгенерировать выполняющийся SQL. Важно, отражает ли запрос бизнес-вопрос. Столбец с названием revenue может не содержать достаточно информации, чтобы агент выбрал нужное определение; таблица клиентов может описывать аккаунты, платёжные организации или конечных пользователей. В результате запрос окажется синтаксически корректным, численно правдоподобным, но семантически ошибочным. NVIDIA описывает Auto Ontology как способ заранее предоставить агентам явный контекст, включая бизнес-термины, сопоставленные со столбцами, проверенный SQL для показателей и связи между таблицами. (Repository README)
Такой контекст следует проверять как цепочку, а не принимать на веру как общее обещание. Бизнес-понятие должно разрешаться в определение, которое команда может изучить и, если необходимо, сертифицировать. В определении должны быть указаны соответствующие таблицы, столбцы или логика расчёта показателя; связи должны объяснять, какие объединения допустимы; происхождение должно показывать зависимость ответа от исходных активов; а информация о происхождении метаданных — делать видимым их источник. Ценность не в том, что агент звучит увереннее. Важно, чтобы проверяющий видел, почему было выбрано конкретное понятие и как оно привело к сгенерированному запросу.
Термин «сертифицированный» также должен означать больше, чем «созданный заданием загрузки». Полезный тест должен отделять определения, проверенные владельцем предметной области, от предложений, которые пока остаются предварительными. Если онтология определяет «активного клиента» согласно утверждённой бизнес-логике, вопросы с этой формулировкой должны разрешаться через соответствующий показатель или путь запроса. Если система не может показать, какое определение было использовано, какие связи поддержали объединение или какие исходные активы повлияли на ответ, семантический слой ещё не сделал результат достаточно подотчётным.
Ограниченная проверка информативнее широкой демонстрации. Начните с небольшой схемы, содержащей несколько таблиц фактов и измерений, поле даты и хотя бы один намеренно неоднозначный показатель. Подготовьте вопросы с известными ответами, включая случаи, требующие конкретного объединения, заданного отчётного периода или различения похожих метрик. Сначала пропустите каждый вопрос через обычный путь text-to-SQL со схемой и стандартной документацией, затем — через путь, использующий онтологию. Модель, данные и права доступа следует по возможности оставить неизменными, чтобы сравнение измеряло влияние контекстного слоя, а не посторонние изменения.
Фиксируйте не только успешность выполнения. Для каждого запуска сохраняйте сгенерированный SQL, извлечённые понятия и связи, применённые фильтры и итоговый результат. Проверяйте, использовал ли запрос нужное определение, сохранил ли правильную гранулярность, объединил ли нужные сущности и ответил ли на вопрос так, как его действительно сформулировал специалист предметной области. В репозитории NVIDIA описаны проверка возможности получить ответ, а также возврат SQL и шагов агента вместе с ответом; эти артефакты должны стать частью оценки, а не исчезать после отображения результата в интерфейсе. (Auto Ontology README)
Негативные тесты необходимы. Спросите о перегруженном термине, опустите обязательное временное ограничение или запросите связь, которую схема не поддерживает. Ожидаемым поведением в таком случае может быть просьба уточнить запрос или явное указание на то, что на него нельзя ответить. Безупречно оформленное число не является успехом, если агент молча выбирает удобную таблицу. В документации MCP также описан инструмент check_answerable, а инструмент ask_question возвращает ответ, SQL-запрос и строки отдельными полями, благодаря чему такое поведение проще проверять в агентском тестовом контуре. (документация MCP)
Наконец, классифицируйте сбои, а не сводите результат к одной цифре точности: неверное бизнес-определение, недопустимое соединение, неправильная гранулярность, пропущенный фильтр, неподтверждённое утверждение или просто неэффективный SQL. Проверенные исправления следует возвращать в глоссарий и набор связей, а затем повторно запускать на том же наборе вопросов с известными ответами. Такой цикл обратной связи полезен только тогда, когда каждое изменение метаданных можно проверить и связать с конкретным источником. Если привязка к онтологии повышает семантическую точность, улучшает поведение при уточнениях и делает ответы более прослеживаемыми в вопросах с явно заданными определениями, это достаточное основание для дальнейшего тестирования. Но само по себе это ещё не доказывает надёжность произвольных корпоративных запросов.
Что на самом деле требуется для запуска
NVIDIA Auto Ontology ближе к небольшой платформе данных, чем к пакету, который можно одной командой добавить в уже существующего агента. В репозитории описано развёртывание из нескольких сервисов: фронтенда для веб-интерфейса, бэкенда, предоставляющего приложение и API, сервисов загрузки, подключающихся к корпоративным источникам данных и строящих онтологию, а также Postgres с pgvector для состояния приложения и поиска на основе векторов. Документированные варианты — Docker Compose для локальной установки или запуска на одном хосте и Kubernetes для более операционного развёртывания. Это разделение важно: проверяется не только то, выдаёт ли онтология лучший ответ, но и способность команды поддерживать согласованную работу сервисов, баз данных, конечных точек моделей и учётных данных как единой системы.
Слой моделей — ещё одна явная зависимость. Auto Ontology рассчитана на работу с конечными точками NVIDIA NIM или совместимыми конечными точками моделей, причём конфигурация охватывает не только языковую модель, которая интерпретирует вопрос. Выбор моделей эмбеддингов и переранжирования также влияет на то, какие метаданные и кандидаты контекста будут отобраны до формирования ответа. На практике две установки с одной и той же исходной схемой могут вести себя по-разному, если в них используются разные конфигурации моделей, эмбеддингов или переранжирования. Поэтому полезная оценка должна фиксировать эти настройки вместе с вопросами и результатами. Иначе изменение конфигурации поиска или модели можно ошибочно принять за улучшение самой онтологии.
Сторона базы данных столь же конкретна. Проект рассчитан на подключение к поддерживаемым корпоративным базам данных и использование их метаданных в качестве входных данных, тогда как Postgres и pgvector обслуживают собственные потребности Auto Ontology в хранении и поиске. Так возникает граница между базами, которые описываются, и хранилищем, используемым Auto Ontology. До ввода любых учётных данных стоит описать эту границу: определить, какие исходные системы будут читаться, какие метаданные или сведения о происхождении данных будут собираться, где будет храниться полученная онтология и какому сервису разрешено обращаться к каждой конечной точке. Архитектура вполне управляема, но это не лёгкая установка в виде единого бинарного файла, которую можно без инфраструктурных решений встроить в среду выполнения агента.
Есть два основных способа передать полученный контекст агенту. Проект предоставляет API для приложений, которым нужно напрямую вызывать его сервисы, а документация MCP описывает MCP-сервер, который можно использовать с совместимым с MCP агентским тестовым контуром. MCP удобен, если агент уже умеет обнаруживать и вызывать инструменты, тогда как API является более прямой точкой интеграции для контролируемого приложения или оценочного скрипта. В обоих случаях агент не обращается к некой магической второй базе данных. Он вызывает семантические возможности Auto Ontology и её механизм поиска, чтобы бизнес-определения, связи и связанные метаданные могли быть включены в процесс формирования запроса или выполнения поиска.
Именно это различие должно определять первый тест. Начните с небольшой базы данных без чувствительных данных или репрезентативной схемы, разверните Compose и по отдельности проверьте фронтенд, бэкенд, путь загрузки данных, хранилище Postgres/pgvector и конечную точку модели — и только после этого подключайте агента. Затем задайте один и тот же набор фиксированных вопросов через API или MCP-маршрут, не меняя модель, эмбеддинги, ранжирование и конфигурацию источников. Проверяйте не только итоговый ответ в прозе, но и валидность сгенерированного SQL, использование нужных таблиц и определений, а также наличие достаточной информации о происхождении данных для объяснения результата. Корректный ответ на один демонстрационный вопрос ещё не доказывает надёжность всей интеграции.
Поэтому эксплуатационные затраты — часть вопроса о самом продукте. Командам нужны оркестрация контейнеров, постоянный сервис Postgres, доступ к моделям, сетевые маршруты к исходным базам данных и план обновлений и отказоустойчивости для отдельных компонентов. Kubernetes может сделать такой процесс воспроизводимым в масштабе организации, но одновременно повышает требования к распределению ответственности и наблюдаемости; Docker Compose способен ускорить ограниченную оценку, оставляя вопросы промышленной эксплуатации нерешёнными. Разумный порог перехода от теста к следующему этапу определяется не тем, работает ли интерфейс, а тем, может ли команда воспроизвести настройку, ограничить доступ, определить, какой компонент сформировал ответ, а также удалить или заменить сервис онтологии, не оставив агента или исходные системы в неоднозначном состоянии.
Лицензия, учётные данные и причины сохранять осторожность
Apache-2.0 делает Auto Ontology относительно простым для оценки с точки зрения лицензирования: команды могут изучать, запускать, изменять и распространять проект на условиях этой лицензии. NVIDIA также публикует артефакты контейнеров и отдельно указывает сторонние компоненты. Это полезно для технической оценки, но не следует путать с полным обязательством по промышленной поддержке. В репозитории сказано, что команда Auto Ontology сопровождает код и не принимает внешние pull request’ы; запросы на интеграцию и сообщения об ошибках обрабатываются как issues. На практике внедряющей команде стоит исходить из того, что важные исправления, решения о релизах и изменения, связанные с безопасностью, по-прежнему зависят от команды сопровождающих.
Эта модель владения важна, поскольку проект достаточно велик и включает несколько эксплуатационных границ: веб-фронтенд и слой аутентификации, бэкенд на FastAPI и сервисы загрузки данных, PostgreSQL с pgvector, конечные точки моделей, коннекторы к базам данных и мост MCP. В одном из публичных issues также отмечается, что документация всё ещё описывает репозиторий как внутренний для NVIDIA, хотя сам репозиторий открыт. Само по себе это расхождение не является уязвимостью, но показывает, что перед использованием quickstart в качестве авторитетной инструкции по эксплуатации документацию нужно сверить с кодом, манифестами развёртывания и опубликованными образами. В ходе той же проверки следует подтвердить, какие теги образов, значения Helm, маршруты API и конечные точки моделей одобрены для целевой среды.
Самое существенное предупреждение касается хранения учётных данных. Подключения, добавленные через интерфейс, хранятся по-разному в зависимости от того, настроен ли HashiCorp Vault. Без Vault весь объект подключения, включая пароль, сериализуется в строку каталога PostgreSQL без шифрования. Vault меняет эту схему: учётные данные хранятся отдельно, а в строке каталога их нет. Однако Vault необязателен, и при неполной конфигурации система возвращается к хранению в открытом виде и выдаёт предупреждение. Поэтому это архитектурный механизм контроля, а не второстепенное удобство. Перед подключением промышленного хранилища данных командам безопасности следует проверить фактическую конфигурацию Vault, изучить резервные копии и реплики базы данных, ограничить доступ к каталогу и убедиться, что записи о подключениях не могут читать роли, которым они не нужны.
Граница внутренних сервисов заслуживает такого же внимания. В документации проекта сказано, что порты, используемые бэкендом FastAPI и сервисом загрузки данных, должны оставаться в частной сети. Фронтенд передаёт идентификатор пользователя бэкенду, тогда как операции загрузки, удаления, сброса и компиляции не имеют собственной аутентификации. Поэтому предполагаемый путь проходит через аутентифицированное веб-приложение или публичный API-шлюз, а не через прямое открытие этих сервисов FastAPI. Публикация внутренних портов за балансировщиком, доступ к ним из широкой кластерной сети или предположение, что MCP-клиент сам добавляет недостающую авторизацию, разрушит границу, на которой держится модель развёртывания.
Выбор моделей и хостинговых сервисов добавляет ещё один вопрос управления данными. Конфигурация по умолчанию использует размещённые NVIDIA конечные точки моделей, а для отдельных ролей можно настроить самостоятельно размещаемые NIM или совместимые конечные точки. При включении предиктивные вопросы также могут направляться в KumoRFM; в документации указано, что подключённые таблицы могут загружаться в этот размещённый сервис с учётом ограничений его конфигурации и условий использования. Поэтому при оценке следует фиксировать, куда передаются метаданные схемы, выборочные значения, промпты, сгенерированный SQL-код и результаты запросов. «Открытый исходный код» описывает код Auto Ontology, но автоматически не означает, что настроенный провайдер моделей, коннектор, база данных или размещённый сервис прогнозирования входят в ту же границу доверия.
Разумный путь внедрения — ограниченный пилот на синтетических или не содержащих чувствительных данных, с сетевыми политиками, сохраняющими внутренние сервисы закрытыми, включённым Vault до добавления учётных данных через интерфейс и осознанно выбранными конечными точками моделей. Аутентификацию и поведение ролей следует проверять через те же API- и MCP-пути, которыми будут пользоваться агенты. Нужно сохранить заведомо рабочий экспорт онтологии, конфигурацию доступа к базе данных и версию развёртывания, чтобы команда могла отключить компиляцию или выполнить откат без потери исходного состояния. Перед использованием в продуктивной среде необходима независимая проверка безопасности: она должна охватывать секреты, журналы, резервные копии, исходящий трафик, происхождение зависимостей и права доступа для каждого подключённого источника.
Практический вывод уже, чем утверждения «Auto Ontology готова» или «Auto Ontology небезопасна». Её можно тестировать как слой метаданных и контекста для агентов, если рассматривать развёртывание и обработку данных как часть продукта, а не как технические детали настройки. Лицензия Apache-2.0 упрощает проверку кода, но хранение подключений в открытом виде без Vault, неаутентифицированные внутренние конечные точки сервисов, границы размещённых моделей и изменения под контролем сопровождающих оставляют вопросы, на которые демонстрация не ответит. Надёжное подтверждение — небольшое обратимое развёртывание, в котором до допуска онтологии к чувствительным корпоративным данным продемонстрированы средства защиты, поведение запросов и процедура отката.
Related articles
NVIDIA OpenShell передаёт права агентов под управление политик — что уже можно тестировать
NVIDIA OpenShell — рантайм с лицензией Apache 2.0, который помещает кодинговых и автономных агентов в песочницы с заданными правилами. Его ключевая идея — граница вокруг файлов, процессов, сети, учётных данных и изменений политик.
Переговоры Nvidia и Hugging Face превращают model hub в platform risk
Это не подтверждённая покупка, но сигнал для AI-команд: model hub нужно учитывать как стратегическую зависимость, а не нейтральную папку с весами.
Mistral Large 4 est disponible en poids ouverts. Le vrai test est de savoir si vous pouvez l’exécuter
Mistral a publié les poids de son modèle multimodal d’un billion de paramètres. La question n’est plus seulement l’accès à une API, mais le matériel, les logiciels de service, la licence et l’utilité d’un déploiement local pour votre équipe.
NVIDIA OpenShell puts agent permissions under policy control — what is ready to test
NVIDIA OpenShell is an Apache-licensed runtime for placing coding and autonomous agents inside policy-controlled sandboxes. Its useful idea is not another agent framework, but a boundary around files, processes, networks, credentials, and policy changes.
Comments
Sign in to comment.
No comments yet.