تحوّل NVIDIA Auto Ontology البيانات الوصفية للمؤسسات إلى طبقة سياق للوكلاء — ما الذي أصبح جاهزًا للاختبار؟
يعدّ مشروع NVIDIA Auto Ontology، المرخّص بموجب Apache-2.0، بجعل استعلامات الوكلاء أكثر موثوقية عبر توضيح التعريفات والعلاقات وسلسلة النَسَب ومصدر البيانات. والسؤال العملي: هل يناسب نموذج نشره وبيانات اعتماده مكدس بيانات حقيقيًا؟
ما الذي أطلقته NVIDIA وما الدور المفترض لطبقة الأنتولوجيا؟
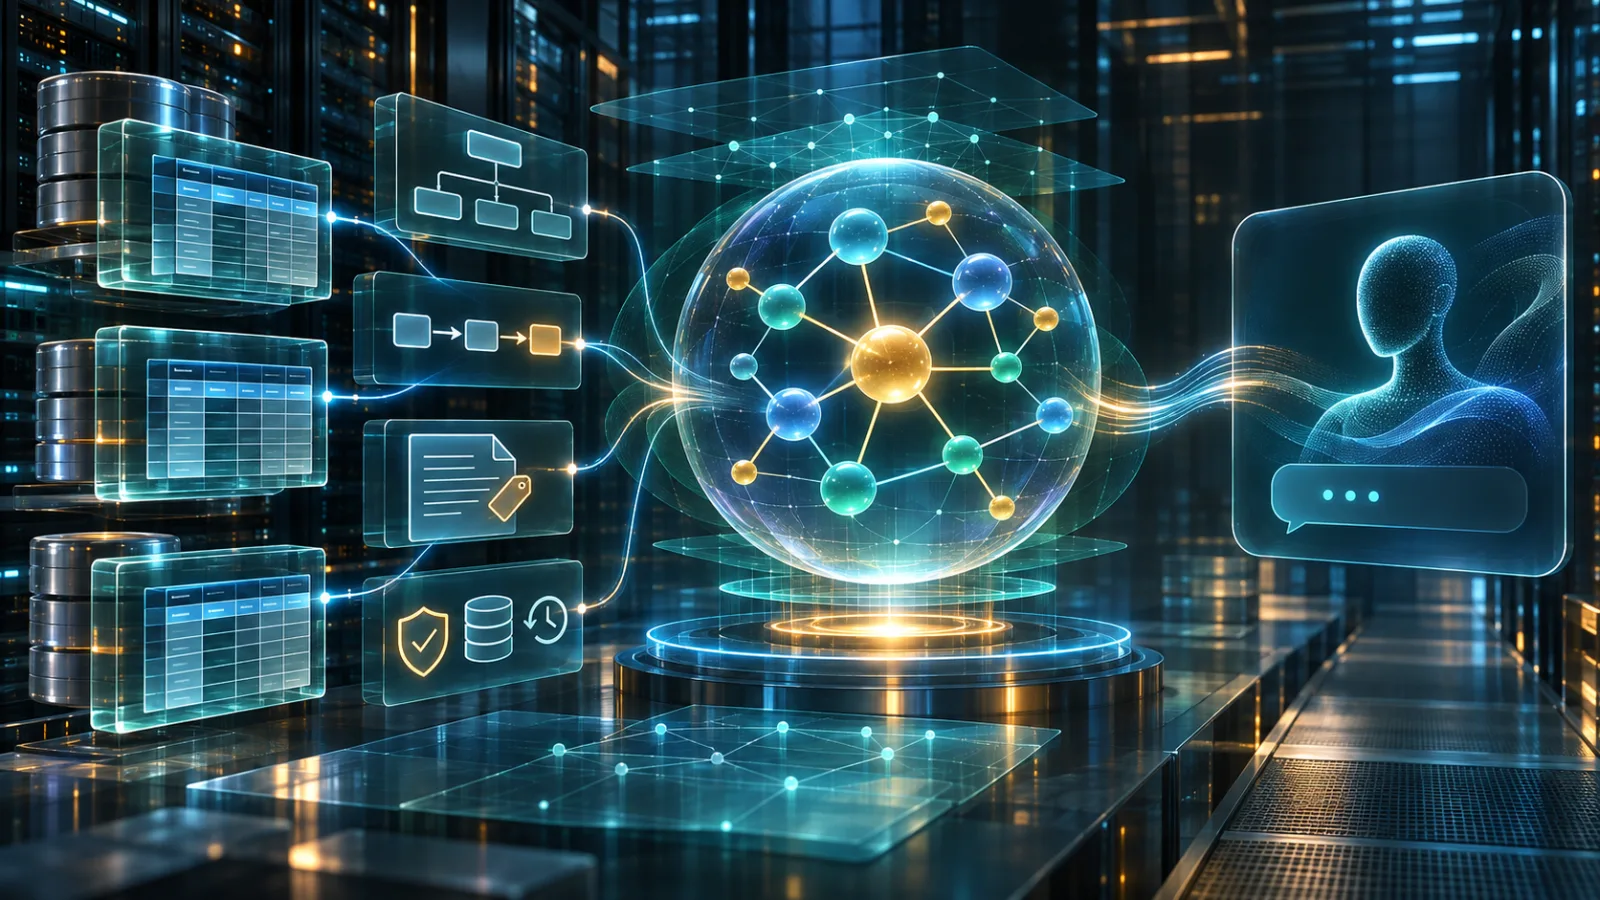
تقدّم NVIDIA Auto Ontology إطار عمل بلغة Python، مرخّصًا بموجب Apache-2.0، لتحويل البيانات الوصفية للمؤسسات إلى طبقة سياق منظّمة لوكلاء البيانات. ولا يهدف المشروع إلى استبدال نموذج لغوي أو قاعدة بيانات أو فهرس بيانات تقليدي. بل يقع بين هذه الأنظمة: إذ يجمع معلومات عن الجداول والأعمدة وتعريفات الأعمال والعلاقات وسلسلة النَسَب ومصدر البيانات، ثم ينظّمها بحيث يستطيع الوكيل استخدامها عند تفسير السؤال وتكوين استعلام تحليلي.
وتكمن أهمية هذا التمييز في أن الوكيل قد ينتج SQL صحيحًا من الناحية النحوية، لكنه يسيء فهم المعنى التجاري للطلب. فقد تحتوي قاعدة البيانات على إصدارات متعددة من بيانات الإيرادات أو العملاء أو الشحنات أو الأنشطة، ولكل إصدار حدود زمنية وملكية مختلفة. وقد يختار نموذج لا يرى سوى أسماء الجداول وأوصاف الأعمدة حقلًا يبدو مناسبًا، من دون أن يعرف أي تعريف حُظي بالاعتماد، أو كيفية اشتقاق مقياس معين، أو أي نظام من الأنظمة السابقة هو المرجع الموثوق. وتهدف Auto Ontology إلى جعل هذه الروابط صريحة، بدل تركها للارتباطات التي يستنتجها النموذج.
يصف المستودع إطارًا قادرًا على إنشاء أنتولوجيات المؤسسات من البيانات الوصفية أو ربطها بها، وتسوية التعريفات بين الأنظمة. وعمليًا، تمثل الأنتولوجيا تمثيلًا مقروءًا آليًا لمفاهيم بيانات المؤسسة والعلاقات بينها. ويمكنها ربط مصطلح تجاري بهياكل البيانات الفعلية، ووصل الكيانات ذات الصلة، والحفاظ على سلسلة النَسَب، والاحتفاظ بمصدر البيانات اللازم لفهم أصل تعريف أو علاقة ما. والنتيجة أقرب إلى خريطة دلالية محكومة منها إلى مجموعة مستندات تُسترجع من أجل مطالبة.
وتعرض Auto Ontology هذا السياق أيضًا عبر عدة واجهات. فالمشروع يتضمن تطبيق ويب، وواجهة API، وواجهة سطر أوامر، وتكاملًا مع MCP مخصصًا لبيئات تشغيل الوكلاء. وتوفر هذه الواجهات نقاط دخول مختلفة إلى سير العمل الأوسع نفسه: إدخال البيانات الوصفية، وإنشاء الأنتولوجيا أو مراجعتها، وإتاحة معلوماتها الدلالية للتطبيقات التي تحتاج إلى الإجابة عن أسئلة البيانات. ويكتسب MCP أهمية خاصة للفرق التي تختبر وكلاء يستخدمون الأدوات، لأنه يتيح لبيئة وكيل خارجية استدعاء قدرات مدعومة بالأنتولوجيا، بدل تضمين الفهرس الكامل وعملية الاستدلال في مطالبة واحدة.
لذلك تفصل البنية المدعومة بين جانبين مستقلين. الأول هو بيئة بيانات المؤسسة: قواعد البيانات والمخططات وأنظمة البيانات الوصفية والتعريفات التي يتصل بها المشروع أو يستوعبها. والثاني هو طبقة الأنتولوجيا والاستدلال التي تفسر تلك المدخلات وتعرض السياق المناسب للوكيل. ويفيد الفصل بين الجانبين تشغيليًا؛ إذ تستطيع طبقة الأنتولوجيا وصف مصدر من دون أن تصبح هي المصدر نفسه، كما يمكنها مساعدة الوكيل على التنقل بين عدة أنظمة من دون إلزامه بإعادة اكتشاف كل قاعدة عمل من بنية قاعدة البيانات الخام.
ولهذا السبب أيضًا لا ينبغي تقييم Auto Ontology باعتبارها منتجًا عامًا للبحث المتجهي. فقد يكون الاسترجاع الدلالي جزءًا من التنفيذ، لكن القيمة المعلنة للمشروع تعتمد على العلاقات المنظّمة والبيانات الوصفية، لا على العثور ببساطة على نص يشبه سؤال المستخدم. يستطيع فهرس متجهي استرجاع تعريف ما، لكنه لا يثبت بمفرده ما إذا كان مقياسان متكافئين، أو أي مجموعة بيانات تقع في المنبع، أو كيف يرتبط مفهوم بمسار ربط. ونموذج الأنتولوجيا مصمم للحفاظ على هذه الروابط، كي يتلقى الوكيل سياقًا منظمًا وقابلًا للتتبع.
والحد الفاصل نفسه يميّز المشروع عن نقطة نهاية لنموذج. فلا تجعل Auto Ontology الوكيل موثوقًا لمجرد إضافة خطوة توليد أخرى. وتتمثل مساهمتها المقترحة في السياق الذي تقدمه للنموذج: التعريفات التي ينبغي له الالتزام بها، والكيانات التي يستطيع ربطها، وسلسلة النَسَب التي يمكنه فحصها، ومصدر البيانات الذي يمكنه استخدامه لتقدير مستوى الثقة. ومع ذلك تظل جودة الإجابة النهائية رهينة بالنموذج الأساسي، والبيانات الوصفية المتاحة للإدخال، وإعدادات النشر، وجودة التعريفات التي تضعها المؤسسة نفسها.
وهذا ما يجعل المشروع مثيراً للاهتمام بوصفه مكوّناً قابلاً للاختبار في هندسة البيانات، لا باعتباره وعداً بصحة دلالية تلقائية. يمكن للفريق أن يسأل ما إذا كان السياق المستند إلى الأنطولوجيا يغيّر سلوك الوكيل عند طرح مجموعة مضبوطة من أسئلة الأعمال. ويمكنه فحص ما إذا كان الاستعلام المُنشأ يستخدم المفهوم المعتمَد، ويتبع علاقة مناسبة، ويحافظ على النطاق المقصود. كما يمكنه التحقق من بقاء الإجابة قابلة للتفسير: ليس فقط معرفة الصفوف التي أُعيدت، بل سبب اختيار مجموعة بيانات أو تعريف أو مسار نسبٍ معيّن.
لذلك، فإن السؤال العملي الأول أضيق من معرفة ما إذا كانت Auto Ontology تحل مشكلة تحليلات المؤسسات. السؤال هو: هل يستطيع الإطار جعل وكيلاً قائماً أكثر وعياً بمفردات بيانات المؤسسة وبنيتها؟ يوفّر مشروع NVIDIA مكوّنات هذه التجربة—استيعاب البيانات الوصفية، وبناء الأنطولوجيا، والوصول الدلالي عبر واجهة API أو MCP، وواجهات تشغيل النظام—لكن البرهان يجب أن يأتي من تقييم محدود مقابل مخططات معروفة وإجابات معروفة. طبقة الأنطولوجيا هي الجسر المقترح بين البيانات الوصفية الخام للمؤسسة واستدلال الوكيل؛ والسؤال التالي هو ما إذا كان هذا الجسر يحسّن الإجابات في الحالات التي يحدد فيها المعنى التجاري الصواب، لا صياغة SQL وحدها.
الاختبار المفيد: هل يستطيع المعنى التجاري تحسين إجابات الوكيل؟
المشكلة العملية التي تستهدفها Auto Ontology ليست معرفة ما إذا كان الوكيل يستطيع إنتاج SQL قابلة للتنفيذ، بل ما إذا كان الاستعلام يمثّل سؤال الأعمال. فقد لا يحمل عمود اسمه revenue معلومات كافية لإخبار الوكيل بالتعريف الذي ينبغي استخدامه؛ وقد يصف جدول العملاء الحسابات أو الكيانات المفوترة أو المستخدمين النهائيين. وقد تكون النتيجة صحيحة نحويّاً، ومعقولة رقمياً، وخاطئة دلالياً. وتصف NVIDIA نظام Auto Ontology بأنه وسيلة لمنح الوكلاء سياقاً صريحاً قبل الاستعلام، بما في ذلك مصطلحات الأعمال المرتبطة بالأعمدة، وعبارات SQL المُراجَعة للمقاييس، والعلاقات بين الجداول. (مستند README للمستودع)
ينبغي اختبار هذا السياق كسلسلة مترابطة، لا قبوله بوصفه وعداً عاماً. يجب أن يُحال مفهوم الأعمال إلى تعريف يستطيع الفريق فحصه واعتماده عند الاقتضاء. وينبغي أن يحدد التعريف الجداول أو الأعمدة ذات الصلة، أو منطق المقياس؛ كما ينبغي أن توضّح العلاقات أي عمليات ربط مشروعة، وأن يبيّن النسب كيف تعتمد الإجابة على الأصول السابقة، وأن يجعل مصدر البيانات الوصفية ظاهراً. فالقيمة ليست في أن يبدو الوكيل أكثر ثقة. القيمة في أن يتمكن المراجع من رؤية سبب اختيار مصطلح ما وكيف قاده ذلك إلى الاستعلام المُنشأ.
وينبغي أن يعني مصطلح «معتمَد» أكثر من «أنشأته مهمة استيعاب». فالاختبار المفيد يجب أن يميّز بين التعريفات التي راجعها مالك المجال وبين الاقتراحات التي لا تزال مؤقتة. فإذا عرّفت الأنطولوجيا «العميل النشط» وفق منطق أعمال معتمد، فينبغي أن تُحال الأسئلة التي تستخدم هذه العبارة إلى المقياس أو مسار الاستعلام المقابل. وإذا لم يستطع النظام إظهار التعريف المستخدم، أو العلاقات التي دعمت عملية الربط، أو الأصول المصدرية التي أسهمت في الإجابة، فإن الطبقة الدلالية لم تجعل النتيجة خاضعة للمساءلة بالقدر الكافي.
ويكشف التقييم المحدود أكثر مما يكشفه العرض العام. ابدأ بمخطط صغير يضم بضعة جداول للوقائع والأبعاد، وحقل تاريخ، ومقياساً واحداً مبهماً عن قصد على الأقل. أعدّ أسئلة ذات إجابات معروفة، بما في ذلك حالات تتطلب عملية ربط محددة، أو فترة تقارير معرّفة، أو تمييزاً بين مقاييس متشابهة. شغّل كل سؤال أولاً عبر مسار تقليدي لتحويل النص إلى SQL باستخدام المخطط والتوثيق العادي، ثم عبر مسار مستند إلى الأنطولوجيا. وحافظ على اتساق النموذج والبيانات والصلاحيات قدر الإمكان، حتى تقيس المقارنة طبقة السياق لا تغييرات أخرى لا علاقة لها بها.
سجّل أكثر من مجرد نجاح التنفيذ. لكل تشغيل، التقط SQL المُنشأة، والمفاهيم والعلاقات التي جرى استرجاعها، والمرشحات المطبّقة، والنتيجة النهائية. راجع ما إذا كان الاستعلام قد استخدم التعريف المقصود، وحافظ على مستوى التفاصيل الصحيح، وربط الكيانات المناسبة، وأجاب عن السؤال الذي قصده خبير المجال فعلاً. يصف مستودع NVIDIA فحصاً لقابلية الإجابة، ويعيد SQL وخطوات الوكيل مع إجابة؛ وينبغي أن تكون هذه العناصر جزءاً من التقييم، لا أن تُهمل بعد أن تعرض الواجهة النتيجة. (مستند README لـ Auto Ontology)
الاختبارات السلبية ضرورية. اطرح سؤالًا عن مصطلح ذي معنى ملتبس، أو احذف قيدًا زمنيًا ضروريًا، أو اطلب علاقة لا يدعمها المخطط. قد يكون السلوك المطلوب هو طلب توضيح أو الإشارة صراحةً إلى أن السؤال لا يمكن الإجابة عنه. فالرقم المصقول لا يُعد نجاحًا إذا اختار الوكيل جدولًا مناسبًا بصمت. وتعرض وثائق MCP كذلك check_answerable إلى جانب الإجابة عن الأسئلة، فيما تعيد أداة ask_question الإجابة وSQL والصفوف في حقول منفصلة، ما يجعل فحص هذا السلوك أسهل داخل بيئة اختبار للوكيل. (وثائق MCP)
وأخيرًا، صنّف حالات الفشل بدل اختزال النتيجة في رقم واحد للدقة: تعريف تجاري خاطئ، أو ربط غير صالح، أو مستوى تجميع غير صحيح، أو مرشح مفقود، أو ادعاء غير مدعوم، أو مجرد SQL غير فعّال. أعد التصحيحات التي راجعها المختصون إلى المسرد والعلاقات، ثم أعد تشغيل مجموعة الأسئلة ذات الإجابات المعروفة نفسها. ولا تُنشئ هذه الحلقة الراجعة قيمة فعلية إلا عندما يكون بالإمكان مراجعة كل تغيير في البيانات الوصفية وإسناده إلى مصدره. فإذا حسّن إرساء الأنطولوجيا الدقة الدلالية، وسلوك طلب التوضيح، وقابلية التتبع في الأسئلة التي تكون تعريفاتها صريحة، فقد استحق مكانًا في اختبارات لاحقة. لكنه لا يثبت، بمفرده، أن استعلامات المؤسسات العشوائية موثوقة.
ما يتطلبه تشغيله فعليًا
تقترب Auto Ontology من NVIDIA من منصة بيانات صغيرة أكثر من كونها حزمة يمكن إضافتها إلى وكيل قائم بأمر واحد. يصف المستودع عملية نشر تتألف من عدة خدمات: واجهة أمامية لواجهة الويب، وخلفية تكشف التطبيق وواجهة API، وخدمات استيعاب تتصل بمصادر بيانات المؤسسات وتبني الأنطولوجيا، إضافة إلى Postgres مع pgvector لحالة التطبيق والاسترجاع المدعوم بالمتجهات. وتتمثل المسارات الموثقة في Docker Compose لإعداد محلي أو على مضيف واحد، وKubernetes لنشر أكثر ملاءمة للتشغيل المؤسسي. وهذا التقسيم مهم لأن الاختبار لا يقتصر على معرفة ما إذا كانت الأنطولوجيا تنتج إجابة أفضل؛ بل يشمل أيضًا قدرة الفريق على إبقاء الخدمات وقواعد البيانات ونقاط نهاية النماذج وبيانات الاعتماد متوافقة ضمن نظام واحد.
وتُعد طبقة النماذج اعتمادًا صريحًا آخر. صُممت Auto Ontology للعمل مع نقاط نهاية NVIDIA NIM أو نقاط نهاية متوافقة للنماذج، ولا تقتصر إعداداتها على نموذج اللغة المستخدم لتفسير السؤال. كما تؤثر اختيارات التضمين وإعادة الترتيب في كيفية تحديد البيانات الوصفية والسياق المرشح قبل إنتاج الإجابة. وعمليًا، قد يتصرف تثبيتان يستخدمان مخطط المصدر نفسه بصورة مختلفة إذا اختلفت إعدادات النموذج أو التضمين أو إعادة الترتيب بينهما. لذلك ينبغي أن يسجل التقييم المفيد هذه الإعدادات إلى جانب الأسئلة والمخرجات. وإلا فقد يُنسب التغيير في الاسترجاع أو إعداد النموذج خطأً إلى تحسن في الأنطولوجيا نفسها.
أما جانب قاعدة البيانات فهو محدد بالقدر نفسه. صُمم المشروع للاتصال بقواعد بيانات مؤسسات مدعومة واستخدام بياناتها الوصفية مدخلًا، في حين يخدم Postgres وpgvector احتياجات التخزين والاسترجاع الخاصة بالتطبيق. وينشئ ذلك حدًا فاصلًا بين قواعد البيانات التي يجري وصفها والمخزن الذي تستخدمه Auto Ontology. وينبغي للتجربة أن ترسم هذا الحد قبل إدخال أي بيانات اعتماد: حدّد أنظمة المصدر التي ستُقرأ، والبيانات الوصفية أو معلومات النَّسَب التي ستُجمع، ومكان تخزين الأنطولوجيا الناتجة، والخدمة المسموح لها بالوصول إلى كل نقطة نهاية. فالبنية قابلة للإدارة، لكنها ليست تثبيتًا خفيفًا في ملف ثنائي واحد يمكن إسقاطه داخل بيئة تشغيل وكيل من دون قرارات تتعلق بالبنية التحتية.
وهناك طريقتان رئيسيتان لعرض السياق الناتج أمام الوكيل. يوفّر المشروع مسار API للتطبيقات التي تريد استدعاء خدماته مباشرة، كما تصف وثائق MCP خادم MCP يمكن استخدامه مع بيئة اختبار متوافقة مع MCP. يكون MCP مفيدًا عندما يعرف الوكيل مسبقًا كيفية اكتشاف الأدوات واستدعائها، بينما تمثل API نقطة التكامل المباشر لتطبيق مضبوط أو نص تقييم. وفي كلتا الحالتين، لا يستعلم الوكيل من قاعدة بيانات ثانية سحرية؛ بل يستدعي قدرات Auto Ontology الدلالية وقدرات الاسترجاع لديها، بحيث يمكن إدماج التعريفات التجارية والعلاقات والبيانات الوصفية ذات الصلة في سير عمل الطلب أو الاستعلام.
ينبغي أن يوجّه هذا التمييز الاختبار الأول. ابدأ بقاعدة بيانات صغيرة وغير حساسة، أو بمخطط يمثلها، وشغّل عملية النشر عبر Compose، ثم تحقّق من الواجهة الأمامية، والواجهة الخلفية، ومسار الإدخال، ومخزن PostgreSQL/pgvector، ونقطة نهاية النموذج كلٌّ على حدة قبل ربط أي وكيل. بعد ذلك، مرّر الأسئلة الثابتة نفسها عبر مسار API أو MCP، مع إبقاء النموذج والتضمين وإعادة الترتيب وإعداد المصدر دون تغيير. لا تكتفِ بفحص الإجابة النهائية بصياغتها النثرية؛ تحقّق أيضاً من صلاحية SQL المُولَّد، ومن استخدامه الجداول والتعريفات المقصودة، ومن مدى إتاحة النظام لمعلومات مصدر كافية لتفسير النتيجة. إن أجاب النشر عن سؤال تجريبي واحد بصورة صحيحة، فذلك لا يثبت بعد موثوقية التكامل بأكمله.
لذلك، تُعدّ الكلفة التشغيلية جزءاً من السؤال المتعلق بالمنتج. تحتاج الفرق إلى تنسيق الحاويات، وخدمة Postgres دائمة، وإمكانية الوصول إلى النماذج، ومسارات شبكة تصل إلى قواعد البيانات المصدر، وخطة للترقيات ومعالجة الأعطال عبر مكوّنات منفصلة. قد يجعل Kubernetes هذا الإعداد قابلاً للتكرار على نطاق المؤسسة، لكنه يزيد أهمية تحديد المسؤوليات وقابلية الرصد؛ في حين يمكن لـ Docker Compose اختصار تقييم محدود، مع إبقاء مسائل الإنتاج دون حسم. لا يتمثل الحد المنطقي للانتقال إلى ما بعد الاختبار في عمل الواجهة فحسب، بل في قدرة الفريق على إعادة إنتاج الإعداد، وتقييد الوصول، وتحديد المكوّن الذي أنتج الإجابة، وإزالة خدمة الأنطولوجيا أو استبدالها من دون ترك الوكيل أو الأنظمة المصدرية في حالة ملتبسة.
الترخيص وبيانات الاعتماد وأسباب التزام الحذر
يجعل ترخيص Apache-2.0 تقييم Auto Ontology من منظور الترخيص أمراً سهلاً نسبياً: إذ يمكن للفرق فحص المشروع وتشغيله وتعديله وإعادة توزيعه وفق شروط الترخيص. كما تنشر NVIDIA حاويات جاهزة وتحدد مكوّنات الجهات الخارجية بصورة منفصلة. وهذا مفيد للتقييم التقني، لكنه لا ينبغي أن يُفهم على أنه التزام كامل بدعم الإنتاج. يذكر المستودع أن فريق Auto Ontology يتولى صيانة الشيفرة ولا يقبل طلبات السحب الخارجية؛ أما طلبات التكامل وتقارير الأخطاء فتُعالج عبر المشكلات. عملياً، ينبغي للجهة المتبنية أن تفترض أن الإصلاحات المهمة وقرارات الإصدارات والتغييرات الحساسة أمنياً ستظل معتمدة على فريق الصيانة.
ويكتسب نموذج الملكية هذا أهمية لأن المشروع كبير بما يكفي ليتضمن عدة حدود تشغيلية: الواجهة الأمامية للويب وطبقة المصادقة، وواجهة FastAPI الخلفية وخدمات الإدخال، وPostgreSQL مع pgvector، ونقاط نهاية النماذج، وموصلات قواعد البيانات، وجسر MCP. كما تشير مشكلة عامة إلى أن الوثائق لا تزال تصف المستودع بأنه داخلي لدى NVIDIA، رغم أن المستودع عام. لا يُعدّ هذا التناقض بحد ذاته ثغرة، لكنه علامة على ضرورة مطابقة الوثائق مع الشيفرة وملفات نشر البنية والصور المُصدرة قبل التعامل مع دليل البدء السريع بوصفه إجراءً تشغيلياً موثوقاً. وينبغي أن يؤكد الفحص نفسه أي وسوم للصور، وقيم Helm، ومسارات API، ونقاط نهاية النماذج معتمدة للبيئة المقصودة.
أما التحذير الأهم فيتعلق بتخزين بيانات الاعتماد. تُخزَّن الاتصالات المضافة عبر الواجهة بطرق مختلفة بحسب تهيئة HashiCorp Vault. فمن دون Vault، يُحوَّل كائن الاتصال الكامل، بما في ذلك كلمة المرور، إلى صيغة تسلسلية ويُحفظ في صف من كتالوج PostgreSQL من دون تشفير. ويغيّر Vault هذا الترتيب عبر تخزين بيانات الاعتماد بصورة منفصلة وترك صف الكتالوج من دونها، لكن Vault اختياري، كما أن التهيئة الجزئية تعود إلى التخزين بنص واضح مع إصدار تحذير. وهذا يجعل الإعداد وسيلة تحكم معمارية، لا مجرد خيار ملائم. وقبل ربط مستودع بيانات إنتاجي، ينبغي لفرق الأمن التحقق من تهيئة Vault الفعلية، وفحص النسخ الاحتياطية لقاعدة البيانات والنسخ المتماثلة، وتقييد الوصول إلى الكتالوج، والتأكد من أن سجلات الاتصال لا يمكن قراءتها من قِبل أدوار لا تحتاج إليها.
تستحق حدود الخدمة الداخلية المستوى نفسه من الاهتمام. توضح وثائق المشروع أن المنافذ التي يستخدمها كلٌّ من الواجهة الخلفية المبنية على FastAPI وخدمة الاستيعاب يجب أن تبقى ضمن شبكة خاصة. تمرر الواجهة الأمامية هوية المستخدم إلى الواجهة الخلفية، في حين أن عمليات الاستيعاب مثل ingest وdelete وreset وcompile لا تملك مصادقة خاصة بها. لذلك، يتمثل المسار المقصود في استخدام تطبيق الويب الموثَّق أو بوابة واجهة API العامة، لا في كشف خدمات FastAPI تلك مباشرة. إن نشر المنافذ الداخلية خلف موازن تحميل، أو فتحها أمام شبكة عنقود واسعة، أو افتراض أن عميل MCP يوفر التفويض المفقود، سيقوّض الحد الفاصل الذي يعتمد عليه نموذج النشر.
تضيف اختيارات النماذج والخدمات المستضافة سؤالًا آخر يتعلق بحوكمة البيانات. يستخدم الإعداد الافتراضي نقاط نهاية نماذج مستضافة لدى NVIDIA، بينما يمكن إعداد NIM مستضاف ذاتيًا أو نقاط نهاية متوافقة بحسب الدور. ويمكن أيضًا توجيه الأسئلة التنبؤية إلى KumoRFM عند تفعيله؛ إذ توضح الوثائق أن الجداول المتصلة قد تُرفع إلى تلك الخدمة المستضافة، وفق حدود إعداداتها وشروطها. لذلك ينبغي أن يسجل التقييم مكان انتقال بيانات مخطط القاعدة الوصفية، والقيم المأخوذة عينياً، والمطالبات، وSQL المُولَّد، ونتائج الاستعلامات. إن وصف «مفتوح المصدر» ينطبق على شفرة Auto Ontology، لكنه لا يجعل تلقائيًا مزود النموذج المُعدّ أو الموصل أو قاعدة البيانات أو خدمة التنبؤ المستضافة جزءًا من حدود الثقة نفسها.
يتمثل مسار تبنٍّ معقول في تنفيذ تجربة محدودة ببيانات اصطناعية أو غير حساسة، مع سياسات شبكة تُبقي الخدمات الداخلية خاصة، وتفعيل Vault قبل إضافة بيانات الاعتماد التي تُدار عبر الواجهة، واختيار نقاط نهاية النماذج عن قصد. اختبروا المصادقة وسلوك الأدوار عبر مسارات API وMCP نفسها التي سيستخدمها الوكلاء. واحتفظوا بتصدير معروف الصلاحية للأنطولوجيا، وإعداد الوصول إلى قاعدة البيانات، وإصدار النشر، حتى يتمكن الفريق من تعطيل التجميع أو التراجع دون فقدان الحالة المرجعية. بعد ذلك، اطلبوا مراجعة أمنية مستقلة قبل الاستخدام الإنتاجي، تشمل فحص الأسرار، والسجلات، والنسخ الاحتياطية، وحركة المرور الصادرة، ومصدر التبعيات، والأذونات على كل مصدر متصل.
الخلاصة العملية أضيق من القول إن «Auto Ontology جاهز» أو إن «Auto Ontology غير آمن». فهو جاهز للاختبار بوصفه طبقة للبيانات الوصفية وسياق الوكلاء، بشرط أن تتعامل التجربة مع النشر ومعالجة البيانات باعتبارهما جزءًا من المنتج، لا مجرد تفاصيل إعداد. يخفض ترخيص Apache-2.0 عتبة الفحص، لكن تخزين اتصالات قواعد البيانات بنص واضح من دون Vault، ونقاط نهاية الخدمات الداخلية غير الموثَّقة، وحدود النماذج المستضافة، والتغييرات التي يتحكم فيها المشرفون، كلها تثير أسئلة لا يستطيع العرض التجريبي الإجابة عنها. والدليل المناسب هو نشر صغير قابل للعكس، تُثبت فيه ضوابط الأمان وسلوك الاستعلامات وإجراء التراجع قبل السماح للأنطولوجيا بالوقوف أمام بيانات المؤسسة الحساسة.
Related articles
OpenShell من NVIDIA يضع صلاحيات الوكلاء تحت تحكم السياسات — ما الذي أصبح جاهزًا للاختبار
OpenShell بيئة تشغيل مرخّصة بموجب Apache تضع وكلاء البرمجة والوكلاء المستقلين داخل مساحات معزولة تتحكم فيها السياسات، فتقيّد الملفات والعمليات والشبكات وبيانات الاعتماد وتغييرات السياسة.
Mistral Large 4 مفتوح الأوزان. والاختبار الحقيقي هو: هل يمكنك تشغيله؟
أطلقت Mistral أوزان نموذجها متعدد الوسائط ذي التريليون معامل. وينقل ذلك النقاش من الوصول عبر واجهة API إلى العتاد وبرمجيات التشغيل والترخيص، وإلى مدى فائدة النشر المحلي لفريقك.
اللحظة الفيروسية لـMicroduck تحوّل روبوتًا ثنائي الساقين بسعر 399 دولارًا إلى اختبار لتعلّم الروبوتات المتاح
روبوت Microduck من Pollen Robotics صغير ومنخفض التكلفة بمعايير الروبوتات، وبرمجياته مفتوحة. لكن موجة الطلبات المسبقة بعد كلمة NVIDIA في برلين تطرح سؤالًا أهم من مدى لطافته: هل يمكن لروبوت رخيص أن يصبح منصة عملية لتعلّم الذكاء الاصطناعي الفيزيائي؟
محاور المنزل الذكي بالذكاء الاصطناعي المحلي في IFA 2026: ما الذي تستبدله، وما الذي لا تستبدله، ومن الأفضل أن ينتظر؟
تضع IFA 2026 الذكاء الاصطناعي المحلي في قلب سباق المنزل الذكي. يشرح هذا الدليل ما يمكن أن تستبدله المحاور الجديدة فعلاً، ومخاطر الشراء المبكر، وكيف تختبر توافقها مع الأجهزة الموجودة لديك.
Comments
Sign in to comment.
No comments yet.